[논문리뷰] Qwen-Planner-Agent: A Closed-Loop AI-for-AI Framework for Real-World Mobile Planner Agents
링크: 논문 PDF로 바로 열기
저자: Tingyu Qu, Weigao Sun, Yuecheng Liu, Yucheng Zhao, Yi Zhu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- AI-for-AI Framework: AI가 자신의 개발 및 개선 과정에 적극적으로 참여하여 실행 피드백을 활용하는 closed-loop 시스템을 의미합니다.
- Qwen-Planner-Agent: 본 논문에서 제시하는 mobile planning 작업을 위한 완전한 에이전트 시스템으로, 학습된 Planner Model과 통합된 Harness를 결합합니다.
- Harness: Planner Model을 외부 실행기(executors)에 연결하고, 도구(Tools), 기술(Skills), 영구 메모리(persistent Memory) 및 런타임 제약(runtime constraints)으로부터 활성 컨텍스트를 구성하며, 구조화된 피드백을 전달하는 런타임 구성 요소입니다.
- Competence-Aware Reward-and-Advantage Engineering (CARE): 에이전트의 능력(competence)에 따라 보상 구성(reward composition)과 이점 스케일링(advantage scaling)을 조정하여 신뢰할 수 있는 작업 완료 및 효율적인 실행을 촉진하는 reinforcement learning 기법입니다.
- Model–Harness Co-evolution: 모델 업데이트와 Harness 적응이 상호 연결되어, 각 구성 요소가 다른 구성 요소가 최적화되는 조건을 변화시키는 반복적인 피드백 루프를 의미합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 AI가 수동적인 콘텐츠 생성에서 벗어나 차세대 AI 시스템 구축에 능동적으로 참여하는 AI-for-AI 패러다임으로 확장하는 근본적인 문제를 다룹니다. 특히, 모바일 플래너 에이전트(mobile planner agents)의 개발은 복잡하고 long-horizon인 작업에서 애플리케이션 간의 조치 조정, 컨텍스트 유지, 오류 복구, 그리고 결과 검증 등의 어려운 과제를 안고 있습니다. 기존 연구들은 다양한 상호작용 데이터, 효과적인 정책 학습, 그리고 변화하는 작업 및 자원에 대한 런타임 지원을 제공하는 데 한계가 있으며, 특히 실제 장치(real-device)와의 상호작용은 비용이 많이 들고 확장성이 제한된다는 단점이 있습니다. 이러한 문제점들은 AI 시스템의 개발을 위한 확장 가능하고 피드백 중심적인 개발 수명 주기의 필요성을 강조합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Qwen-Planner-Agent 개발을 위한 closed-loop AI-for-AI framework를 제안하며, 이는 데이터 생산, 모델 훈련 및 배포를 공유된 action-feedback-verification contract를 통해 체계적으로 연결합니다. 이 프레임워크는 세 가지 주요 단계로 구성됩니다: AI for Data는 에이전트가 작업을 구성하고, 상호작용 궤적을 수집하며, 훈련 데이터를 큐레이션하고, 훈련 피드백을 사용하여 데이터 생성을 안내합니다 [Figure 3]. AI for Training은 planning-oriented cold start와 hybrid-environment online agentic reinforcement learning을 결합하며, 여기서 Competence-Aware Reward-and-Advantage Engineering (CARE)을 도입하여 작업 성능을 유지하면서 추론 및 tool-use cost를 절감합니다 [Figure 4]. 마지막으로 AI for Harness는 execution-evidence-driven loop를 통해 메모리, 스킬, 도구를 런타임에 조율하고, 구조화된 액션 피드백과 실패 추적 정보를 모델 및 Harness 적응에 활용하여 Model–Harness Co-evolution을 추진합니다 [Figure 2, Figure 5].
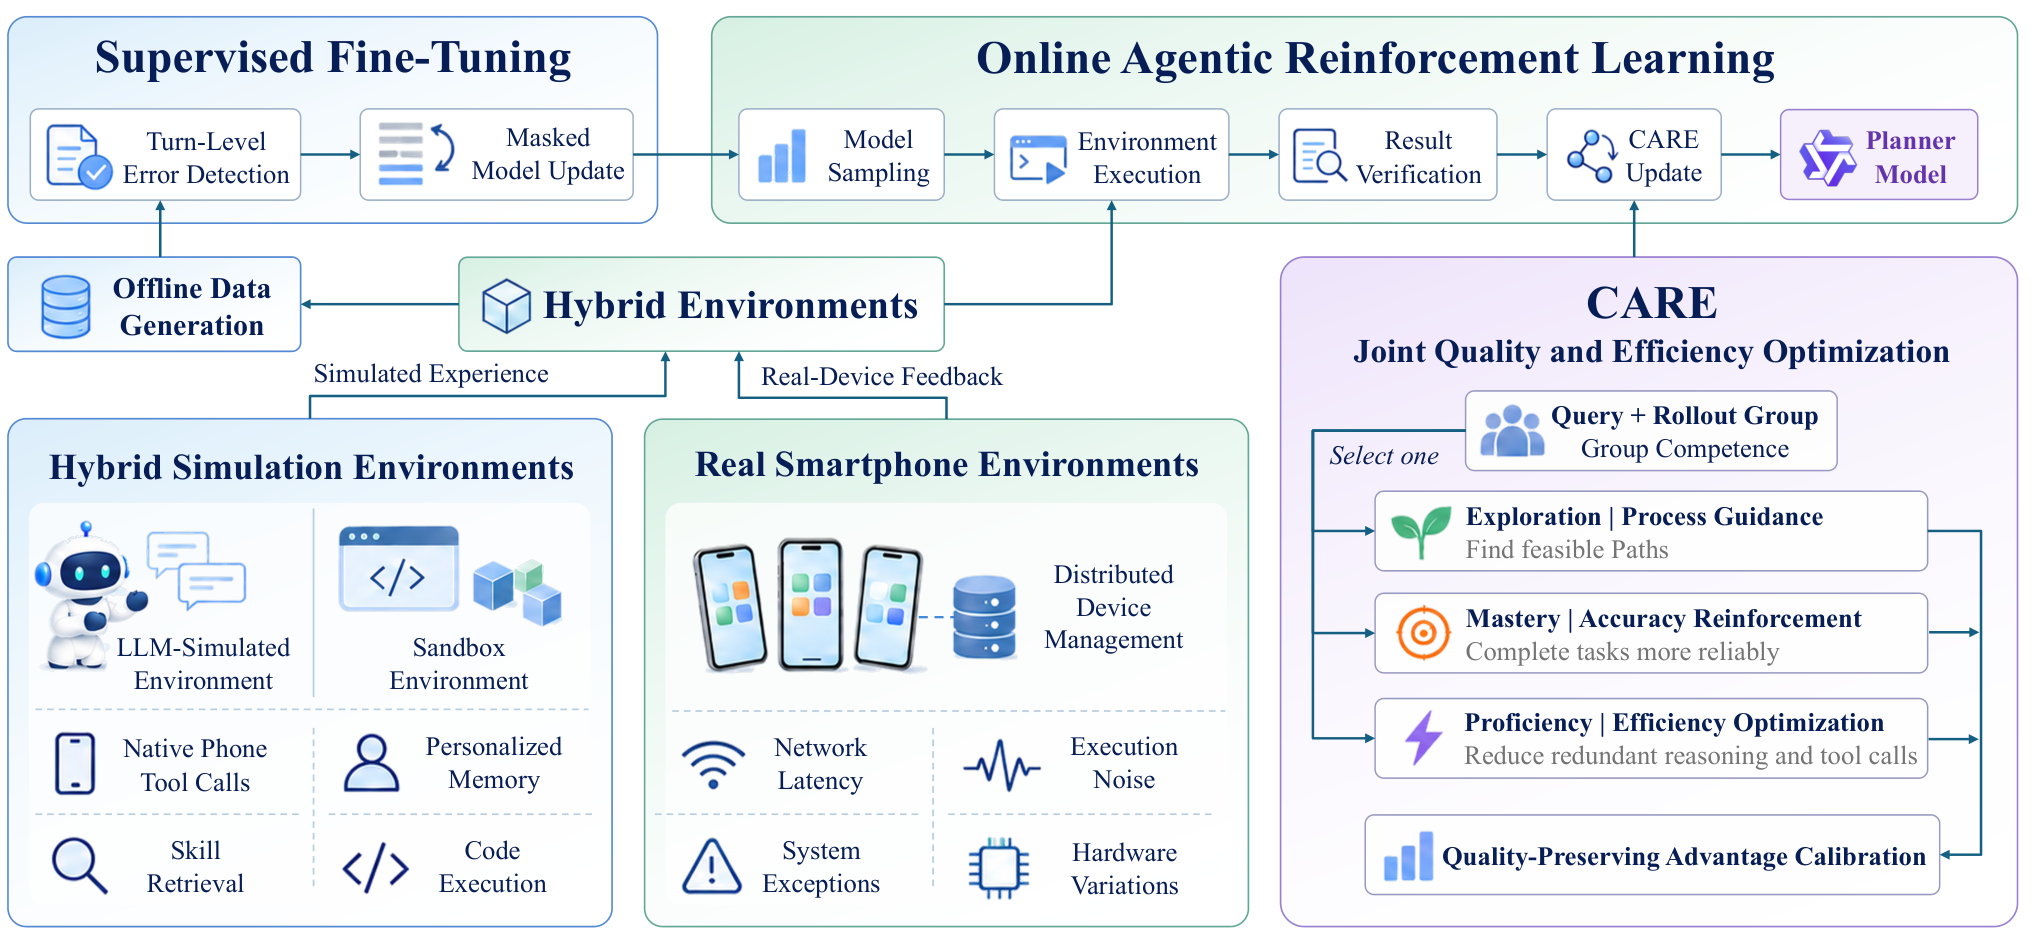
Figure 4 — 플래너 모델 훈련 프레임워크
Qwen-Planner-Agent 27B는 MobilePA-Bench에서 77.05%의 Overall score를 달성하여 평가된 모든 모델 및 에이전트 시스템 중 최고 성능을 기록했으며, GPT 6 Astra (76.84%) 및 Claude Opus 5 (75.71%)를 능가했습니다 [Figure 1]. 개별 능력 측면에서 Tool Use에서 77.79%, Memory에서 74.76%, Skills에서 86.25%의 높은 점수를 보였습니다. 또한, Qwen-Planner-Agent는 1,000 tasks당 $2.41로 가장 낮은 예측 출력 비용을 기록하여, 뛰어난 성능-비용 균형을 입증했습니다 [Figure 1]. Ablation studies 결과, Harness 지원은 27B checkpoint의 Overall score를 71.90%에서 77.05%로 향상시키는 데 기여했음이 확인되었습니다. 나아가 Model–Harness Co-evolution은 MobilePA-Internal에서 5.83 percentage points, MCPMark에서 8.98 percentage points의 Overall performance 향상을 가져왔습니다 [Table 2].
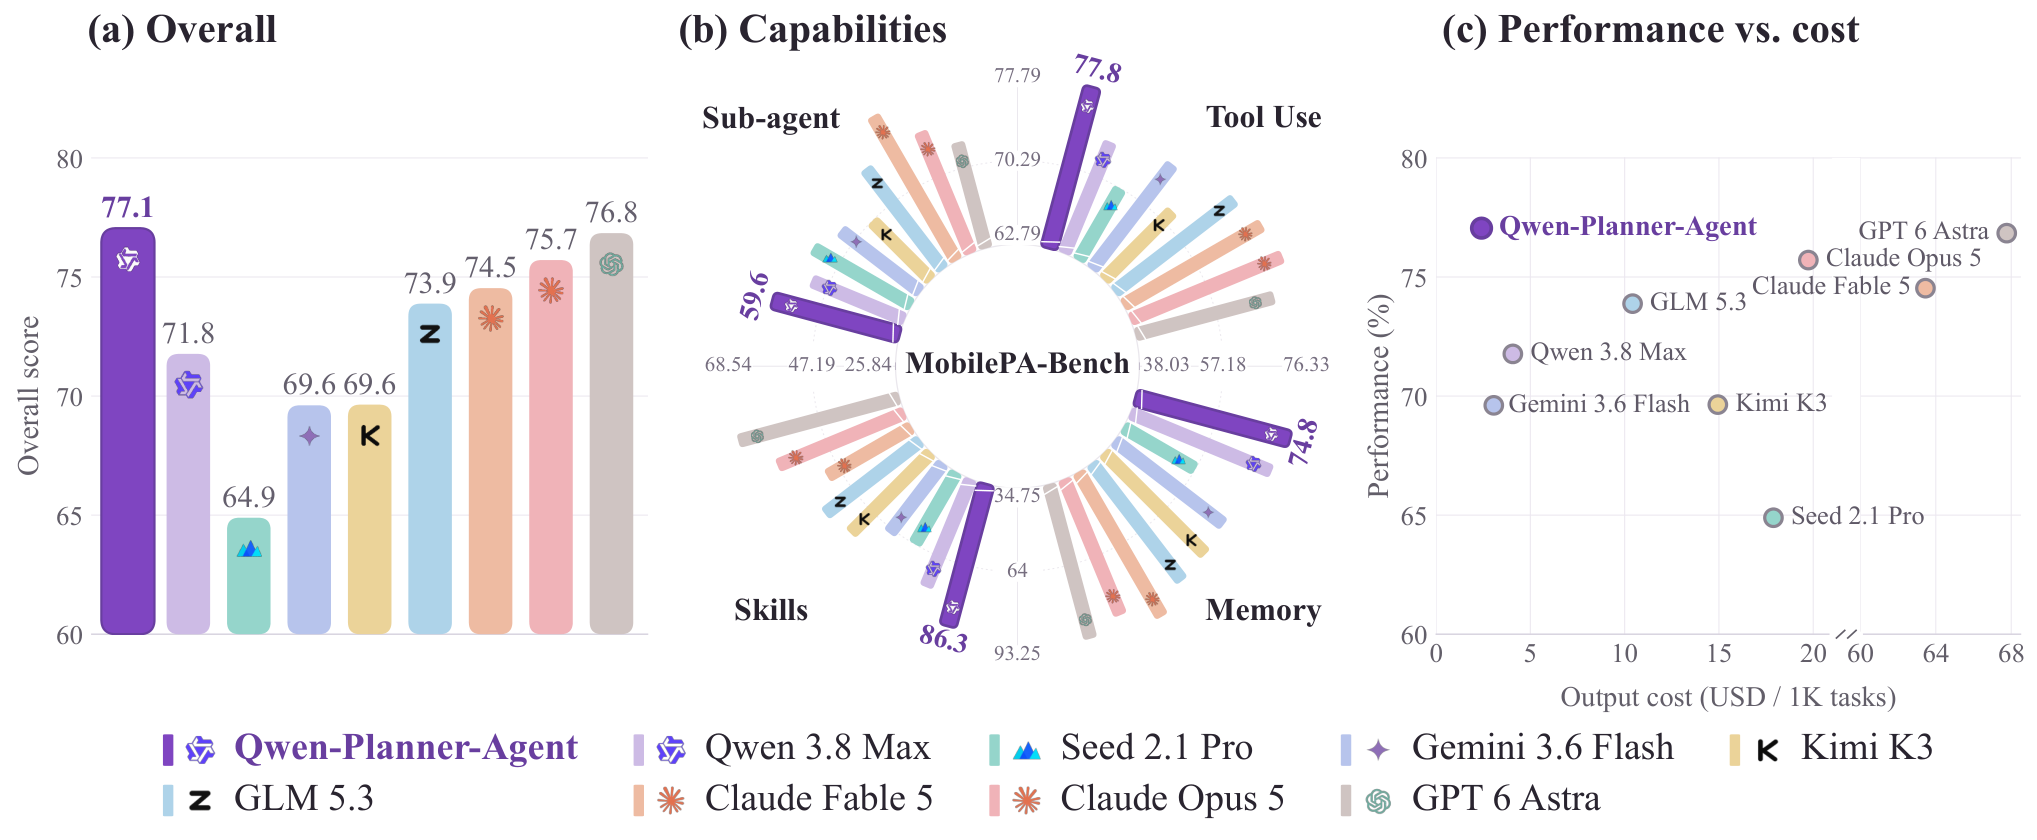
Figure 1 — 전반적 성능 및 비용
4. Conclusion & Impact (결론 및 시사점)
본 연구는 Qwen-Planner-Agent를 closed-loop feedback-driven AI-for-AI framework를 통해 개발된 통합 Planner Model–Harness agentic system으로 성공적으로 제시합니다. 이 시스템은 실행 경험을 활용하여 데이터 생산, 훈련 및 배포 과정에서 AI 기반의 개선을 이끌어냅니다. Qwen-Planner-Agent는 MobilePA-Bench에서 가장 높은 Overall score를 달성하면서 낮은 예측 출력 비용을 보였으며, Qwen-Planner-Model은 대부분의 비모바일 agentic benchmarks에서 성능을 향상시키고 일반적인 능력을 크게 유지했습니다. 다중 라운드 실험(multi-round experiments)은 평가된 환경 내에서 모델 훈련과 Harness 개선을 교대로 수행하는 방식의 효과를 추가적으로 뒷받침합니다. 이러한 결과들은 AI가 더욱 유능한 에이전트를 개발하는 데 기여할 수 있는 구체적인 실제 사례를 제공하며, 학계 및 산업계에서 확장 가능하고 피드백 기반의 AI 개발에 중요한 시사점을 던집니다. 향후 연구는 데이터 정제, 훈련 적응 및 Harness 업데이트에서 수동 개입을 줄여 에이전트 능력의 보다 확장 가능하고 효율적인 반복을 가능하게 하는 데 초점을 맞출 것입니다.
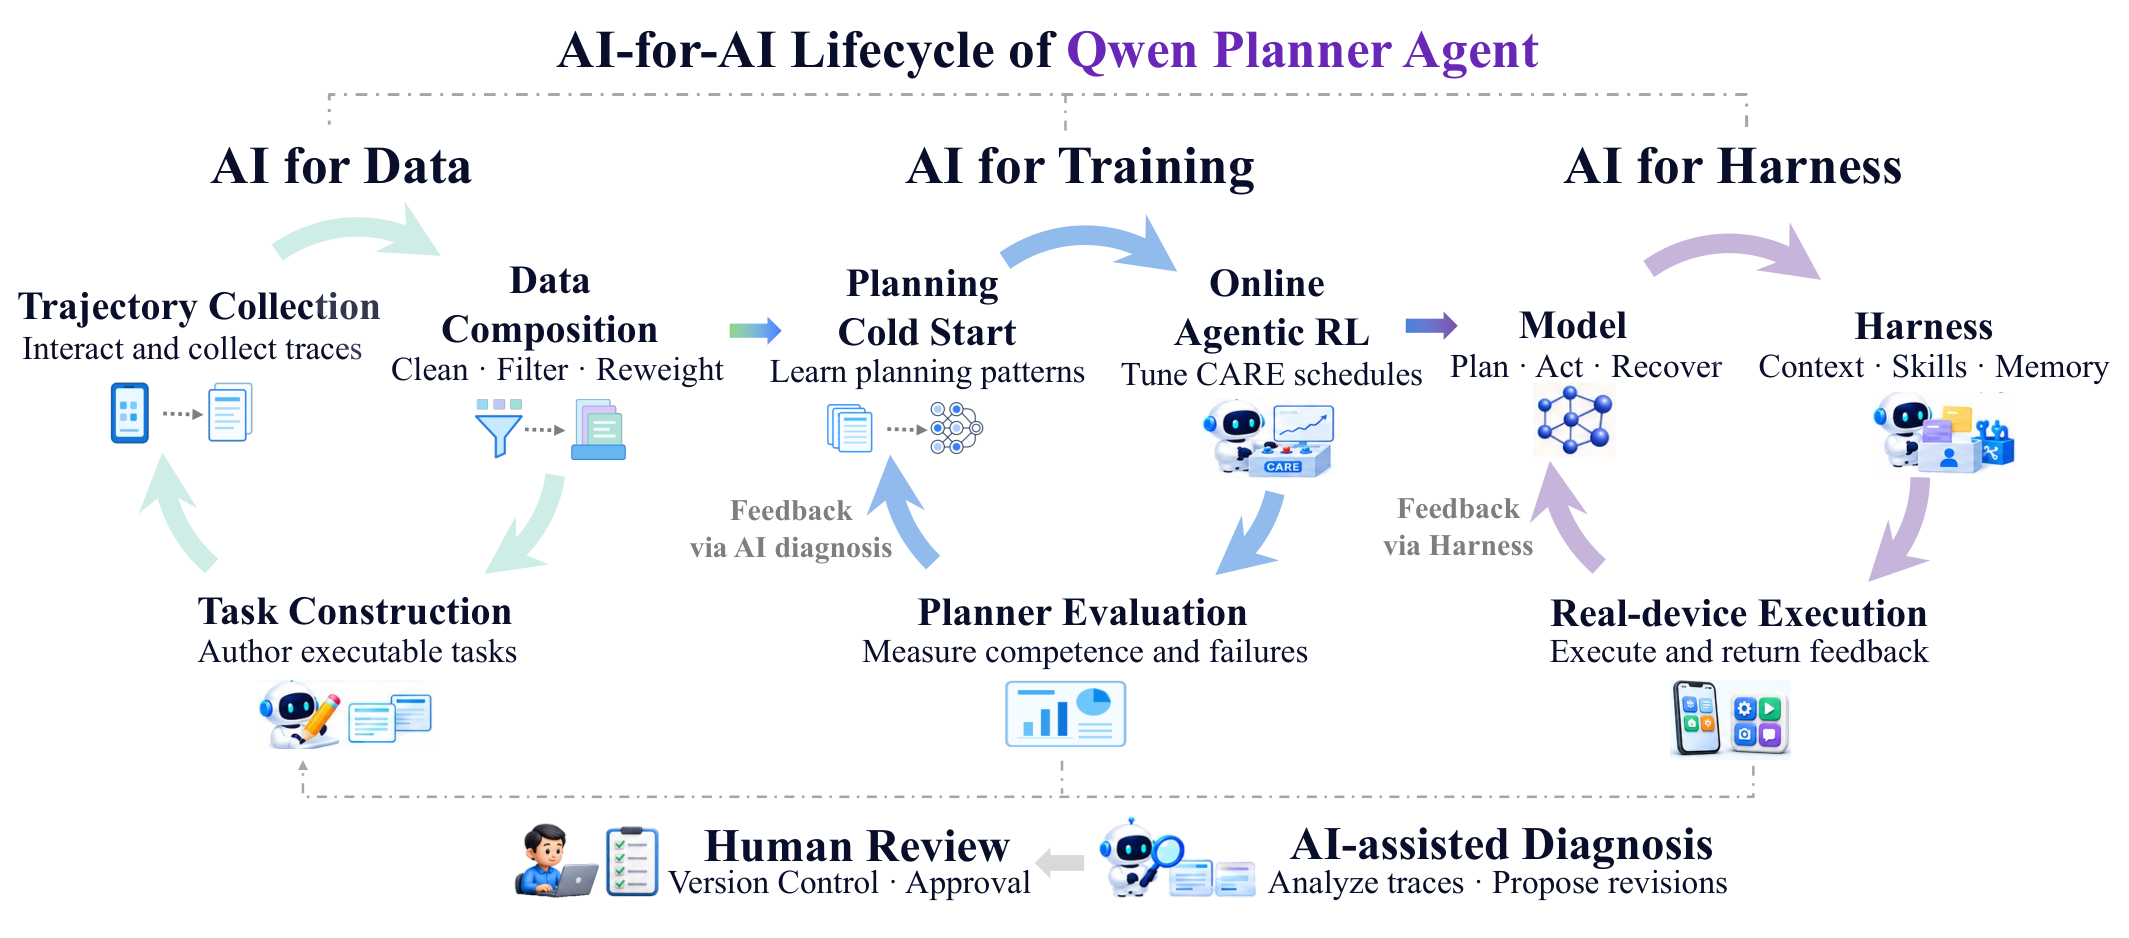
Figure 2 — AI-for-AI 생명주기
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] RetireOPD: Self-Retiring On-Policy Distillation for Agentic Reinforcement Learning
- [논문리뷰] InternReviewer & InternAdvocate: Objective Reward and Evaluation for Agentic Reinforcement Learning in Peer Review and Rebuttal
- [논문리뷰] Agent-G^2: Gaussian Guidance for Agentic Reinforcement Learning
- [논문리뷰] MobilePA-Bench: Benchmarking Mobile Planner Agents on Complex Real-World Tasks
- [논문리뷰] EnvACE: Internalizing Environment Dynamics via World Rehearsal for Agentic Reinforcement Learning
Review 의 다른글
- 이전글 [논문리뷰] Parts-of-Speech as Emergent Categories in SAE Latent Space
- 현재글 : [논문리뷰] Qwen-Planner-Agent: A Closed-Loop AI-for-AI Framework for Real-World Mobile Planner Agents
- 다음글 [논문리뷰] Rate-distortion optimization for full-reference image quality metrics via stochastic Hessian estimates
댓글