[논문리뷰] Block Sparse Attention with Log-Linear Complexity
링크: 논문 PDF로 바로 열기
저자: Bohao Tang, Zhen Qin, Yuqi Pan, Zheng Li, Pengfei Liu
1. Key Terms & Definitions
- PISA (Pyramid Sparse Attention): 본 논문에서 제안하는 블록 희소 어텐션(Block Sparse Attention) 메커니즘으로, 계층적 Top-K 블록 선택 전략을 통해 시퀀스 길이에 대한 로그 선형(Log-Linear) 복잡도를 달성합니다.
- LogSumExp (LSE): PISA에서 각 계층의 후보 블록에 대한 스코어링에 사용되는 함수로, 원본 키(Original Keys)의 점수를 직접 계산하여 다음 단계의 후보를 선택하는 데 활용됩니다.
- Triton Kernels: PISA의 효율적인 실행을 위해 개발된 하드웨어-인지(Hardware-aware) 커널로, 계층적 라우팅(Hierarchical Routing)과 LSE 스코어링을 융합하여 쿼리-키 스코어 행렬(Query-Key Score Matrix)을 구체화하지 않고도 높은 성능을 제공합니다.
- Block Sparse Attention (BSA): 키 시퀀스를 연속적인 블록으로 분할하고, 각 쿼리(Query)에 대해 이 블록들 중 일부를 선택하여 어텐션(Attention)을 계산하는 방법입니다. 기존 방식은 Top-K 블록 선택 단계에서 이차(Quadratic) 복잡도를 가집니다.
- Log-Linear Complexity: 시퀀스 길이(N)에 대해 O(N log N)의 계산 복잡도를 의미하며, PISA가 목표로 하고 달성하는 효율성 수준입니다.
2. Motivation & Problem Statement
대규모 언어 모델(Large Language Models, LLMs)을 더 긴 컨텍스트(Context)로 확장하는 것은 Full Self-Attention의 계산 복잡도가 시퀀스 길이에 대해 quadratic하게 증가하여 막대한 비용을 초래한다는 근본적인 문제에 직면해 있습니다. 기존의 Block Sparse Attention (BSA)은 어텐션 계산 비용을 줄이는 효율적인 대안을 제공하지만, 가장 관련성이 높은 블록을 선택하는 Top-K block selection 단계 자체가 모든 쿼리-블록 쌍을 스코어링해야 하므로 시퀀스 길이에 대해 여전히 O(N^2/C)의 quadratic 복잡도를 가집니다. 이 선택 단계가 전체 시퀀스에 걸쳐 주요 계산 병목 현상으로 작용하여, 블록 희소 어텐션의 전체적인 효율성을 저해합니다. 이러한 한계를 극복하고 긴 컨텍스트 모델링을 위한 블록 희소 어텐션의 Log-Linear Complexity를 달성하기 위해 새로운 접근 방식이 필요합니다.
3. Method & Key Results
본 논문은 Top-K block selection의 계산 병목을 해결하기 위해 Pyramid Sparse Attention (PISA)을 제안합니다. PISA는 풀링(Pooling)을 통해 키 블록의 Fine-to-Coarse 계층 구조를 구축하며, 가장 Coarse한 레벨부터 선택을 시작합니다. 각 레벨에서 제한된 후보 블록 세트에 대해 LogSumExp (LSE) 스코어링을 적용하여 Top-K 후보를 선택하고, 이들을 다음 Finer 레벨의 하위 블록으로 확장하여 최종 Fine 레벨에 도달할 때까지 이 과정을 반복합니다. 이를 통해 각 쿼리는 각 레벨에서 소수의 유망한 블록만 평가하게 되어, 모든 Fine-grained 블록을 exhaustively 비교하는 것을 피합니다.
PISA는 O(log N) 레벨의 키를 구축하며, 이는 전체 시퀀스에 걸쳐 O(N log N)의 블록 선택 복잡도를 달성합니다. 효율적인 하드웨어 실행을 위해, 계층적 라우팅(Hierarchical Routing)과 LSE 스코어링을 융합한 하드웨어-인지 Triton kernels을 개발하여, 쿼리-키 스코어 행렬을 구체화하지 않고 중간 결과를 직접 확장 및 필터링합니다. 이는 메모리 트래픽과 중간 텐서 오버헤드를 줄입니다.
실험 결과, PISA는 기존 BSA 대비 긴 시퀀스 길이에서 향상된 효율성을 입증했습니다. Figure 3에 따르면, PISA는 64K 시퀀스 길이에서 2.86x, 128K에서 5.31x, 256K에서 9.95x의 블록 선택 레이턴시(Latency) 속도 향상을 달성했습니다. 언어 모델링(Language Modeling) 및 상식 추론(Commonsense Reasoning) 벤치마크에서는 기존 Sparse Attention 베이스라인과 유사한 성능을 보였으며, 특히 리트리벌(Retrieval) 태스크에서는 더 나은 결과를 제공했습니다. Table 2에서 PISA는 2.67B 모델 스케일에서 평균 52.14%의 Containment Accuracy를 기록하며 다른 Sparse Attention 방법론 중 가장 높은 정확도를 달성했습니다. Figure 2는 PISA가 Recall@8 및 Attention mass ratio 측면에서 가장 높은 성능을 보여, LSE 기반 스코어링이 더 정확한 Top-K selection을 가능하게 함을 시사합니다.
4. Conclusion & Impact
본 논문은 계층적 Top-K selection과 LogSumExp (LSE) 스코어링을 결합한 블록 희소 어텐션 방법인 PISA를 도입했습니다. PISA는 제한된 후보 세트를 각 레벨에서 스코어링함으로써 O(N log N)의 Log-Linear적인 Prefill 복잡도를 달성합니다. 특히, 중간 선택 레벨을 융합하고 쿼리 간 Leaf-Key 블록을 재사용하는 하드웨어-인지 Triton kernels 구현을 통해 효율성을 극대화했습니다. 다양한 모델 스케일에서의 실험 결과는 PISA가 언어 모델링 및 상식 추론 태스크에서 기존 Sparse Attention 베이스라인과 유사한 성능을 유지하면서, 특히 긴 시퀀스 길이에서 더 높은 평균 Containment Accuracy와 더 낮은 블록 선택 레이턴시(Latency)를 제공함을 보여줍니다. 이러한 결과는 PISA가 긴 컨텍스트 처리를 위한 효율적이고 효과적인 솔루션임을 시사하며, 미래 대규모 언어 모델의 컨텍스트 길이 확장에 중요한 기여를 할 것으로 기대됩니다.
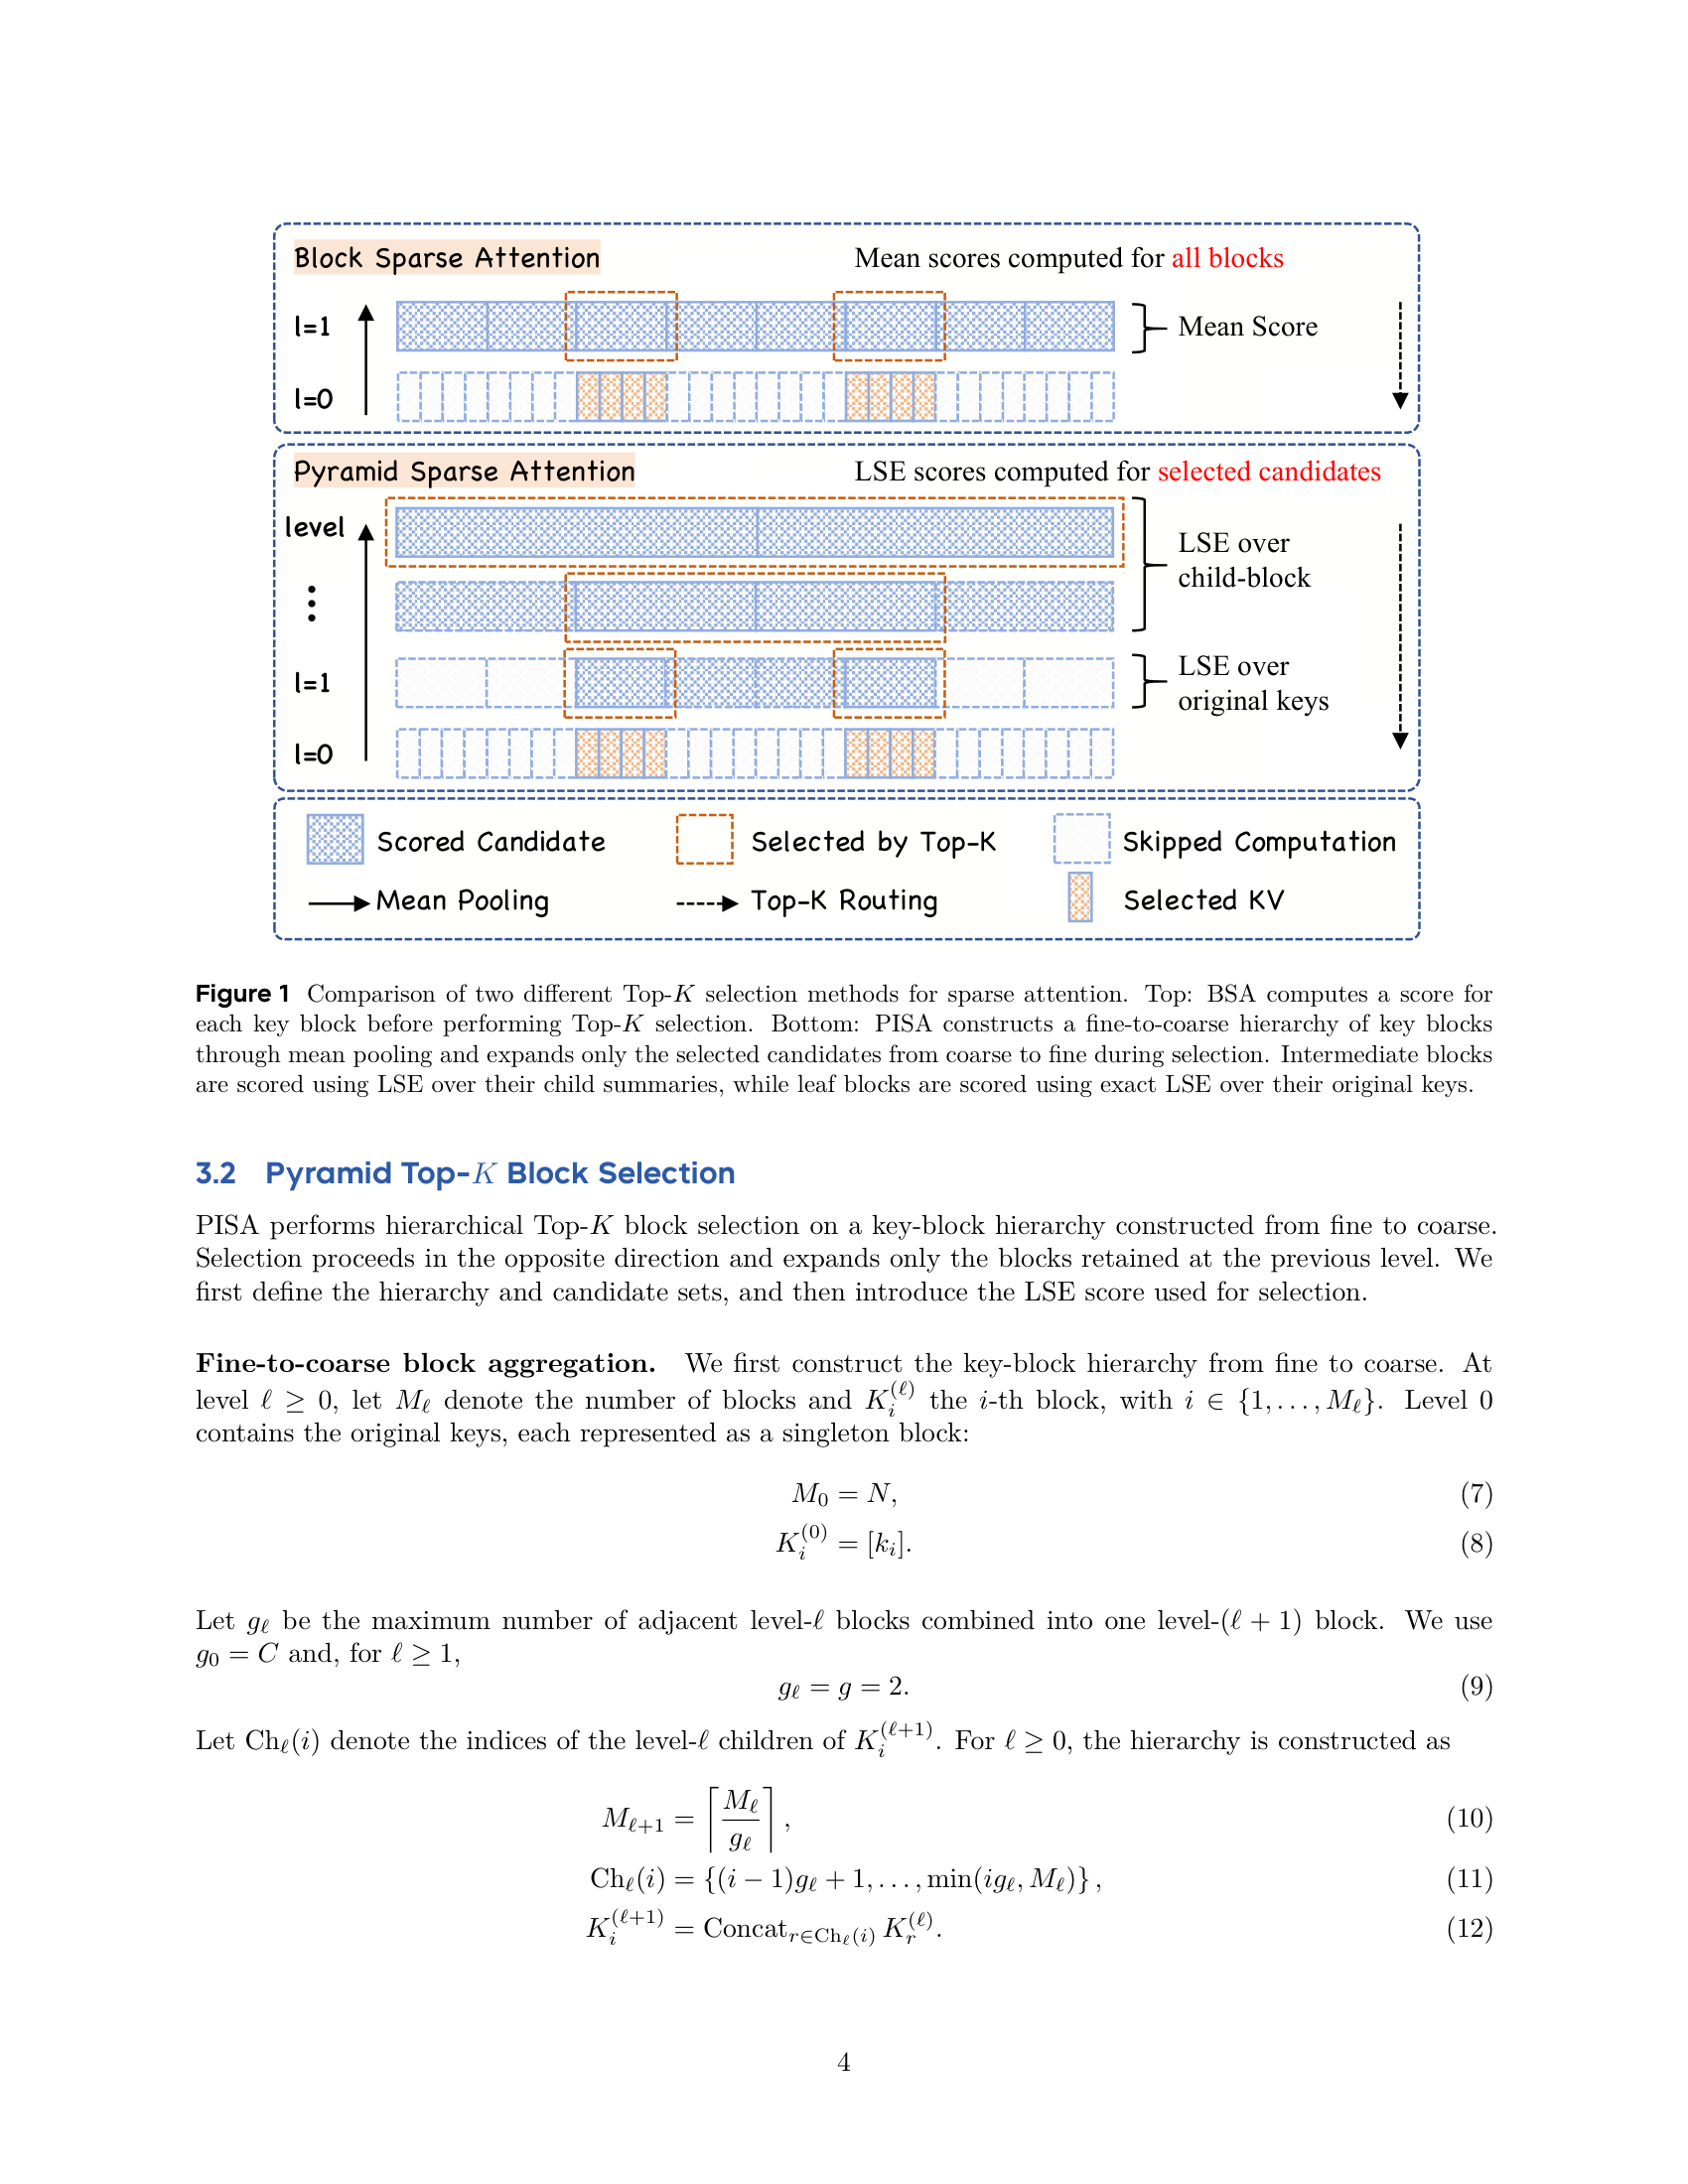
Figure 1 — PISA의 핵심 방법론인 계층적 블록 선택 방식을 기존 BSA와 시각적으로 비교하여 이해를 돕는 핵심 다이어그램
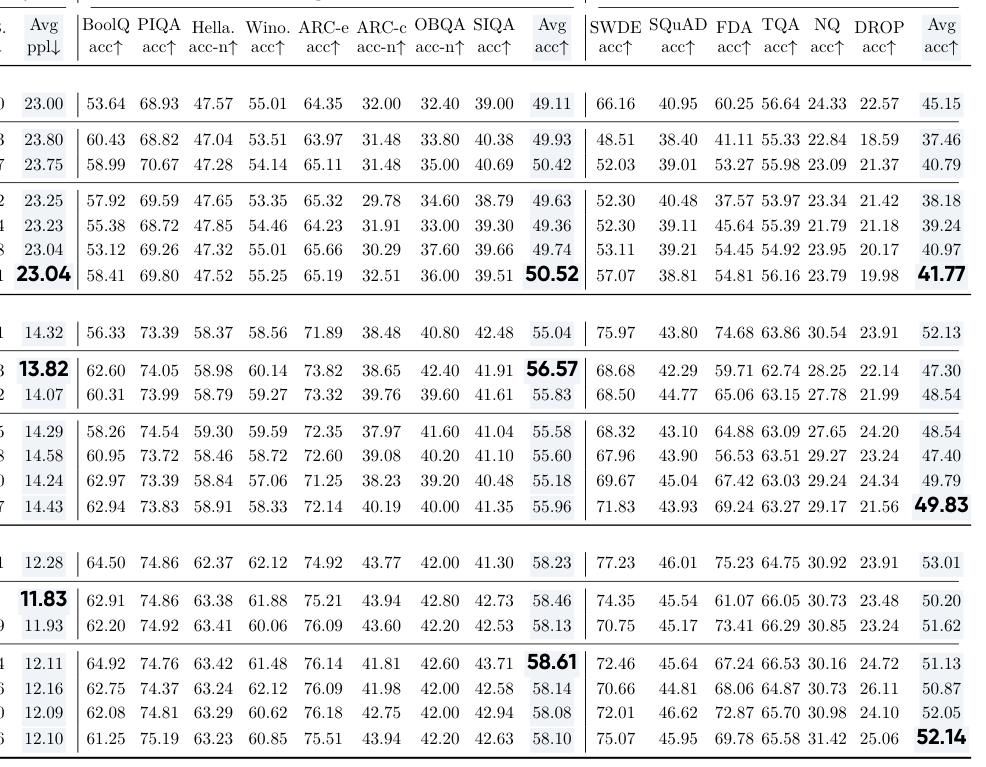
Table 2 — PISA의 언어 모델링 perplexity, multiple-choice accuracy, containment accuracy 등 주요 정량적 성능 지표를 다양한 모델 스케일에서 타 방법론과 비교한 핵심 결과 테이블
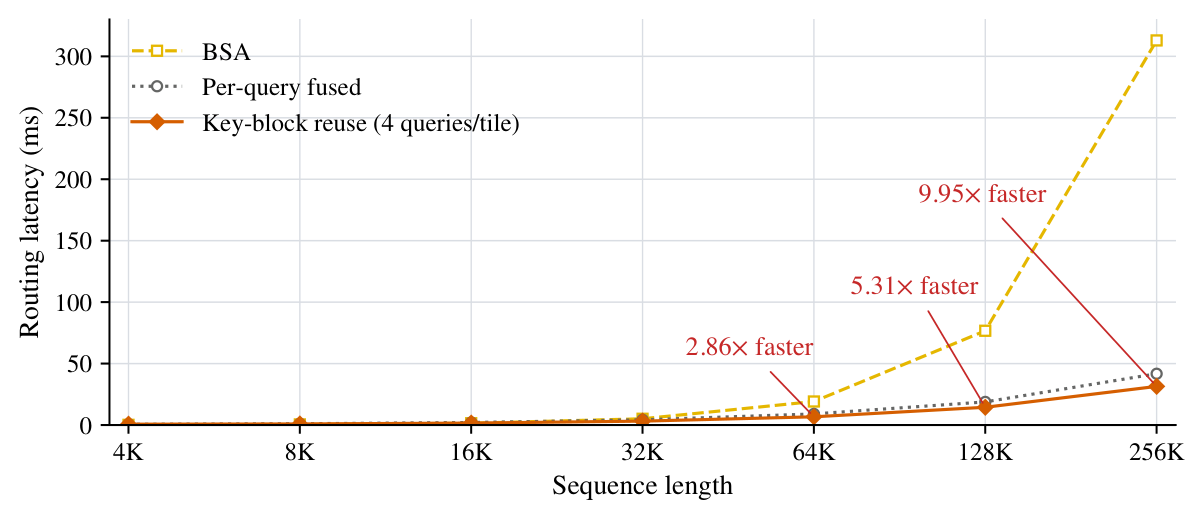
Figure 3 — PISA가 긴 시퀀스 길이에서 기존 BSA 대비 블록 선택 레이턴시를 얼마나 감소시키는지를 보여주는 핵심 효율성 그래프
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] CRISP: Cliff-awaRe Input-adaptive Sparse Prefilling with Structural-Mass-Motivated Routing
- [논문리뷰] RIBOSPAN: A Long-Context RNA Foundation Model for Versatile RNA Modeling
- [논문리뷰] FlashPrefill V2: Block-Sparse Prefill Attention for Long-Context LLM Serving
- [논문리뷰] EDITBRIDGE: Towards Faithful and Efficient Ultra-High-Resolution Image Editing
- [논문리뷰] Alaya-EVOKE: From Linear-Scaling Supervision to Endless World
Review 의 다른글
- 이전글 [논문리뷰] AgentWorld: Benchmarking Long-Horizon Collaboration of Multi-agent LLMs
- 현재글 : [논문리뷰] Block Sparse Attention with Log-Linear Complexity
- 다음글 [논문리뷰] BoundInk: Boundary-Aware Online Handwriting Generation
댓글