[논문리뷰] SpatialSpeak: QA-Native Reconstruction with Local and Global Context for Spatial Chain-of-Thought Reasoning
링크: 논문 PDF로 바로 열기
저자: Yang Cao, Jiaxin Zhang, Dave Zhenyu Chen, et al.
1. Key Terms & Definitions
본 논문에서 다루는 핵심 용어 및 정의는 다음과 같습니다:
- VLM (Vision-Language Model): Multi-modal inputs, 특히 visual input과 linguistic input을 함께 처리하여 다양한 tasks를 수행하는 models입니다.
- Spatial Chain-of-Thought (CoT): Spatial reasoning tasks에서 model이 final answer를 도출하기 위한 intermediate geometric estimates와 reasoning steps를 명시적으로 표현하도록 감독하는 기법입니다.
- QA-Native Reconstruction Pretraining (QA-RP): Vision-Language Model을 multi-view 3D reconstruction task에 pretrain시키는 단계로, local point queries와 global object-center queries를 text-based QA format으로 재구성하여 standard autoregressive output interface를 통해 geometry를 학습합니다.
- Chain-of-Thought with Visual Compensation (CoT-VC): Spatial CoT learning 단계에 reliability assessment와 answer refinement mechanism을 추가한 것으로, geometry-derived answer의 신뢰도를 평가하고 필요한 경우 direct visual evidence를 활용하여 answer를 수정하도록 model을 훈련합니다.
- Local Reconstruction Task: Multi-view images 내에서 marked image point의 fine-grained 3D coordinates를 예측하는 task로, VLM에게 local geometry에 대한 explicit한 3D grounding을 제공합니다.
- Global Reconstruction Context: 모든 visible object instances의 semantic categories와 3D centers를 shared coordinate system에서 enumerating하고 predicting하는 task로, scene 전반의 global spatial arrangement 정보를 제공합니다.
2. Motivation & Problem Statement
기존 Vision-Language Models (VLMs)은 multi-view spatial reasoning을 위해 pre-trained reconstruction models의 geometric priors를 활용하는 경향이 있었습니다. 그러나 이러한 접근 방식은 intermediate geometric estimates나 이를 사용하여 quantitative spatial answers를 도출하는 과정에 대해 direct supervision을 제공하지 않았습니다. Answer-only training은 reasoning process를 implicit하게 만들었으며, 이는 정확한 geometric estimation과 적절한 geometric reasoning이 모두 요구되는 quantitative spatial questions에 대한 신뢰성 있는 답변 도출에 한계로 작용했습니다.
저자들은 VLM이 multi-view reconstruction을 통해 complementary한 local geometry와 global scene context를 jointly 학습할 때 spatial Chain-of-Thought (CoT) supervision이 더욱 효과적일 것이라는 가설을 세웠습니다. 본 연구의 핵심 문제는 VLM이 학습된 geometric information을 explicit reasoning traces 내에서 효과적으로 표현하고 활용하여 spatial Question Answering (QA) tasks를 해결하는 데 필요한 명확한 guidance의 부재였습니다. 이러한 한계점을 극복하기 위해 SpatialSpeak 프레임워크 [Figure 1, Figure 2]는 QA-native reconstruction pretraining과 spatial CoT learning을 결합하여, VLM이 기하학적 정보를 보다 정확하고 해석 가능하게 활용할 수 있도록 하는 새로운 접근 방식을 제안합니다.
3. Method & Key Results
본 논문은 SpatialSpeak라는 2단계 학습 프레임워크를 제안합니다 [cite: 1, Figure 1, Figure 2]. 이 프레임워크는 QA-Native Reconstruction Pretraining (QA-RP)과 spatial Chain-of-Thought with Visual Compensation (CoT-VC)을 결합하여 multi-view spatial reasoning 능력을 향상시킵니다.
Stage I: QA-Native Reconstruction Pretraining (QA-RP) 에서는 VLM이 metric-scale multi-view 3D reconstruction을 standard QA interface 내에서 수행하도록 훈련됩니다 [cite: 1, Figure 2]. 이 단계는 두 가지 상보적인 task로 구성됩니다:
- Local Reconstruction Task: Marked image point의 fine-grained 3D coordinates를 예측하여 local geometry에 대한 explicit한 3D grounding을 제공합니다.
- Global Reconstruction Context: 모든 visible object instances의 semantic categories와 3D centers를 shared first-frame camera coordinate system에서 enumerating하고 predicting하여 global scene context를 제공합니다. 이 두 task는 모두 text-based question answering 형태로 공식화되어 geometric prediction과 spatial reasoning이 동일한 autoregressive output interface를 공유하도록 설계되었습니다.
Stage II: Spatial Chain-of-Thought with Visual Compensation (CoT-VC) 에서는 Stage I에서 pretrain된 VLM을 finetuning하여 학습된 geometry를 사용하여 explicit하게 reasoning하도록 합니다 [cite: 1, Figure 2]. CoT-VC는 질문과 관련된 entities를 식별하고, geometric estimates를 표현하며, explicit computations를 통해 answers를 도출하는 structured responses를 생성하도록 모델을 훈련합니다 [cite: 1, Figure 3]. 특히, geometric derivations가 approximate할 수 있다는 점을 고려하여 reliability assessment와 visual evidence를 사용한 answer refinement가 포함됩니다.
핵심 결과로는 ReVSI 벤치마크에서 SpatialSpeak-4B가 62.8의 state-of-the-art 평균 점수를 달성하여, 기존 최고 성능인 SpatialStack-4B (54.1) 대비 8.7 points의 상당한 개선을 보였습니다 [cite: 1, Table 6]. Ablation study 결과, QA-RP는 CoT-VC의 gain을 QA-RP가 없는 경우의 2.6 points에서 6.9 points로 증가시켜 reconstruction pretraining의 중요성을 입증했습니다. 또한, QA-RP 내에서 local 및 global reconstruction supervision 모두 공간 추론에 기여하며, 이 중 하나라도 제거하면 성능이 저하됨을 확인했습니다 (e.g., global queries 제거 시 59.9, local queries 제거 시 59.3) [cite: 1, Table 2]. 3D Pointmap Reconstruction Accuracy 평가에서는 SpatialSpeak의 Stage I 모델이 ScanNet에서 alignment 없이 Acc. 8.9 cm, Comp. 9.3 cm로 CUT3R (13.7 cm, 12.7 cm) 및 MapAnything (36.3 cm, 28.4 cm)보다 낮은 에러를 기록했습니다 [cite: 1, Table 5]. SpatialSpeak는 또한 VSI-Bench (normal training 63.3, scaled training 73.0) [cite: 1, Table 7, Table 8] 및 SPAR-Bench (76.0) [cite: 1, Table 9]에서도 state-of-the-art 결과를 달성했습니다.
4. Conclusion & Impact
본 논문은 Multi-view Vision-Language Models (VLMs)의 spatial reasoning 능력을 향상시키기 위한 SpatialSpeak라는 2단계 학습 프레임워크를 성공적으로 제안했습니다. 이 프레임워크는 QA-Native Reconstruction Pretraining (QA-RP)을 통해 local geometry와 global scene context를 학습하고, 이어 spatial Chain-of-Thought with Visual Compensation (CoT-VC)을 통해 명시적인 공간 추론을 수행하도록 훈련합니다. 이러한 접근 방식은 VLM이 질문과 관련된 geometric estimates를 표현하고 이를 바탕으로 answers를 도출하며, 필요한 경우 visual compensation을 통해 답변을 정제하는 능력을 강화합니다.
SpatialSpeak는 ReVSI, VSI-Bench, SPAR-Bench 등 주요 spatial reasoning 벤치마크에서 state-of-the-art 성능을 달성함으로써, QA-RP가 후속 CoT-VC 단계의 성능 향상에 크게 기여하며 local 및 global reconstruction supervision이 spatial reasoning에 모두 중요하다는 것을 입증했습니다. 이 연구는 Vision-Language Models 분야에서 reconstruction-augmented reasoning의 중요성을 강조하고, 복잡한 3D spatial reasoning task에서 모델의 spatial intelligence와 해석 가능성을 향상시키는 데 중요한 시사점을 제공합니다. 이는 학계 및 산업계 모두에서 더욱 정교하고 신뢰할 수 있는 spatial AI applications 개발에 기여할 것으로 기대됩니다.
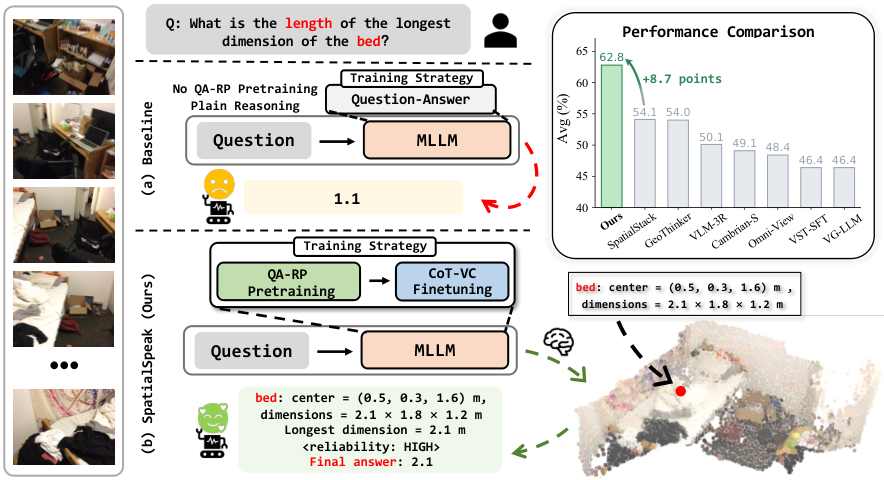
Figure 1 — 제안 모델 개요 및 결과
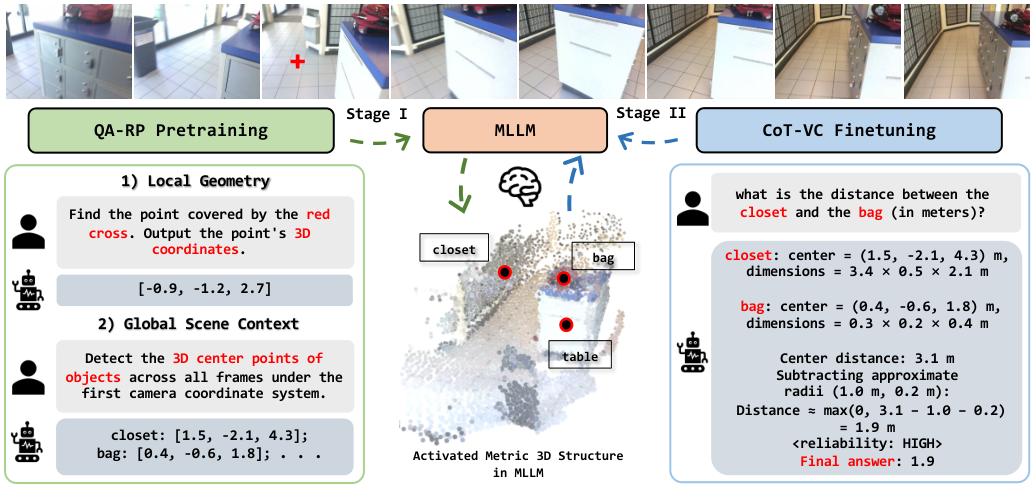
Figure 2 — SpatialSpeak 프레임워크
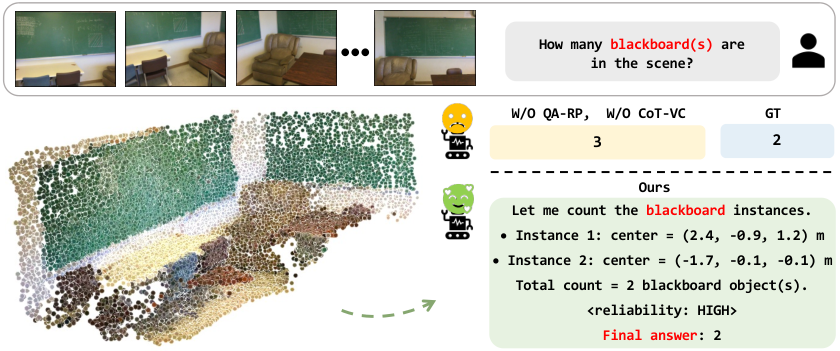
Figure 3 — 정성적 추론 예시
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] SPARGen: Unifying Spatial Perception and Reasoning through Native Multimodal Generation
- [논문리뷰] MentalThink: Shaping Thoughts in Mental SVG World
- [논문리뷰] Think3D: Thinking with Space for Spatial Reasoning
- [논문리뷰] N3D-VLM: Native 3D Grounding Enables Accurate Spatial Reasoning in Vision-Language Models
- [논문리뷰] COOPER: A Unified Model for Cooperative Perception and Reasoning in Spatial Intelligence
Review 의 다른글
- 이전글 [논문리뷰] SolveEdit: Benchmarking Visual Problem Solving in Generative Models
- 현재글 : [논문리뷰] SpatialSpeak: QA-Native Reconstruction with Local and Global Context for Spatial Chain-of-Thought Reasoning
- 다음글 [논문리뷰] Structured Residual Connectivity Matters for Diffusion Transformers
댓글