[논문리뷰] LEGO-Anything: Coding Agents for 3D Scene Reconstruction
링크: 논문 PDF로 바로 열기
저자: Xirui Li, Peng Shi, Mingwen Dong, Sheng Zhang, Zhuoyan Xu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
본 논문에서 다루는 핵심 용어 및 정의는 다음과 같습니다.
- Image-to-Code (Image2Code): 단일 RGB 이미지로부터 3D 장면을 재구성하기 위해 코딩 에이전트가 Blender 코드를 반복적으로 작성하고 실행하며, 장면을 검사하고 프로그램을 수정하는 프레임워크입니다.
- Coding Agents: 언어 모델과 코드 편집, 실행 및 반복적인 검증을 위한 도구를 결합하여, 여기서는 3D 장면 프로그램을 점진적으로 구축하는 데 사용되는 시스템입니다.
- LEGO-Bench: 시뮬레이터 기반의 진단 벤치마크로, 104개의 다양한 실내 및 실외 장면에서 208개의 이미지를 포함하며, End-to-End 3D 장면 재구성 성능을 평가하는 데 사용됩니다.
- LEGO-Plugin: 학습 과정 없이 Harness Plugin 형태로 약한 장면 초기화, 퇴행적 편집, 신뢰할 수 없는 자체 평가와 같은 반복적인 장면 구축 실패 모드를 개선하도록 설계된 모듈입니다.
- LEGO-World: 재구성된 장면 프로그램을 활용하여 객체 탐지(Object Detection), 인스턴스 분할(Instance Segmentation), 상대 깊이(Relative Depth)를 도출함으로써 다운스트림 Vision Task에서의 활용 가능성을 평가하는 설정입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
기존의 3D 재구성 방법론은 메쉬(meshes), 포인트 맵(point maps), 또는 객체 세트(object sets)와 같이 고정된 3D 출력을 생성하거나, 인식, 재구성, 자산 검색 및 장면 조립을 위한 특화된 구성 요소를 결합하는 경향이 있습니다. 이러한 방식은 재구성된 장면에 대한 직접적인 검사, 편집 및 쿼리(query)를 어렵게 한다는 한계를 가집니다.
연구팀은 단일 이미지 3D 장면 재구성을 명시적이고 실행 가능한 장면 프로그램(scene program)의 반복적인 구축 문제로 재정의합니다. 또한, 기존 벤치마크들은 객체 또는 부분 수준 모델링, 텍스트 기반 세계 명세, 또는 보정된 다중 뷰 실내 관측에 초점을 맞춰 실제 사용 시나리오에서 요구되는 다양한 자연 이미지로부터의 End-to-End 실행 가능한 장면 재구성 평가에는 한계가 있었습니다. 본 연구는 이러한 간극을 해결하고, 코딩 에이전트가 단일 이미지로부터 장면을 얼마나 충실하게 재구성하는지, 반복적인 구축 과정의 한계는 무엇인지, 그리고 결과로 생성된 장면 프로그램이 자연 이미지의 유의미한 표현으로 기능할 수 있는지를 탐구합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 단일 이미지 장면 재구성을 Image-to-Code (Image2Code) 문제로 공식화하는 LEGO-Anything 프레임워크를 제안합니다. 이 프레임워크에서 범용 Coding Agent는 단일 RGB 입력 이미지로부터 3D 장면 프로그램을 생성하기 위해 Blender 코드를 반복적으로 계획하고, 편집하고, 실행하며, 진화하는 장면과 렌더링을 검사하고 수정합니다 [Figure 1].
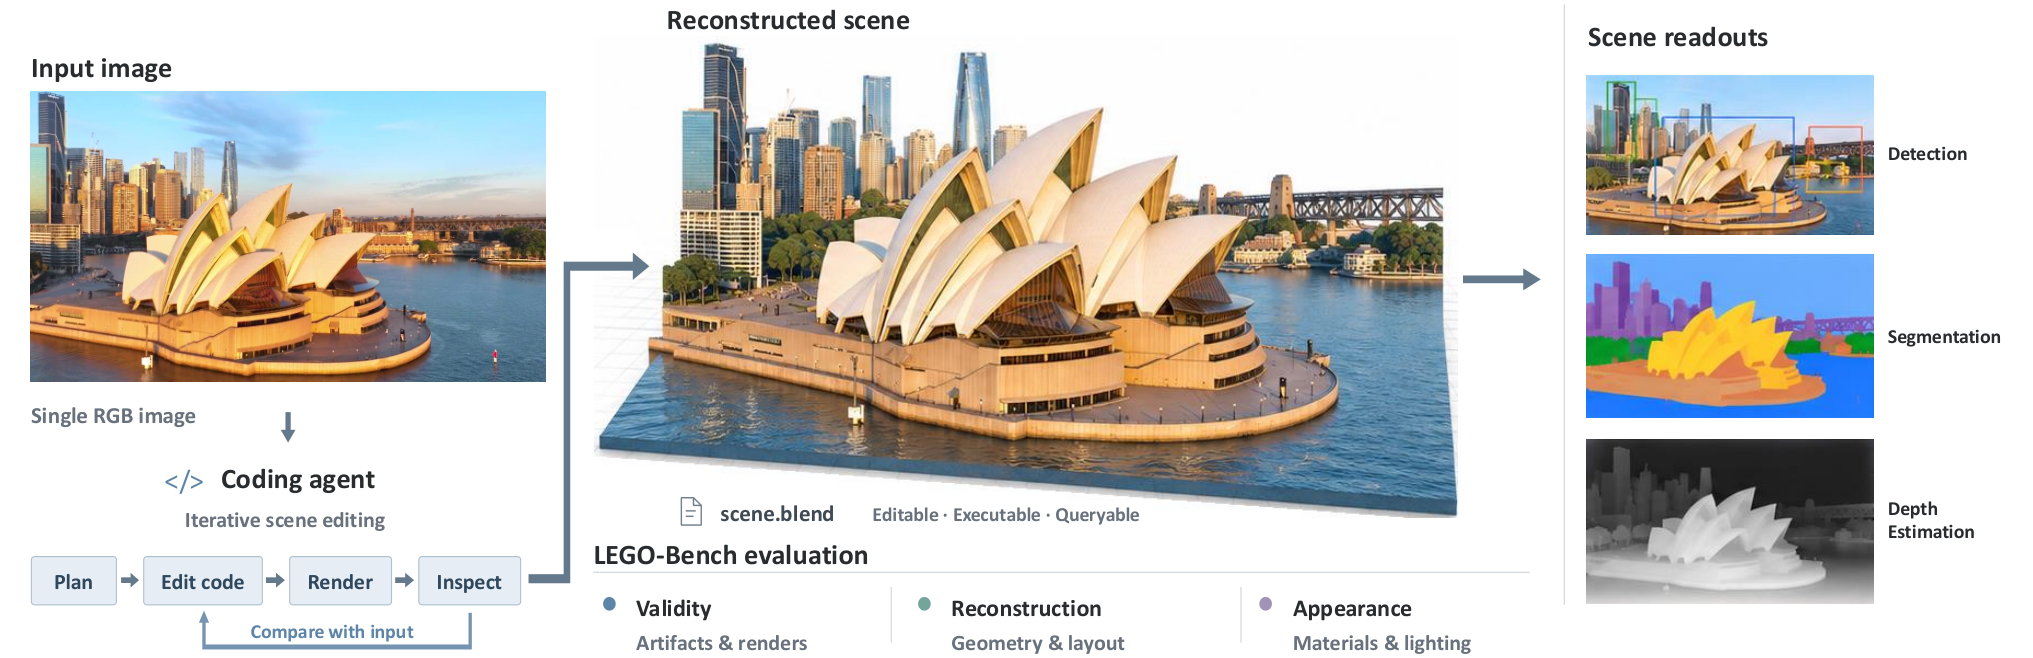
Figure 1 — 이미지로부터 장면 프로그램으로
이러한 Agentic End-to-End 재구성의 성능을 평가하기 위해, 연구팀은 LEGO-Bench라는 시뮬레이터 기반 진단 벤치마크를 도입했습니다. LEGO-Bench는 아티팩트 유효성(artifact Validity), 가시 표면 재구성(visible-surface Reconstruction), 렌더링된 외관(rendered Appearance)을 개별적으로 평가하며, Blender와 같은 3D 편집 환경에서 코딩 에이전트의 장면 재구성 능력을 측정합니다. 코딩 에이전트의 반복적인 구축 과정에서 발생하는 약한 초기화, 퇴행적 편집, 신뢰할 수 없는 자체 평가와 같은 실패 모드를 분석하고 진단하기 위해, LEGO-Plugin이라는 학습 없는 Harness Plugin을 제안합니다. LEGO-Plugin은 Enhanced Initialization, Grounded Refinement, Version Control 세 가지 모듈로 구성되어 있으며, 각각 특정 실패 모드를 직접적으로 해결합니다 [Figure 7].
주요 실험 결과는 다음과 같습니다.
- LEGO-Bench 평가에서 GPT-6-astra는 Indoor 환경에서 53.4%, Outdoor 환경에서 39.6%의 가장 강력한 Overall score를 달성하여, 다른 코딩 에이전트 및 Task-Specific LLM Systems을 능가했습니다 [Table 3]. 이는 범용 코딩 에이전트가 복잡한 3D 장면 재구성 작업에서 높은 잠재력을 가지고 있음을 보여줍니다.
- 모든 GPT 계열 코딩 에이전트(GPT-6 및 GPT-5.6)는 Indoor 및 Outdoor 환경에서 97.0%에서 100.0%에 이르는 높은 Validity를 보이며 유효한 아티팩트를 안정적으로 생성했습니다. [Table 3] 하지만 Reconstruction 및 Appearance 점수는 GPT-6-astra의 Indoor Reconstruction 52.4%, Appearance 54.4%로, 아티팩트 생성 능력과 기하학적/시각적 충실도 사이의 상당한 격차를 드러냈습니다 [Table 3].
- LEGO-Plugin은 LEGO-Bench Office 서브셋에서 평가된 6개 모델 모두의 성능을 향상시켰으며, 특히 성능이 낮은 에이전트의 경우 최대 62.7%의 Relative Gain을 보였습니다. 이는 LEGO-Plugin이 약한 초기화, 퇴행적 편집, 부정확한 자체 평가와 같은 실패를 효과적으로 보완하여, 모델 간 성능 격차를 줄이는 데 기여함을 시사합니다.
- LEGO-World 평가에서 GPT-6-astra에 의해 재구성된 장면은 Task-Specific Training 없이도 COCO BBox AP 30.14, LVIS Mask AP 14.75, ETH3D Depth AbsRel 0.1554를 달성했습니다 [Table 5]. 이는 재구성된 Scene Program이 Downstream Vision Task를 위한 구조화된 표현으로서 비록 전문 모델에는 미치지 못하지만 유의미한 성능을 보임을 나타냅니다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 Image-to-Code 프레임워크인 LEGO-Anything을 통해 단일 이미지로부터 편집 및 실행 가능한 3D Scene Program을 반복적으로 재구성하는 방법론을 제시합니다. LEGO-Bench 벤치마크 평가를 통해 현재 Coding Agents가 유효한 아티팩트는 안정적으로 생성하지만, 기하학적 충실도(geometric fidelity)에는 상당한 한계가 있음을 확인했습니다. 이 한계점들은 초기화(initialization) 부족, 퇴행적 편집(regressive edits), 그리고 신뢰할 수 없는 자체 평가(unreliable self-evaluation)에서 기인하며, LEGO-Plugin을 통해 이러한 문제들을 효과적으로 개선할 수 있음을 입증했습니다. 마지막으로, LEGO-World를 통해 재구성된 장면이 훈련 없이도 검출, 분할, 깊이 추정 등의 하위 Vision Task를 지원할 수 있음을 보여주었습니다. 이 연구는 실행 가능한 Scene Program이 범용 Coding Agents의 유망하고 측정 가능하며 진단 가능한 목표임을 시사하며, LEGO-Bench의 확장 가능한 디자인이 향후 충실한 Scene Reconstruction 발전에 기여할 것으로 기대됩니다.
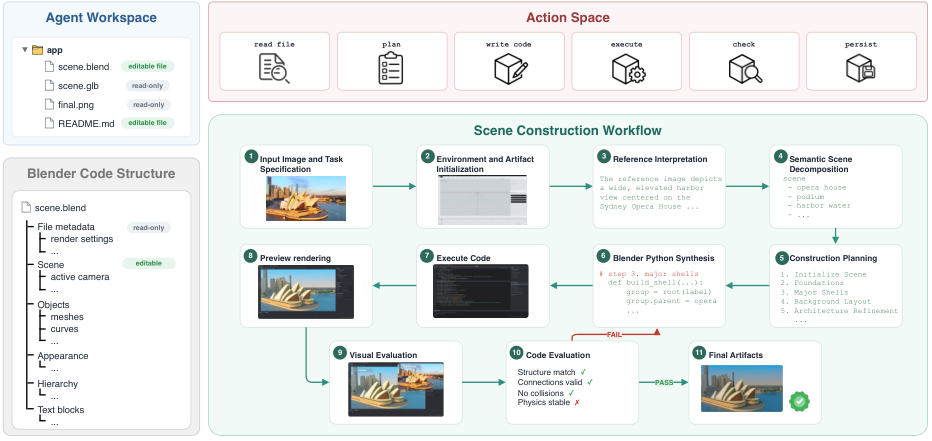
Figure 2 — 에이전트 장면 구축 워크플로우
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] WideSWE: Can Coding Agents Coordinate Changes Across Repositories?
- [논문리뷰] Self-Evolving Coding Agents: From Digital Programs to Physical-World Intelligence
- [논문리뷰] Coding Agents for Generalized Task and Motion Planning Problems
- [논문리뷰] Training-Adaptive Convolutional Sparse Coding via Information Bottleneck for Robust Visual Representation
- [논문리뷰] An Empirical Study of Harness Design for Coding Agents
Review 의 다른글
- 이전글 [논문리뷰] In-Context Learning for Robots: Methods and Applications
- 현재글 : [논문리뷰] LEGO-Anything: Coding Agents for 3D Scene Reconstruction
- 다음글 [논문리뷰] LLMs are General Asynchronous Agents
댓글