[논문리뷰] What Makes World Action Models Generalize? An Empirical Study of Test-Time Future Modeling
링크: 논문 PDF로 바로 열기
메타데이터
저자: Renping Zhou, Zanlin Ni, Zihao Fan, Guohao Fu, Zeyu Liu, Hao Shi, Jie Zhang, Chi Bene Chen, Yang Yue, Xueyang Fu, Gao Huang
1. Key Terms & Definitions (핵심 용어 및 정의)
- WAM (World Action Model): 비디오 생성 모델에서 파생된 프리트레이닝을 통해 미래의 시각적 역학(visual dynamics)을 예측하고 이를 기반으로 행동(action)을 생성하는 모델 프레임워크입니다.
- Explicit Paradigm: 추론 시 매 행동 단위(action chunk)마다 미래 프레임을 점진적으로 디노이징(denoising)하여 깨끗한 미래 정보를 생성하고, 이를 조건으로 행동을 예측하는 방식입니다.
- Latent Paradigm: 훈련 시에는 미래 예측을 학습하지만, 추론 시에는 비디오 생성(디노이징) 과정을 완전히 생략하여 연산 효율성을 극대화한 방식입니다.
- Environmental Perturbation: 로봇 초기 상태, 카메라 시점, 조명, 배경 등 훈련 시 보지 못한 환경적 변화에 대한 정책의 견고함(robustness)을 의미합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 WAM에서 미래 예측이 추론 과정에서 필수적인지, 아니면 단지 학습을 위한 보조 수단인지에 대한 의문을 제기합니다. 기존의 Explicit Paradigm은 높은 성능을 보이지만 무거운 비디오 디노이징 연산 비용으로 인해 실시간 제어가 어렵고, 반대로 Latent Paradigm은 연산 효율은 높지만 WAM의 핵심 장점인 일반화 능력이 크게 저하되는 문제가 발생합니다 [Figure 1]. 저자들은 기존의 모델들이 in-distribution 환경에서는 유사한 성능을 보일지라도, 환경 변화나 데이터 부족 상황에서 일반화 성능의 간극이 명확하게 드러남을 지적합니다. 따라서 본 연구는 추론 효율성과 일반화 성능을 동시에 확보할 수 있는 새로운 접근 방식을 모색합니다.
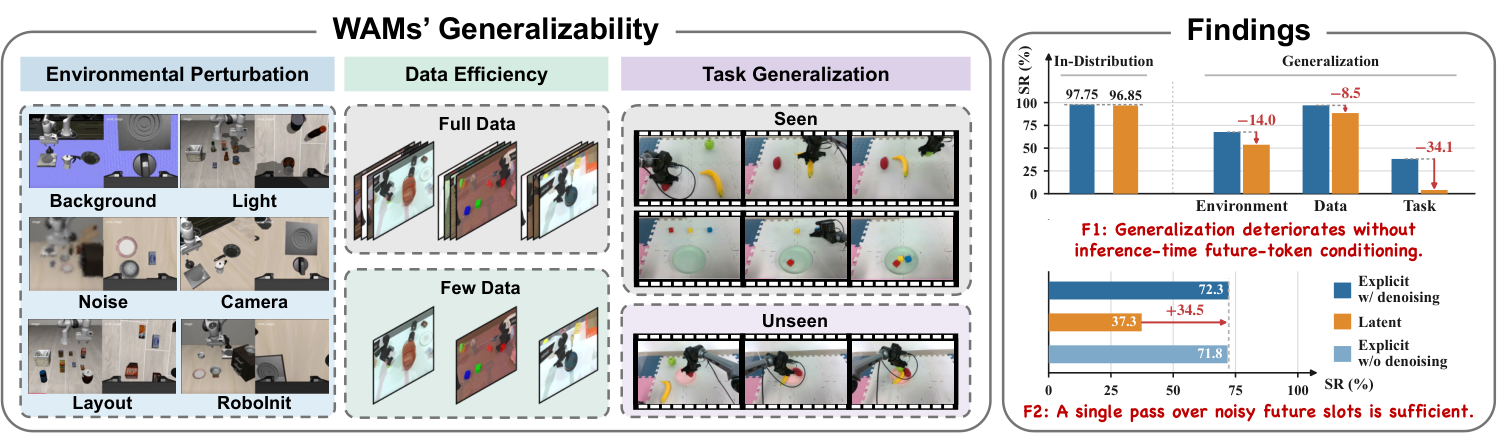
Figure 1 — WAM 일반화 비교 연구 프레임워크
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 미래를 생성하지 않고도 '미래 정보를 준비하는 과정'만으로 일반화 성능을 회복할 수 있다는 점에 착안하여 Simple-WAM을 제안합니다. Simple-WAM은 추론 시 Fully Noised Future 상태에서 비디오 전문가 모델을 단 한 번만 순방향 패스(forward pass)하여 얻은 특징(feature)을 행동 전문가에게 제공합니다 [Figure 3]. 이는 복잡한 반복 디노이징 없이도 Explicit Paradigm 수준의 일반화 성능을 유지하면서 Latent Paradigm에 근접한 속도를 구현합니다. 주요 실험 결과, Simple-WAM은 환경 변화 환경에서 79.5%의 성공률을 기록하며, Explicit Paradigm(67.7%)과 Latent Paradigm(53.8%)을 유의미하게 상회했습니다 [Table 2]. 또한, 추론 속도 면에서도 Explicit Paradigm 대비 3.8배 빠른 실행 속도를 보여주며 일반화와 효율성 사이의 trade-off를 극복했습니다 [Figure 4].
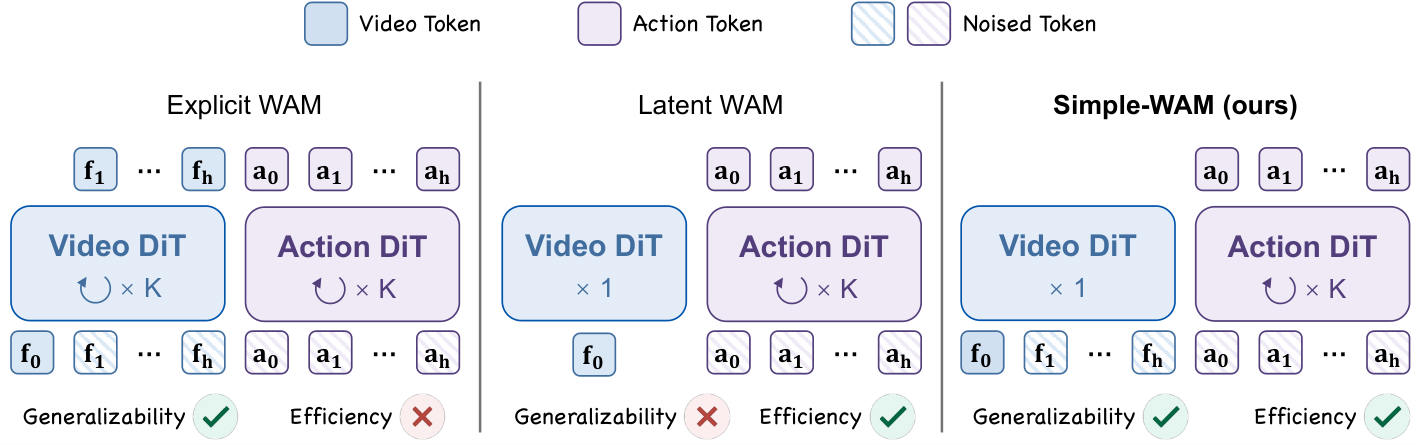
Figure 3 — 세 가지 미래 조건화 방식 비교
4. Conclusion & Impact (결론 및 시사점)
본 연구는 WAM의 일반화 능력이 미래 프레임을 '생성'하는 데 있는 것이 아니라, 추론 시점에 미래 정보를 '조건화(conditioning)'하는 과정에서 비롯됨을 입증했습니다. Simple-WAM은 불필요한 연산을 제거함으로써 실제 로봇 환경에서의 실시간성(real-time)과 강건한 일반화 능력을 모두 만족시키는 실용적인 솔루션을 제시합니다. 이러한 결과는 향후 대규모 Embodied AI 모델의 추론 최적화 방향성에 중요한 이정표를 제시하며, 비디오 생성 기반 제어 정책의 실효성을 한 단계 높인 것으로 평가됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] RoboFollow: Unveiling the Instruction Following Mirage in Embodied Agents
- [논문리뷰] ZimaBlue: Evolving Generalizable World Action Models through Scalable Video Pre-training
- [논문리뷰] Latent Action as Intention Enables Efficient Future Imagination for World Action Models
- [논문리뷰] RISE: Adaptive Imagination for World Action Models
- [논문리뷰] GigaWorld-1: A Roadmap to Build World Models for Robot Policy Evaluation
Review 의 다른글
- 이전글 [논문리뷰] VoxMem: Benchmarking Multimodal Memory in Large Audio Language Models
- 현재글 : [논문리뷰] What Makes World Action Models Generalize? An Empirical Study of Test-Time Future Modeling
- 다음글 [논문리뷰] When Does Dense Retrieval Need Asymmetric Geometry? A Bias-Variance Theory of Shared and Dual Projections
댓글