[논문리뷰] VoxMem: Benchmarking Multimodal Memory in Large Audio Language Models
링크: 논문 PDF로 바로 열기
저자: Yang Xiao, Vidhyasaharan Sethu, Eun-Jung Holden, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
본 논문에서 다루는 핵심 용어 및 개념은 다음과 같습니다.
- LALMs (Large Audio Language Models): 음성 상호작용을 발전시키고 확장된 대화 시스템을 가능하게 하는 대규모 모델입니다.
- Acoustic Evidence: 대화의 전사(transcript) 내용 외에 오디오 신호 자체에 존재하는 정보로, Speaker Identity (누가 말했는지), Paralinguistic Cues (어떻게 말했는지), Environmental Sound (주변에 무엇이 들렸는지) 등을 포함합니다.
- Memory Operations: 기억된 정보를 활용하는 방식으로, Information Extraction (IE), Multi-session Reasoning (MSR), Temporal Evolution Tracking (TET), 그리고 Answer Refusal (AR)의 네 가지 유형으로 나뉩니다.
- Multi-session Histories: 단일 연속 녹음이 아닌, 여러 개의 개별적인 대화 에피소드에 걸쳐 정보가 축적되는 상호작용 기록을 의미합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
음성 기반 대화 시스템은 이전 상호작용(즉, 메모리)에서 정보를 회수하는 능력이 필수적이지만, 현재 LALMs의 multimodal memory 능력은 충분히 평가되지 않고 있습니다. 기존 연구들은 주로 lexical content에 초점을 맞추고 ad hoc한 memory operations를 사용하며, 메모리 문제를 single-session으로 취급하는 한계점을 보입니다. 이로 인해 who said it, how it was spoken, what was audible과 같은 audio signal에만 존재하는 중요한 acoustic evidence를 체계적으로 평가하기 어렵습니다. 또한, 상호작용 histories가 길어짐에 따라 cross-session memory의 성능 저하를 question difficulty나 evidence type과 혼동하지 않고 정확히 분석할 수 있는 방법론이 부재했습니다. 저자들은 이러한 격차를 해소하고, spoken conversational memory의 acoustic evidence와 그에 적용되는 operations를 함께 특징화하는 principled evaluation의 필요성을 제기합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 spoken conversational memory 평가를 위한 VoxMem 벤치마크를 제안합니다 [Figure 1]. VoxMem은 acoustic evidence와 memory operations의 두 가지 축을 따라 two-dimensional taxonomy를 구축합니다 [Figure 1]. Acoustic evidence는 speech semantics, speaker identity, paralinguistic cues, environmental sound의 네 가지 유형을 포함하며, memory operations는 Information Extraction (IE), Multi-session Reasoning (MSR), Temporal Evolution Tracking (TET), Answer Refusal (AR)의 네 가지 유형으로 구성됩니다 [Figure 2]. 벤치마크는 34,743개의 음성 세션(총 177시간)에 걸쳐 3,196개의 evaluation instances를 포함하며, multi-session histories를 기반으로 8K에서 64K tokens에 이르는 context budgets에 걸쳐 stratify되어 있습니다 [Figure 3]. 모든 evaluation instance는 동일한 질문과 evidence를 유지하면서 history length만 다르게 하여 context length 증가가 성능에 미치는 영향을 순수하게 측정할 수 있도록 설계되었습니다.
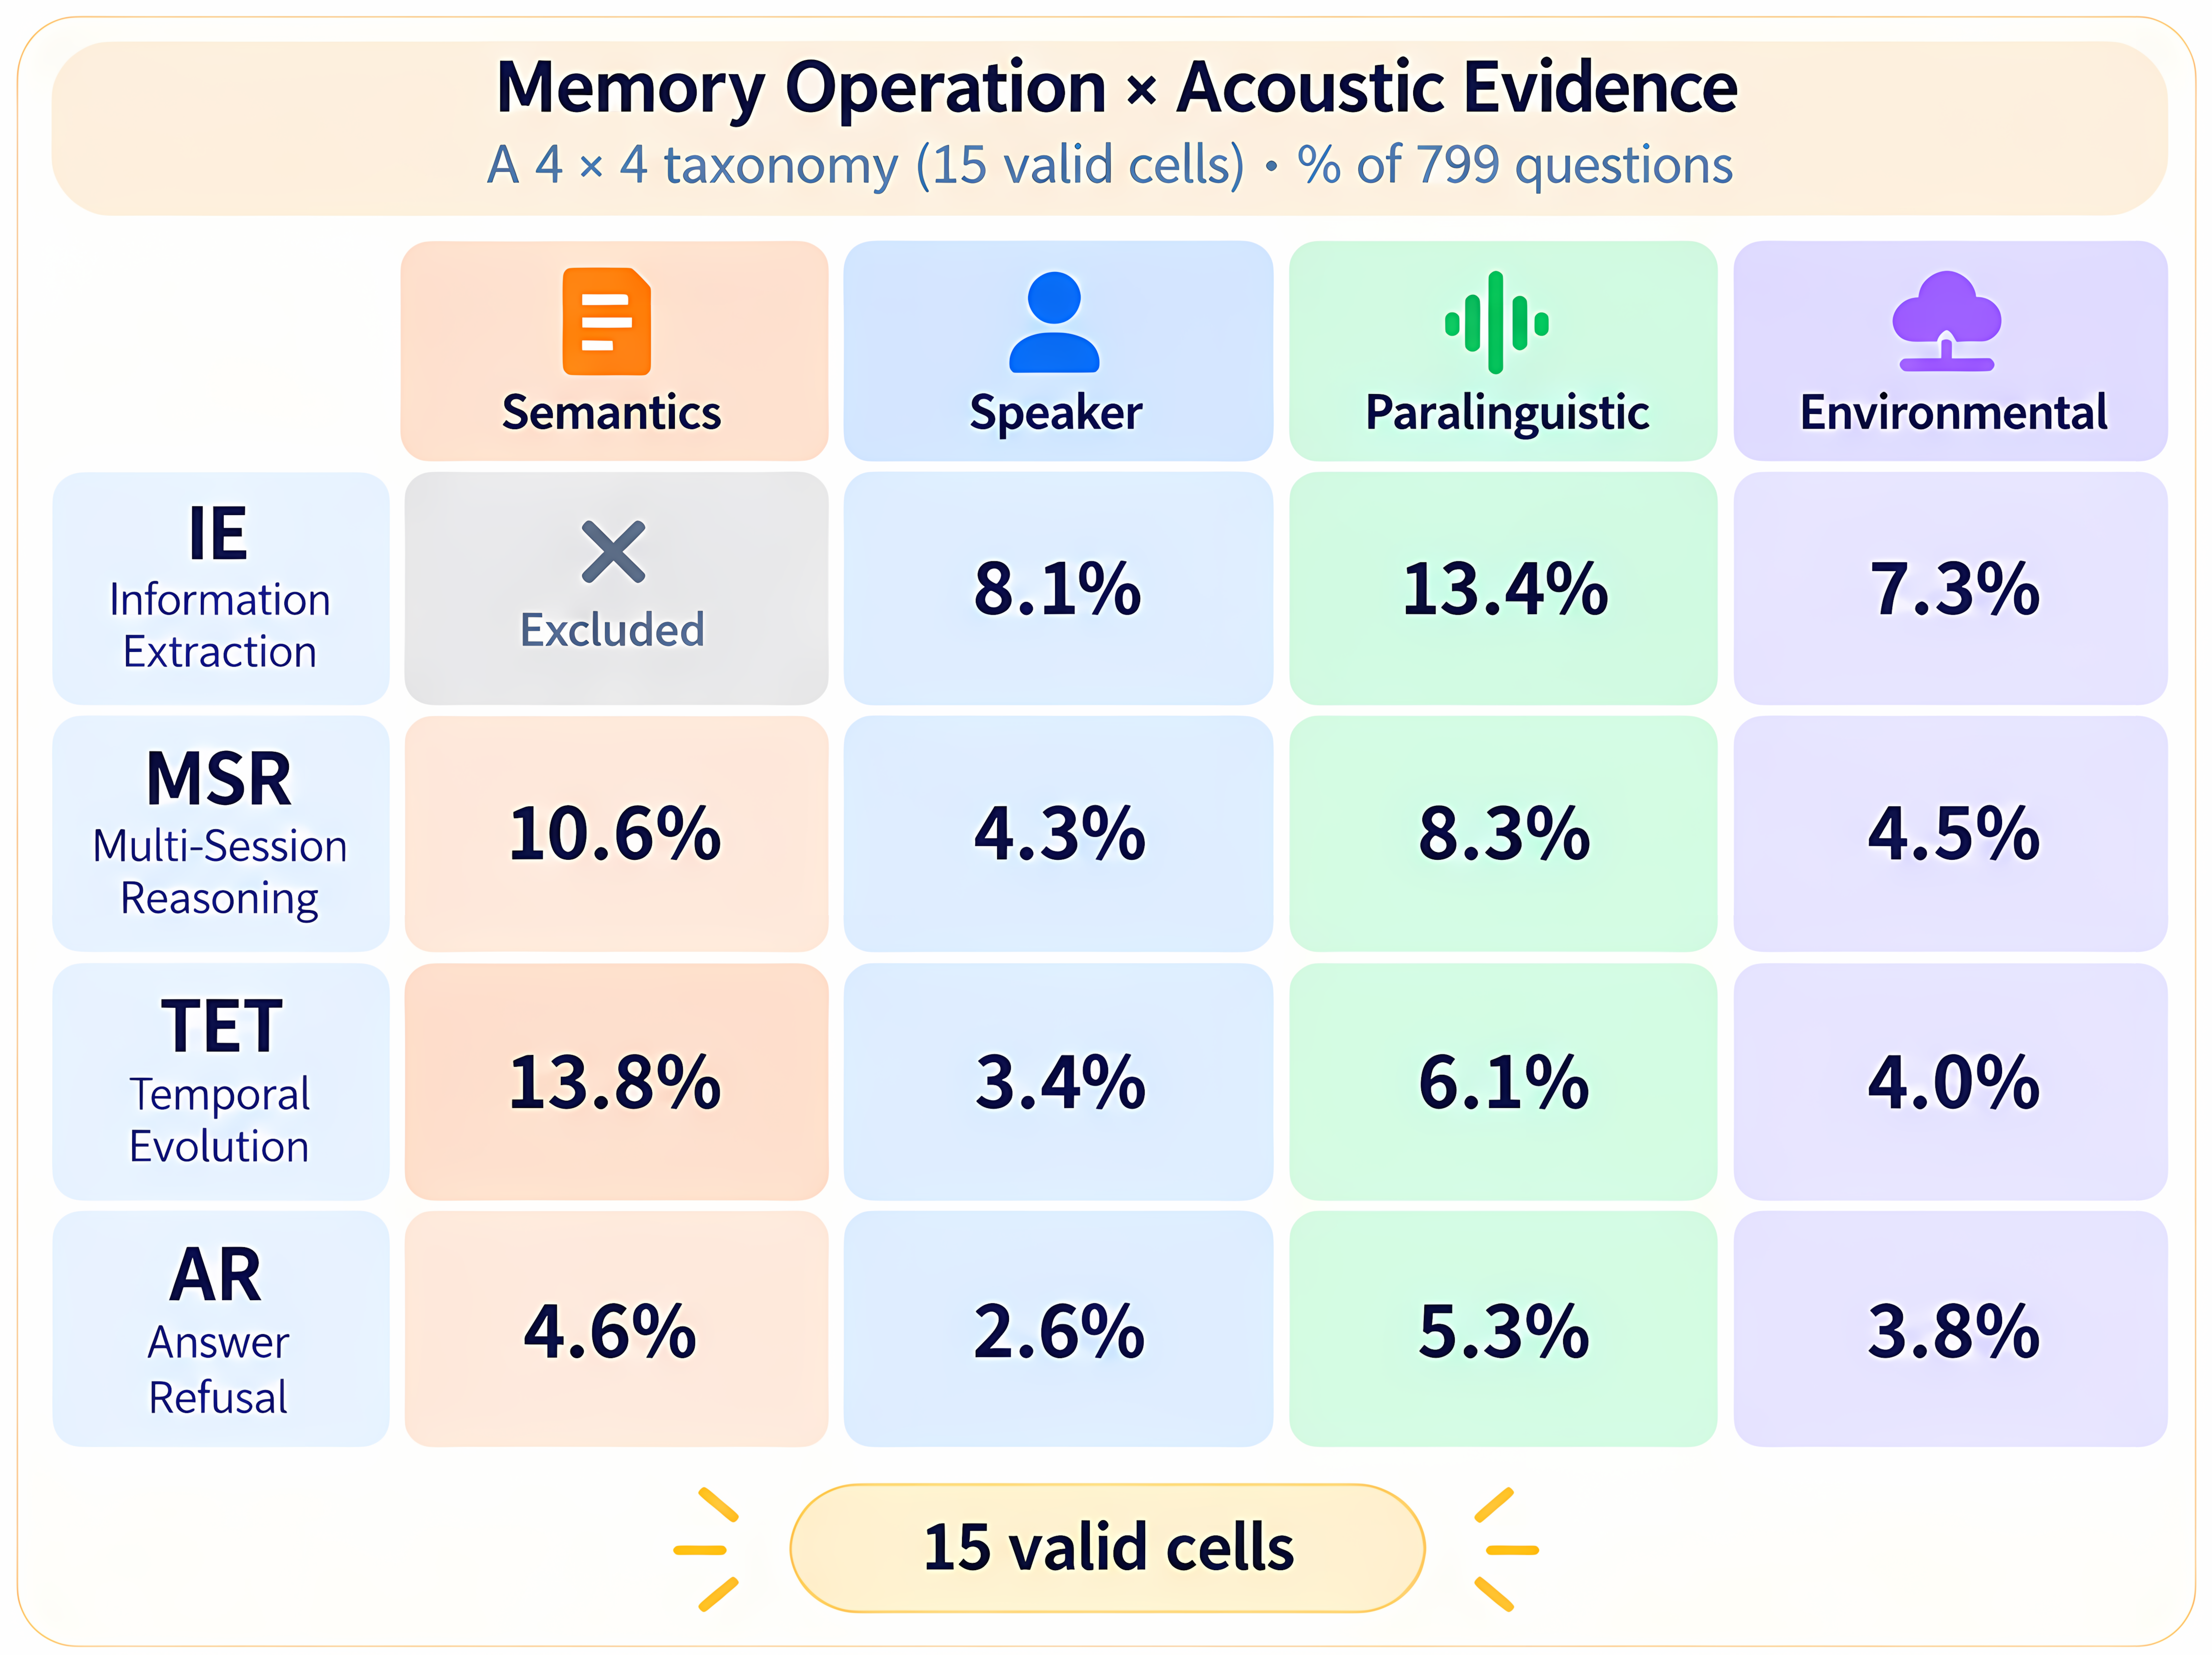
Figure 1 — 벤치마크 Taxonomy
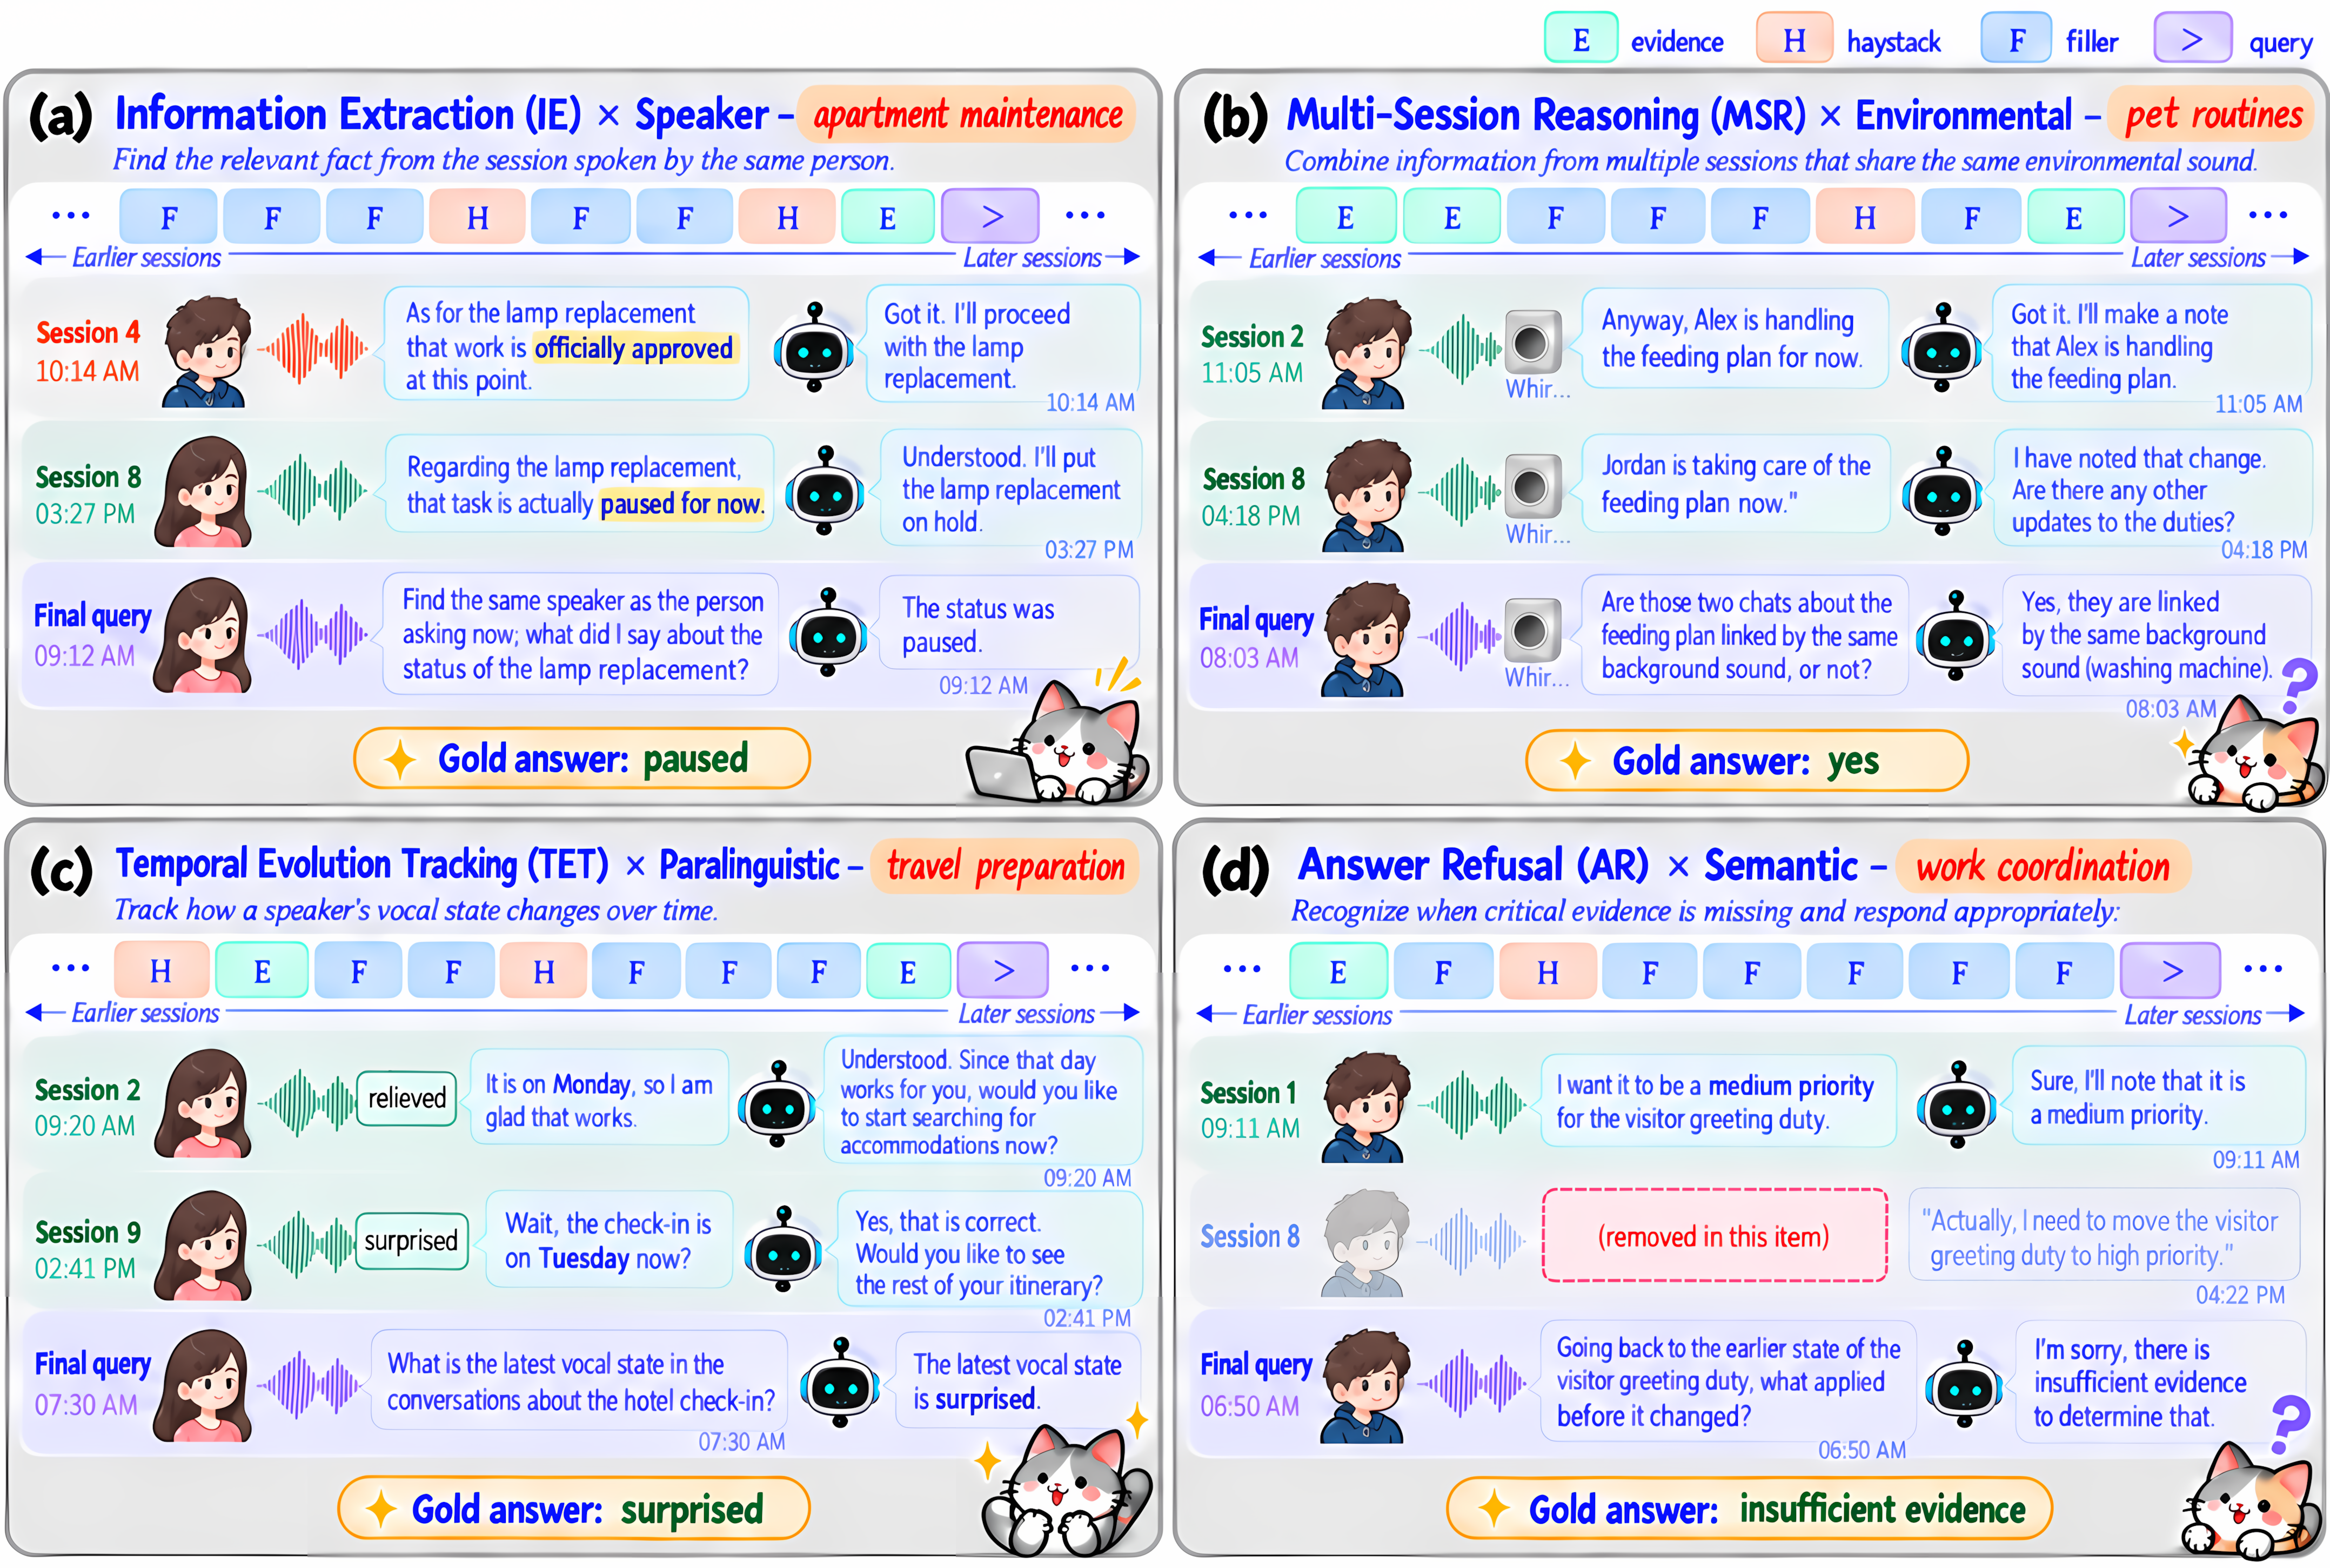
Figure 2 — 대표적 VoxMem 예시
15개 LALMs를 대상으로 한 평가 결과, reference budget 32K에서 어떤 모델도 전체 accuracy 40%를 초과하지 못했으며, 최강 모델도 38.5%에 그쳤습니다 [Figure 4]. 모델들은 speech semantics (무엇이 말해졌는지)를 기억하는 능력은 우수했지만, speaker identity, paralinguistic cues, environmental sound와 같은 non-lexical acoustic information에 대한 메모리 성능은 현저히 낮았습니다. 특히, 32K context에서 proprietary models은 Speech Semantics에서 평균 55.6%의 accuracy를 보였으나, Speaker Identity에서 32.7%, Paralinguistic Cues에서 20.0%, Environmental Sound에서 21.9%로 크게 하락했습니다. Memory difficulty는 operation과 evidence type의 상호작용에 따라 달라졌으며 [Figure 5], 특히 Temporal Evolution Tracking (TET)은 Paralinguistic (3.4%) 및 Environmental (1.2%) evidence에서 성능이 거의 붕괴되는 양상을 보였습니다. 또한, history length가 8K에서 64K tokens로 증가함에 따라 모든 evidence type에서 accuracy가 꾸준히 저하되었습니다 [Figure 6]. error profiles 분석 결과, binding failures가 speaker errors의 주를 이루고, paralinguistic errors는 주로 localization failures로 나타나는 등 failure modes가 evidence type 및 memory operation에 따라 질적으로 상이함을 확인했습니다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 multimodal memory 분야에서 LALMs의 spoken conversational memory 능력을 체계적으로 평가하기 위한 새로운 벤치마크인 VoxMem을 성공적으로 제시했습니다. 평가를 통해 현재 LALMs가 speech semantics에 비해 speaker identity, paralinguistic cues, environmental sound와 같은 non-lexical acoustic information을 기억하는 데 현저한 한계를 보임을 입증했습니다. 특히, temporal evolution tracking과 같은 복잡한 memory operations에서 이러한 격차는 더욱 심화됩니다. interaction histories의 길이가 길어질수록 accuracy가 지속적으로 저하된다는 사실은 단순히 longer audio contexts를 지원하는 것만으로는 persistent spoken interaction을 달성하기에 불충분하다는 것을 시사합니다. 이 연구는 미래 LALMs 개발이 non-lexical acoustic information의 보존 및 speakers, events, sessions와의 association 유지에 중점을 두어야 함을 강조하며, 해당 분야의 발전을 위한 중요한 토대를 제공합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] MemLens: Benchmarking Multimodal Long-Term Memory in Large Vision-Language Models
- [논문리뷰] LoCoBench: A Benchmark for Long-Context Large Language Models in Complex Software Engineering
- [논문리뷰] EpiCon: Collective Agent Learning through Co-Evolving Multimodal Memory
- [논문리뷰] WideSWE: Can Coding Agents Coordinate Changes Across Repositories?
- [논문리뷰] SolveEdit: Benchmarking Visual Problem Solving in Generative Models
Review 의 다른글
- 이전글 [논문리뷰] VideoLoop: Looped Working Memory Against Semantic Thrashing in Long-Form Video Agents
- 현재글 : [논문리뷰] VoxMem: Benchmarking Multimodal Memory in Large Audio Language Models
- 다음글 [논문리뷰] What Makes World Action Models Generalize? An Empirical Study of Test-Time Future Modeling
댓글