[논문리뷰] RSIGame: Autonomous Agentic Game Development with Recursive Self-improvement
링크: 논문 PDF로 바로 열기
메타데이터
저자: Wenyi Wu, Minghao Fu, Jieyu You, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Explore-Diagnose-Improve Loop: 에이전트가 실행 가능한 게임을 탐색하여 버그를 식별하고, 우선순위를 지정한 후 근거 기반(Evidence-grounded)의 수정을 수행하는 핵심 개발 프로세스.
- Evolving Checklist: 개발 과정에서 발견된 이슈, 개선 기회, 검증 결과 등을 지속적으로 업데이트하여 모든 에이전트가 최신 개발 상태를 공유할 수 있도록 돕는 작업 상태(Working state).
- Global Quality Monitor: 다단계 개발 과정에서 게임 전체의 품질을 추적하고, 가장 우수한 체크포인트를 보존하며, 성능 정체(Saturation)나 회귀(Regression)를 감지하는 메커니즘.
- Experience Internalization: 반복적인 개발 과정을 통해 획득한 성공적인 계획, 진단, 수정 경험을 백본 모델에 Supervised Fine-tuning으로 주입하여 모델의 생성 및 개선 능력을 강화하는 기법.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 LLM 기반의 자율적 게임 생성 모델이 단순 플레이 가능한 수준을 넘어, 고품질의 완성도 높은 게임을 생성하는 데 직면한 한계를 해결하고자 한다. 기존의 단순 반복적인 생성 방식은 소수의 테스트 케이스에만 Overfit되어, 복잡한 버그 해결 실패나 플레이어 상호작용에 대한 일반화 부족이라는 문제를 야기한다 [Figure 1]. 이러한 한계를 극복하기 위해 단순히 생성하고 검증하는 단계를 넘어, 개발 과정 자체를 재귀적으로 개선하고 진화시키는 자율적 프레임워크가 요구된다.
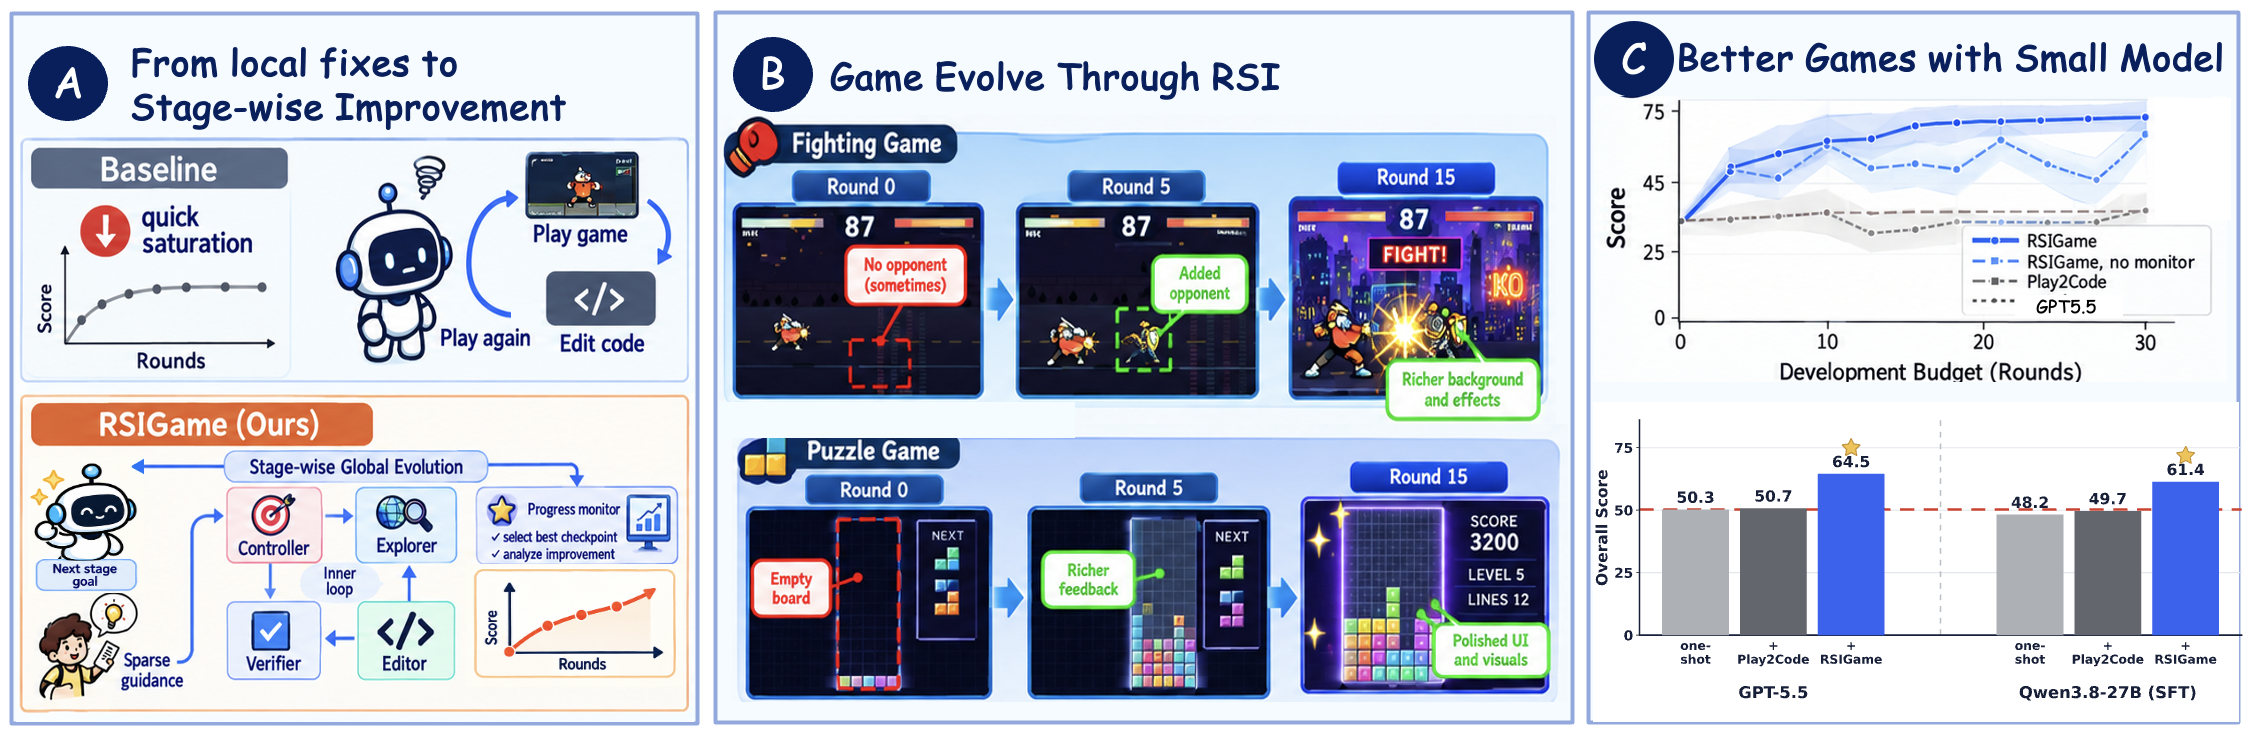
Figure 1 — RSIGame 시스템 개요
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 RSIGame 프레임워크를 제안하며, 이는 로컬 수준의 탐색-진단-개선 루프와 글로벌 수준의 품질 모니터링 루프로 구성된다 [Figure 2]. 제안 방법론은 Explore-Diagnose-Improve 로컬 루프를 통해 지속적으로 이슈를 추적하고, Global Quality Monitor를 통해 개발 과정 전반의 정체 현상을 방지하며 가장 우수한 체크포인트를 보존한다. 또한, 수집된 성공적인 개발 데이터를 백본 모델인 Qwen3.8-27B에 학습시키는 Experience Internalization 과정을 거쳐 모델의 내재적 개발 능력을 극대화한다 [Table 1]. 실험 결과, RSIGame은 140개의 GameCraft-Bench 태스크에서 일관된 성능 향상을 보였다. 특히 Qwen3.8-27B(SFT) 모델은 Godot 환경에서 61.38의 점수를 기록하며, GPT-5.5의 One-shot 점수(50.26)를 큰 폭으로 상회하였고, 생성 토큰 수를 1,111배 절감하는 효율성을 입증하였다 [Table 1].
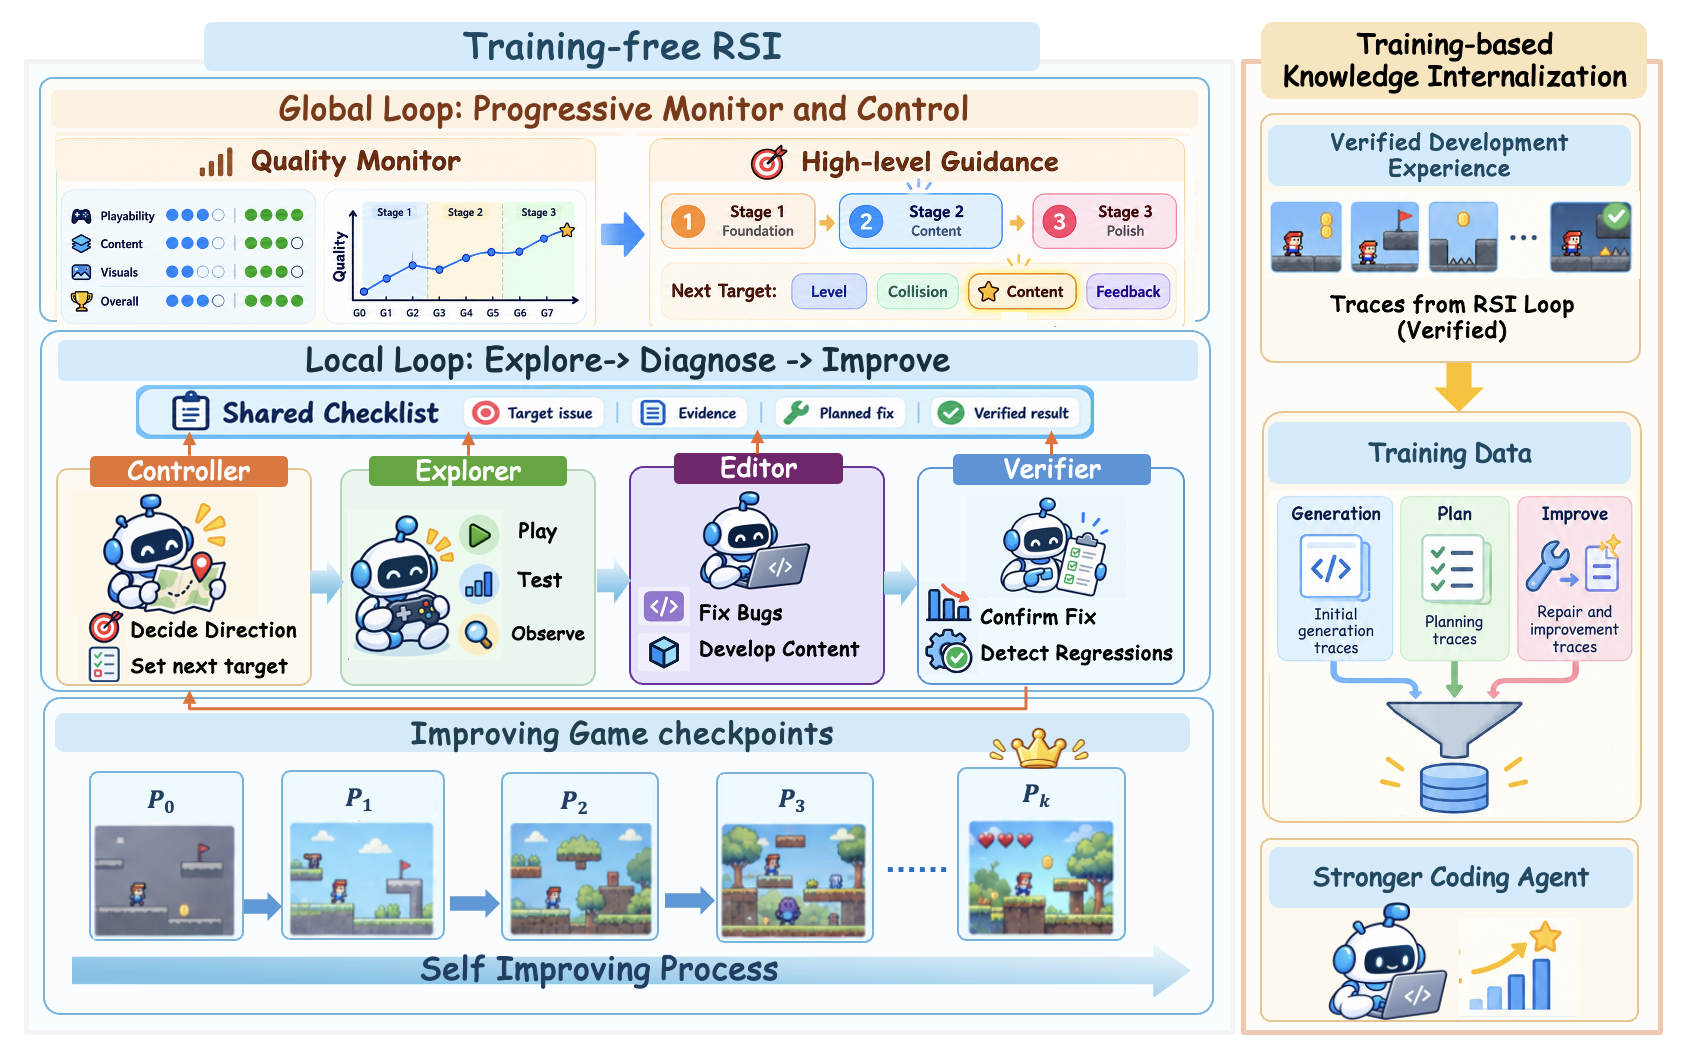
Figure 2 — RSIGame의 로컬 및 글로벌 루프
4. Conclusion & Impact (결론 및 시사점)
본 논문은 게임 개발을 자율적인 재귀적 자기 개선 과정으로 재정의하고, RSIGame 프레임워크를 통해 이 과정을 체계화하였다. 실험을 통해 개발 과정에서의 탐색적 데이터와 경험을 모델 내부에 직접 주입하는 것이 생성 품질 향상과 비용 절감에 효과적임을 입증하였다. 이 연구는 복잡한 소프트웨어 엔지니어링 및 다단계 추론 작업에 LLM을 적용하는 데 중요한 방법론적 토대를 제공하며, 향후 자율적 에이전트 시스템의 일반적인 개발 프레임워크로 발전할 가능성을 제시한다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] Virtual Head Attention
- [논문리뷰] SCOPE: Semantic Bounded Credit Optimization for Prompt Engineering in Text-to-image Generation
- [논문리뷰] Cowork-Gym: Synthesizing Interactive Work Environments at Scale
- [논문리뷰] The Thinking Leakage in Reinforcement Learning for LLMs
Review 의 다른글
- 이전글 [논문리뷰] PivotOPD: Learning to Recover from Pivotal Mistakes in Multi-Turn Agents
- 현재글 : [논문리뷰] RSIGame: Autonomous Agentic Game Development with Recursive Self-improvement
- 다음글 [논문리뷰] RoboCoach: World Models as Active Coaches for Compositional Robot Skills
댓글