[논문리뷰] RoboCoach: World Models as Active Coaches for Compositional Robot Skills
링크: 논문 PDF로 바로 열기
메타데이터
저자: Jiajun Liu, Yifan Chen, Yichao Liu, Jiayi Zhang, Ruoqu Chen, Shaoxuan Xie, Guocai Yao, Mengdi Xu, Sen Cui, Changshui Zhang
1. Key Terms & Definitions (핵심 용어 및 정의)
- CoachWorld: 본 논문에서 제안하는 공유 Action-conditioned world model로, 다양한 로봇의 임베디드 인터랙션을 시뮬레이션하여 미래 관측값을 예측하고 정책을 평가하는 핵심 프레임워크입니다.
- RIDI Loop (Route–Imagine–Diagnose–Improve): 제안하는 방법론의 4단계 순환 구조입니다. 작업을 분해하고(Route), 세계 모델 내에서 정책을 롤아웃하며(Imagine), 실패 지점을 분석하고(Diagnose), 타겟팅된 데이터 수집을 통해 개선(Improve)합니다.
- Subtask–Expert Pair: 긴 작업(Long-horizon task)을 개별 원자적(atomic) 스킬로 분해하여, 각 스킬을 전담하는 LoRA adapter 기반의 Expert와 이를 호출하는 서브태스크를 연결한 학습 단위입니다.
- Progress Judge: 제안된 방법론에서 서브태스크의 완료 여부를 판단하는 모듈로, 시뮬레이션 및 실제 로봇 배포 환경에서 정책의 성공 또는 타임아웃을 결정하는 기준점을 제공합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 긴 호흡의 로봇 조작(Long-horizon robot manipulation) 작업에서 효율적인 정책 개선이 어렵다는 문제를 해결하고자 합니다. 기존의 End-to-End 방식은 특정 구성 요소를 개선하기 위해 방대한 양의 시연 데이터를 필요로 하며, 물리적인 로봇 환경에서의 데이터 수집은 하드웨어 비용과 안전성 문제로 인해 제약이 큽니다. 따라서 저자들은 어떤 기술을 우선적으로 가르쳐야 하며, 어떤 정책 구성 요소를 업데이트해야 하는지에 대한 정량적이고 전략적인 의사결정 프레임워크가 필요하다고 주장합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 CoachWorld 기반의 RIDI loop를 통해 시뮬레이션 내 실패 지점을 파악하고, 이를 바탕으로 필요한 데이터만을 수집하여 특정 Expert를 업데이트하는 Active coaching 프레임워크를 제안합니다 [Figure 1]. Route 단계에서는 긴 작업을 Subtask–Expert 쌍으로 분해하고, Imagine 단계에서 이를 CoachWorld 내에서 시뮬레이션하여 실패하는 첫 번째 지점을 찾습니다. Diagnose와 Improve 단계에서는 이러한 실패 사례를 바탕으로 데이터 수집 우선순위를 결정하고, 해당 스킬을 담당하는 LoRA adapter만을 업데이트하여 효율적인 정책 개선을 수행합니다. 실험 결과, 22개의 태스크-정책 쌍에 대해 시뮬레이션된 성공률과 실제 배포 성공률 간 Spearman correlation이 ρ=0.840으로 매우 높게 나타났습니다. 특히 Franka 로봇에서는 추가 시연 150개만으로 성공률을 13.3%에서 75.0%로, AgileX 로봇에서는 40.0%에서 83.8%로 비약적으로 향상시켰으며, 기존 공유 정책 기반의 베이스라인이 0%의 성공률을 보인 held-out composition 작업에서도 35.0%의 성공률을 달성했습니다.
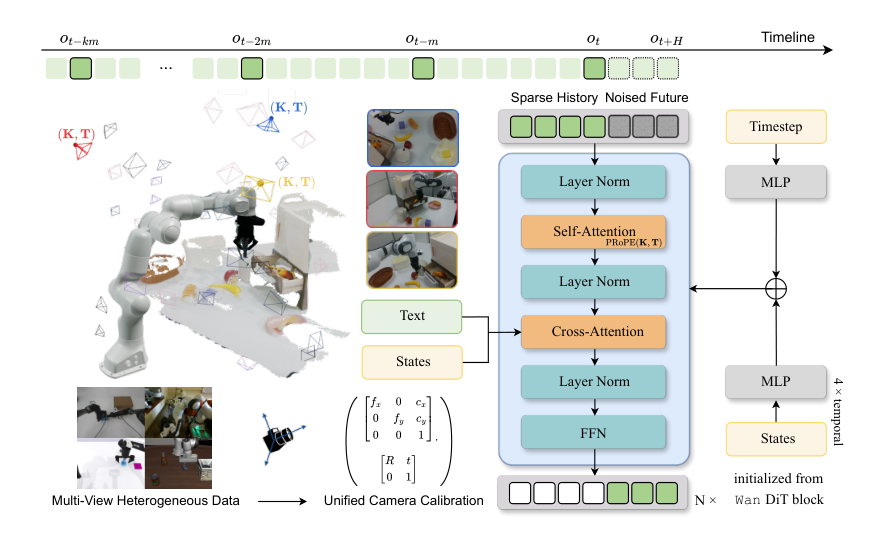
Figure 1 — CoachWorld 아키텍처
4. Conclusion & Impact (결론 및 시사점)
본 논문은 세계 모델이 단순한 시뮬레이션을 넘어 실제 로봇의 정책 개선을 위한 능동적인 코치(Active coach) 역할을 수행할 수 있음을 입증했습니다. RIDI loop와 Subtask–Expert 조합을 통한 모듈식 업데이트 방식은 로봇 데이터 수집 비용을 획기적으로 절감하고, 일반화 성능을 극대화할 수 있는 강력한 도구를 제공합니다. 이 연구는 향후 복잡한 장기 작업을 수행해야 하는 로봇 제어 시스템의 확장성과 데이터 효율적인 학습 전략 수립에 중요한 이정표가 될 것입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Cosmos Policy: Fine-Tuning Video Models for Visuomotor Control and Planning
- [논문리뷰] SurgWorld: Learning Surgical Robot Policies from Videos via World Modeling
- [논문리뷰] CoIRL-AD: Collaborative-Competitive Imitation-Reinforcement Learning in Latent World Models for Autonomous Driving
- [논문리뷰] Towards Agentic Robots: Model, Data, Environment, and Harness
- [논문리뷰] LeWAM: End-to-End World and Action Modeling with JEPAs
Review 의 다른글
- 이전글 [논문리뷰] RSIGame: Autonomous Agentic Game Development with Recursive Self-improvement
- 현재글 : [논문리뷰] RoboCoach: World Models as Active Coaches for Compositional Robot Skills
- 다음글 [논문리뷰] Rubric Rewards from Item Response Theory
댓글