[논문리뷰] Argo-Bench: Evaluating Data Agents on Enterprise-Scale Workflows
링크: 논문 PDF로 바로 열기
메타데이터
저자: Gabriel Tomitsuka, Arman Raayatsanati, Emma Xing, Duke Gand, Joseph J Ma
1. Key Terms & Definitions (핵심 용어 및 정의)
- Argo-Bench: 엔터프라이즈 수준의 데이터 과학 및 분석 워크플로우를 평가하기 위해 설계된 210개의 태스크로 구성된 벤치마킹 프레임워크입니다.
- Oracle E-Business Suite (EBS): 235개의 상호 연결된 테이블과 75억 개의 로우(row)를 포함하는 본 논문의 핵심 데이터 웨어하우스 모델입니다.
- Latent State: 시뮬레이터 내부의 감춰진 데이터 상태로, 에이전트가 직접 볼 수 없으며 결과(결정)의 실질적인 성과를 평가하는 기준(Ground Truth)으로 사용됩니다.
- Agentic Workflow: 단순히 SQL 쿼리를 생성하는 것을 넘어, 데이터 분석 후 의사결정(예: 사기 계정 차단, 예산 배정)을 수행하고 그 결과를 보고하는 end-to-end 프로세스를 의미합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 Text-to-SQL 벤치마크가 엔터프라이즈 환경의 실제 데이터 과학 업무를 평가하는 데 한계가 있다는 점을 지적하며 이를 해결하고자 합니다. 대부분의 기존 벤치마크는 단일 테이블 기반의 공개 데이터셋에 의존하며, 정답지(Answer Key)의 오류율이 높고, 결과의 실제 비즈니스 ROI를 측정할 수 없는 구조적 결함을 가지고 있습니다 [Table 1]. 또한, 실제 기업용 ERP 데이터는 기밀성으로 인해 외부 반출이 불가능하여 에이전트의 성능을 검증할 환경 자체가 부족합니다. 따라서 본 연구는 대규모 Simulated Environment를 통해 에이전트의 데이터 탐색, 분석, 그리고 행동 기반 평가가 가능한 Argo-Bench를 제안합니다 [Figure 1].
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 뉴욕시의 2024년 음식 배달 플랫폼 경제를 기반으로 한 대규모 Simulator를 구축하여 8,100만 건의 주문을 생성하고 이를 Oracle E-Business Suite 형식의 웨어하우스로 정교하게 설계하였습니다. 본 방법론의 핵심은 에이전트가 웨어하우스를 탐색하여 사실을 재구성하게 하고, 그들이 제출한 최종 결정(Action)을 Latent State 기반의 Grader가 결과의 실질적인 가치에 따라 평가하는 방식입니다 [Figure 2]. 주요 실험 결과, 14개의 frontier 및 open-weight 모델을 평가한 결과 최고 성능 모델인 Claude Opus 5.5조차 전체 태스크 중 34.8%만 95점 이상의 고득점을 기록했으며, 평균 점수는 59.5점에 불과했습니다 [Table 2]. 특히 많은 모델이 분석 과정에서 잘못된 레코드를 참조하거나 잘못된 비즈니스 목표를 최적화하는 경향을 보였으며, 이는 Argo-Bench가 기존 벤치마크보다 훨씬 엄격하고 실무적인 난이도를 제공함을 입증합니다.
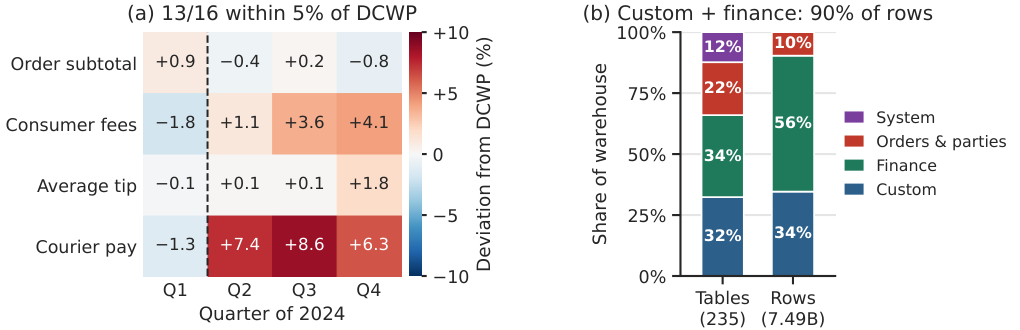
Figure 2 — 시뮬레이션 환경 개요
4. Conclusion & Impact (결론 및 시사점)
본 논문은 엔터프라이즈 데이터 워크플로우를 포괄적으로 평가할 수 있는 최초의 대규모 시뮬레이션 벤치마크인 Argo-Bench를 성공적으로 선보였습니다. 이 연구는 단순히 데이터 쿼리 능력을 넘어, 모델이 복잡한 데이터 환경을 이해하고, 통계 및 기계 학습 라이브러리를 활용하여 실질적인 비즈니스 의사결정을 내릴 수 있는 능력을 검증한다는 점에서 큰 학술적/산업적 가치를 지닙니다. 향후 데이터 에이전트가 현실 세계의 ERP 환경에서 보다 신뢰할 수 있게 작동하도록 유도하는 이정표가 될 것입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] StartupBench: Benchmarking General-Purpose Agents on Market-Validated End-to-End Workflows
- [논문리뷰] ResearchGym: Evaluating Language Model Agents on Real-World AI Research
- [논문리뷰] ToolPRMBench: Evaluating and Advancing Process Reward Models for Tool-using Agents
- [논문리뷰] EcomBench: Towards Holistic Evaluation of Foundation Agents in E-commerce
- [논문리뷰] ARE: Scaling Up Agent Environments and Evaluations
Review 의 다른글
- 이전글 [논문리뷰] Architect-Ant: Editable Automatic Furnishing of Architectural Floor Plans
- 현재글 : [논문리뷰] Argo-Bench: Evaluating Data Agents on Enterprise-Scale Workflows
- 다음글 [논문리뷰] AutoDataBench: A Data-centric Testbed for Accelerating Auto Research
댓글