[논문리뷰] AutoGUIWorld: Image Generators as Visual World Models for GUI Agent
링크: 논문 PDF로 바로 열기
메타데이터
저자: Cheng Yang, Yifan Wu, Yutao Huang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- GUI Agent: 스크린샷, 마우스 및 키보드 입력을 통해 소프트웨어 환경을 조작하고 작업을 수행하는 AI 모델을 의미합니다.
- Visual World Model: 실시간 환경을 직접 실행하지 않고도, 이미지 생성 모델을 활용하여 다음 GUI 상태를 예측 및 렌더링하는 데이터 생성 프레임워크입니다.
- Interaction Fidelity: 합성된 GUI 궤적(Trajectory)이 실제 시스템에서 생성된 궤적과 얼마나 일치하는지를 나타내는 지표로, 사용자 인터페이스와 상호작용의 자연스러움을 보장합니다.
- Seed Realization: 운영체제, 인터페이스 스타일, 초기 화면 상태 등을 포함하는 구조화된 명세로부터 기초 스크린샷을 생성하는 과정입니다.
- Meta Planner: 전체 작업의 흐름을 설계하고 순차적인 Action과 기대되는 시각적 변화를 정의하여 GUI 궤적의 논리적 일관성을 유지하는 컴포넌트입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 GUI Agent 학습에 필수적인 고품질 인터랙션 데이터를 구축할 때 발생하는 배포 및 환경 구성의 높은 비용과 제한된 다양성 문제를 해결하고자 합니다. 기존의 연구들은 특정 소프트웨어를 설치하고 실제 환경을 실행해야만 데이터를 수집할 수 있어, 다양한 소프트웨어 환경과 전문적인 워크플로우를 포괄하는 데 한계가 있습니다. 이러한 환경 제약은 모델이 복잡한 사용자 의도를 이해하고 다양한 GUI 상태에 일반화하는 능력을 저해합니다. 저자들은 소프트웨어를 실제로 실행하지 않고도 Pretrained Image Generator를 GUI Visual World Model로 활용하여, 대규모의 시각적 궤적을 합성하는 효율적인 프레임워크를 제안합니다 [Figure 1].
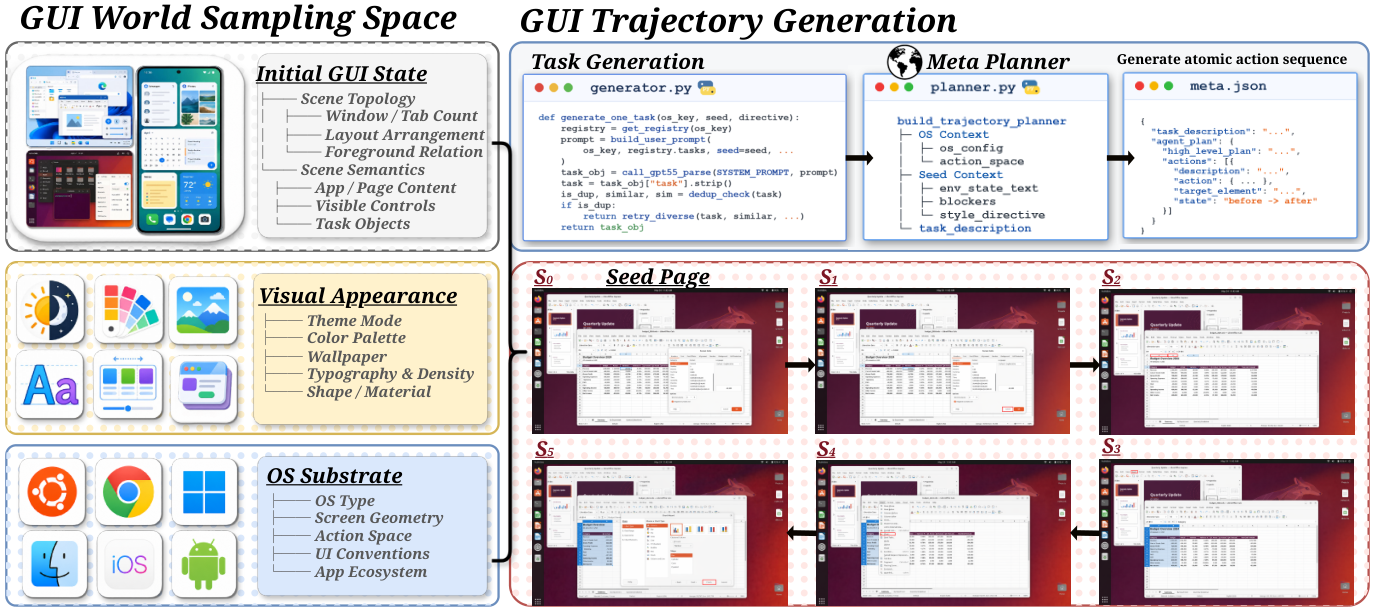
Figure 1 — AutoGUIWorld의 전체 아키텍처
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 GUI Trajectory 생성을 위해 Meta Planner와 Image2(Visual World Model)를 결합한 AutoGUIWorld를 제안합니다. Meta Planner는 작업 지시사항(Task Instruction)을 바탕으로 Atomic Action과 시각적 변화 지점을 계획하며, Voyager는 현재 스크린샷과 planned action을 바탕으로 다음 장면을 생성하기 위한 프롬프트를 구성합니다. 이후 Image2 모델이 해당 프롬프트를 이용해 현재 화면을 수정하여 다음 상태의 스크린샷을 생성하는 closed-loop 방식의 rollout을 수행합니다 [Figure 2]. 최종적으로 약 79,266개의 Grounded 및 필터링된 Step-level 데이터를 구축하였습니다. 실험 결과, Qwen3.5-35B-A3B 모델을 AutoGUIWorld로 Fine-tuning 했을 때, OSWorld 벤치마크에서 mean task score가 33.0%에서 40.8%로 향상되었으며, ScienceBoard에서는 task success rate가 14.0%에서 32.2%로 대폭 개선되었습니다.
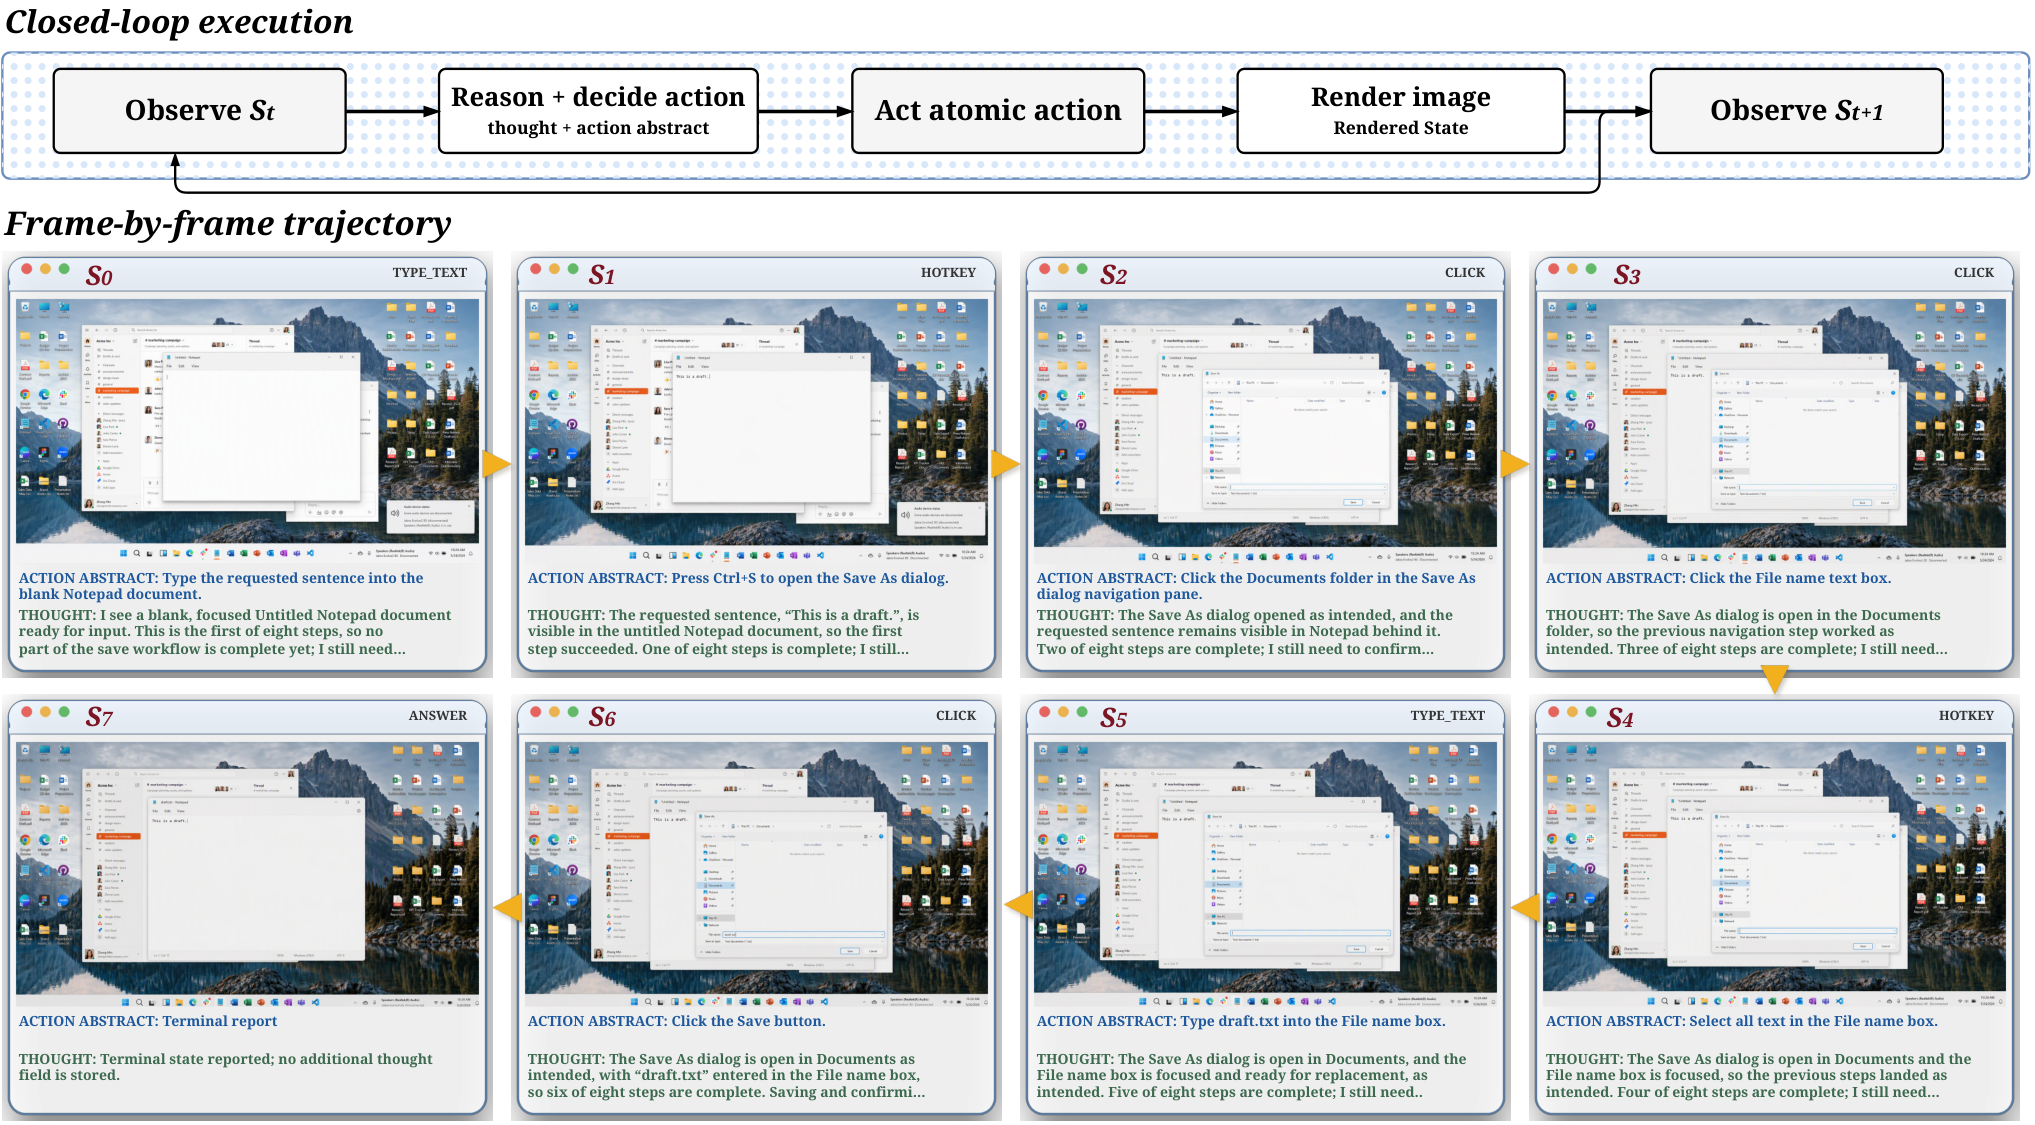
Figure 2 — Voyager 기반 렌더링 과정
4. Conclusion & Impact (결론 및 시사점)
본 연구는 이미지 생성 모델이 단순한 이미지 합성을 넘어 GUI Agent의 복잡한 시각적 환경을 이해하고 시뮬레이션할 수 있는 효과적인 World Model이 될 수 있음을 입증했습니다. AutoGUIWorld를 통해 구축된 대규모의 고품질 합성 데이터는 실제 소프트웨어 환경의 배포 부담 없이도 에이전트의 성능을 유의미하게 향상시킬 수 있습니다. 이 연구는 학계 및 산업계에서 더욱 범용적이고 복잡한 소프트웨어 환경을 다룰 수 있는 차세대 GUI Agent 개발을 가속화할 중요한 기틀을 마련했습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Recovering Policy-Induced Errors: Benchmarking and Trajectory Synthesis for Robust GUI Agents
- [논문리뷰] Intern Lumina U2: A Multi-Codebook Diffusion Large Language Model for Omni-Visual Understanding and Image Generation
- [논문리뷰] APEX: Asynchronous Prefix Denoising for Extreme Compression
- [논문리뷰] Work2Skill: Capturing Human GUI Experience for Reusable Agent Skill Induction
- [논문리뷰] MixTok: Adaptive Visual Tokenization with Global 1D Tokens and Sparse 2D Refinement
Review 의 다른글
- 이전글 [논문리뷰] AutoDataBench: A Data-centric Testbed for Accelerating Auto Research
- 현재글 : [논문리뷰] AutoGUIWorld: Image Generators as Visual World Models for GUI Agent
- 다음글 [논문리뷰] Benchmarking and Enhancing Skill-Level Memory for Partially Observable Robotic Manipulation
댓글