[논문리뷰] Multimodal Flow: Unified Flow Modeling of Language and Vision in Embedding Spaces
링크: 논문 PDF로 바로 열기
메타데이터
저자: Hongyuan Tao, Xinggang Wang, Lianghui Zhu, Yongkang Li, Yunchao Wei, Bin Feng, Shaoyu Chen, Qian Zhang, Chang Huang, Kai Yu
1. Key Terms & Definitions (핵심 용어 및 정의)
- Multimodal Flow: 언어와 시각 데이터를 공통의 embedding space 내에서 연속적으로(continuously) 생성하는 통합 생성 모델링 프레임워크입니다.
- Hyperchunks: 텍스트 블록과 이미지를 각각 독립적인 단위로 인코딩한 연속적 표현으로, 텍스트의 토큰 순서와 이미지의 공간적 구조를 보존합니다.
- Chunk-Causal Flow Backbone: 앞선 hyperchunk들을 조건으로 활용하여 현재 타겟 chunk를 예측하는 구조로,
Flow Matching목적 함수를 통해 학습됩니다. - Flow Matching: 노이즈와 데이터 간의 확률 경로(probability path)를 설정하고 이를 따르는 벡터 필드를 학습하여 연속적인 데이터를 생성하는 기술입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 통합 멀티모달 모델들이 겪는 표현적 제약과 생성 과정의 불일치 문제를 해결하기 위해 제안되었습니다 [Figure 1]. 기존 모델들은 이미지를 이산화(quantization)하여 시각적 정보를 손실하거나, 언어(이산적)와 이미지(연속적)를 처리하는 목적 함수와 샘플링 절차를 분리하여 운영하는 한계를 가집니다. 이러한 접근 방식은 멀티모달 생성의 완전한 연속성을 저해하며 데이터의 충실도와 구조적 보존을 어렵게 만듭니다. 저자들은 언어와 시각이 각각의 고유한 표현 공간을 유지하면서도, 하나의 생성 공정(generative process)과 목적 함수를 공유하는 완전 연속적인 멀티모달 생성 모델의 필요성을 역설합니다.
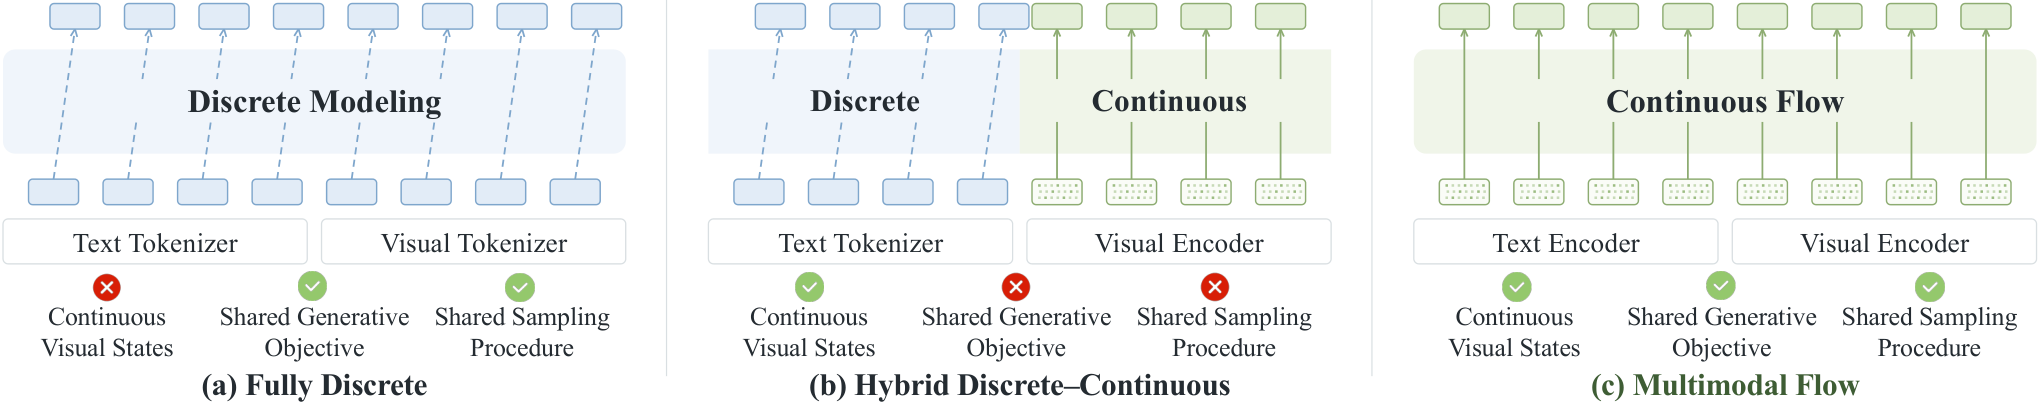
Figure 1 — 멀티모달 모델링 패러다임 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 다양한 멀티모달 태스크를 순차적 hyperchunk 시퀀스로 정형화하고, 이를 Chunk-Causal 구조로 처리하는 새로운 프레임워크인 Multimodal Flow(MF-1)를 제안합니다 [Figure 2]. 제안된 모델은 modality-specific 인코더를 통해 데이터를 hyperchunk로 변환한 뒤, joint attention을 사용하여 cross-modal 상호작용을 수행합니다. 학습 시에는 Flow Matching 목적 함수를 통해 여러 타겟 chunk를 병렬로 예측하며, 추론 시에는 학습된 벡터 필드를 따라 순차적으로 생성합니다 [Figure 3]. 실험 결과, 1.6B 파라미터 규모의 MF-1은 150B 토큰의 사전 학습만으로 GenEval 및 DPG-Bench에서 평균 82.8점, VQAv2, MMBench, POPE에서 평균 75.3점의 경쟁력 있는 성능을 달성했습니다. 특히, 동일한 파라미터 및 데이터 예산 조건에서 기존의 이산적 모델이나 하이브리드 모델 대비 더 우수한 정량적 성능을 보여주었습니다 [Table 4].
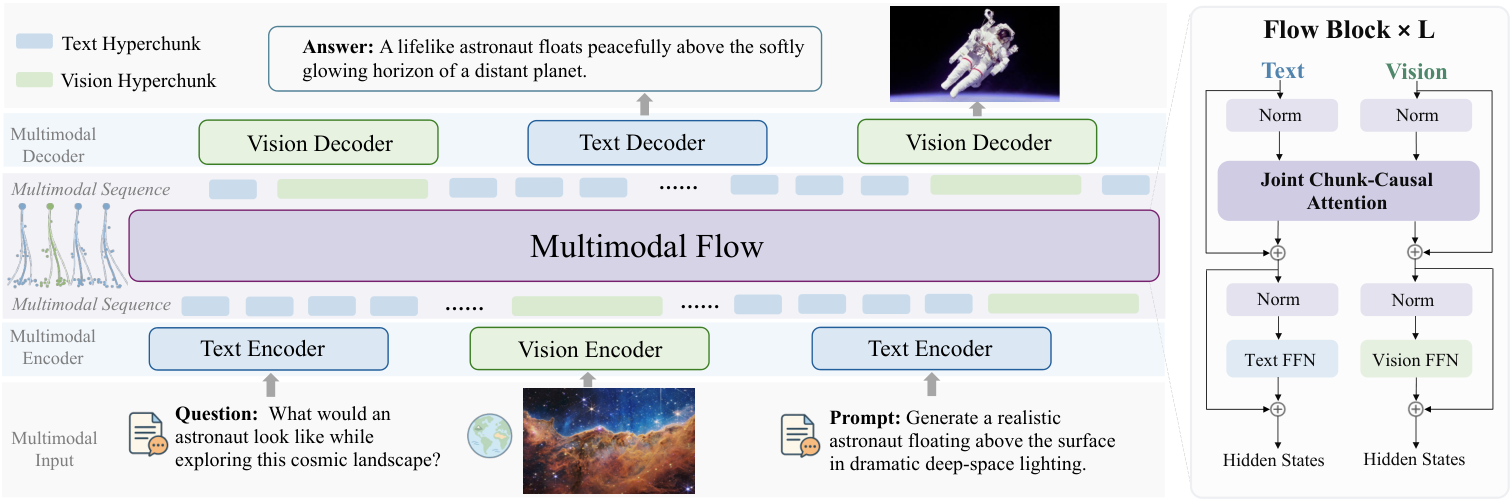
Figure 2 — Multimodal Flow 아키텍처
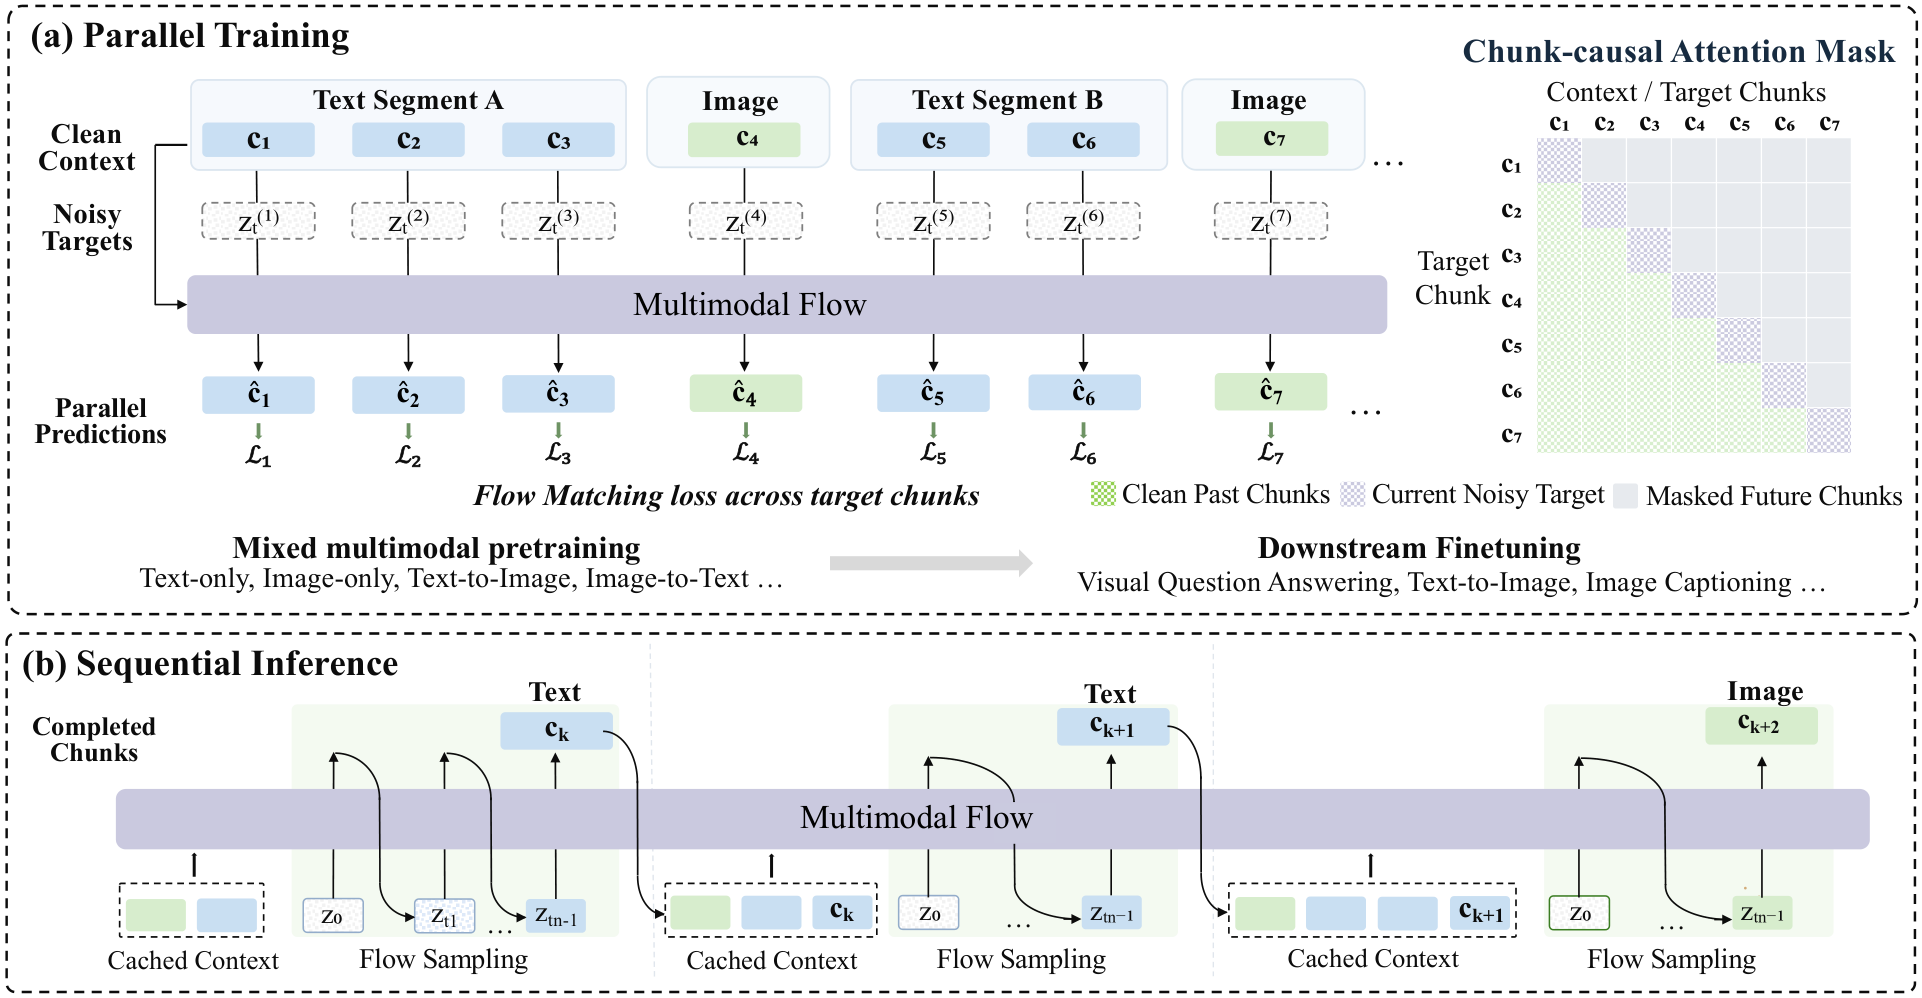
Figure 3 — 학습 및 추론 과정
4. Conclusion & Impact (결론 및 시사점)
본 연구는 텍스트와 이미지를 연속적인 hyperchunk embedding으로 모델링하는 것이 효율적인 통합 멀티모달 생성 패러다임임을 입증했습니다. 제안된 MF-1은 modality-specific 구조와 shared generative backbone을 결합하여 멀티모달 이해와 생성을 하나의 프레임워크로 통합하는 데 성공했습니다. 이 연구는 멀티모달 모델링 분야에서 이산화의 제약에서 벗어난 새로운 기술적 방향을 제시하며, 향후 비디오 및 인터리브 시퀀스와 같은 복합적인 데이터 구조로의 확장 가능성을 열어두었습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] EmbodiedOneVision: Interleaved Vision-Text-Action Pretraining for General Robot Control
- [논문리뷰] LensErase: A Foundation Model for Erase Anything
- [논문리뷰] LeWAM: End-to-End World and Action Modeling with JEPAs
- [논문리뷰] SepGen: Multi-Stem Audio-Video Separation and Generation in a Single Model
- [논문리뷰] Learning Representations to Guide Pixel Diffusion Transformers
Review 의 다른글
- 이전글 [논문리뷰] Make Sparse Rewards Count: Density-Aware Reward Aggregation for Multi-Reward RL
- 현재글 : [논문리뷰] Multimodal Flow: Unified Flow Modeling of Language and Vision in Embedding Spaces
- 다음글 [논문리뷰] Omni-Embed-Mini: Binding Modalities Without Forgetting via Dense Distillation
댓글