[논문리뷰] OneStreamer: Unifying Perception, Memory, and Proactive Response in Streaming Video Interaction
링크: 논문 PDF로 바로 열기
저자: Xiangyu Zeng, Yuandong Yang, Zhiqiu Zhang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Streaming Video LLM: 실시간으로 유입되는 비디오 스트림의 시각적 증거를 해석하고, 미래 쿼리의 관련성을 알지 못한 채 재사용 가능한 사실적 메모리를 형성하며, 가용한 증거를 기반으로 적시에 응답하는 대규모 언어 모델이다.
- Proactive Hierarchical Caption Memory (PHCM): OneStreamer의 핵심 메모리 메커니즘으로, 관찰된 비디오 콘텐츠로부터 시간 기반의 local-detail captions과 완료된 이벤트의 semantic summaries를 생성 및 저장하여, 제한된 시각적 컨텍스트를 보완하고 장기적인 사실적 정보를 제공한다.
- Proactive State Transition Learning (PSTL): 스트리밍 모델이 메모리 기록 또는 작업 응답 시점을 결정하도록 돕는 학습 방법론으로, 반복되는 waiting states의 지배를 줄이기 위해 모든 output anchors와 대표적인 state-change 및 state-persistence tokens에 대한 supervision을 유지한다.
- Proactive Generation: 시스템이 단순히 사용자의 쿼리에 응답하는 것을 넘어, 관찰된 증거를 재사용 가능한 사실적 기록으로 전환하고, 충분한 증거가 확보되면 적절한 시점에 응답을 생성하는 과정을 의미한다.
- Recent-NN FIFO: Streaming Video LLM에서 최신 NN 프레임에 해당하는 시각적 토큰만을 유지하는 sliding window 메커니즘으로, 제한된 시각적 컨텍스트 용량 내에서 실시간 인식을 가능하게 한다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Streaming video LLMs가 미래 작업에 대한 관련성을 알기 전에 증거를 보존하고 충분한 증거가 가용해졌을 때 응답해야 하는 과제에 직면해 있음을 지적한다. 기존 memory mechanisms은 장거리 시각적 증거를 압축하거나 검색하여 접근 가능한 이력을 확장하지만, 보존된 과거 시각적 토큰이 제한된 컨텍스트 용량 내에서 최근 관찰과 경쟁하여 real-time perception을 약화시킬 수 있다. 또한, streaming thinking methods는 진화하는 추론을 유지하지만, 이러한 추론 흔적이 미래 작업에 재사용 가능한 time-grounded factual records 역할을 하지 못할 수 있다. State-token-based response control은 proactive outputs를 가능하게 하지만, 이러한 토큰에 대한 dense supervision은 응답 결정에 비해 반복되는 silence labels를 과도하게 강조할 수 있다. 이러한 한계점들은 real-time perception을 저해하지 않으면서 재사용 가능한 사실적 메모리를 형성하고, 가용한 증거가 응답을 정당화할 때를 학습하는 핵심적인 과제를 부각시킨다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 query-independent evidence recording과 task response를 Proactive Generation이라는 공유된 생성 프로세스를 통해 통합하는 OneStreamer를 제안한다. 핵심 방법론인 Proactive Hierarchical Caption Memory (PHCM)는 이미 관찰된 시각적 콘텐츠로부터 시간 정렬된 local-detail captions과 완료된 이벤트의 semantic summaries를 생성하여, 과거 시각적 피처를 재방문하지 않고도 현재 시각적 윈도우와 함께 장거리 사실적 컨텍스트를 제공한다. 이와 동시에 Proactive State Transition Learning (PSTL)은 모든 output anchors에 대한 supervision을 유지하고 대표적인 state-change 및 state-persistence tokens를 선택함으로써, 반복적인 waiting states의 지배를 줄여 proactive response 학습의 효율성을 높인다. [Figure 3]은 OneStreamer의 전체 아키텍처를 보여주며, Recent visual tokens와 hierarchical caption memory가 어떻게 통합되는지 설명한다.
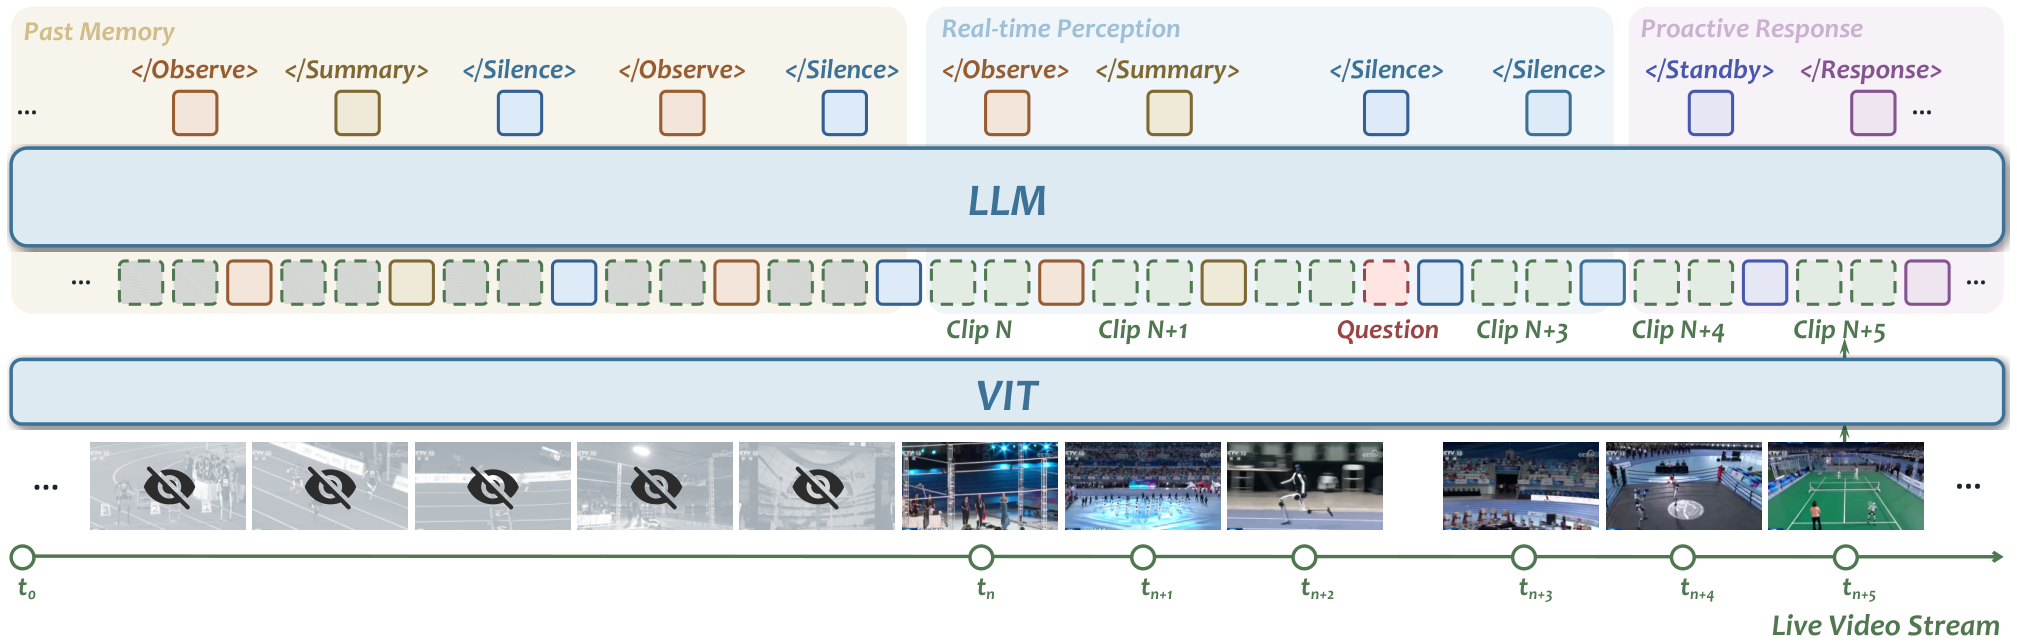
Figure 3 — OneStreamer 아키텍처
저자들은 또한 streaming data synthesis pipeline을 개발하여 offline video resources를 streaming training sequences로 변환했으며, 이를 통해 OneStreamer-1M이라는 방대한 streaming video interaction dataset을 구축했다. [Figure 5]는 이 데이터 합성 파이프라인과 OneStreamer-1M의 task composition을 시각적으로 제시한다. 실험 결과, 4B OneStreamer 모델은 평가된 8개의 모든 streaming video understanding benchmarks에서 최상의 결과를 달성했다. [Figure 1]에서 볼 수 있듯이, OVOBench에서 72.1, StreamingBench Real-Time에서 86.9, OVBench에서 66.8, ODVBench에서 71.3의 집계 점수를 기록하며, 4B Qwen3-VL base model 대비 평균 25.0%, 기존 최강 모델 대비 6.1%의 상대적 개선을 보였다. 특히, ablations는 proactively generated captions를 유지하는 것이 real-time perception 저하 없이 historical QA 성능을 향상시킨다는 것을 보여주었다. 예를 들어, OVOBench-Backward에서 ASI 점수는 63.5에서 71.6으로, EPM은 62.0에서 62.6으로 개선되었다. PSTL은 annotated state tokens의 27.5%만을 감독했음에도 불구하고 dense state supervision을 능가했으며, ProactiveVQA에서 48.7, OmniMMI에서 36.6, OVO-Timing에서 41.6의 최고 점수를 달성했다. 효율성 측면에서, PHCM은 full visual history를 유지하는 것 대비 context length를 93.1%, GPU memory를 60.4% 감소시켰고, TTFT를 4.560초에서 0.124초로 단축시켰다.
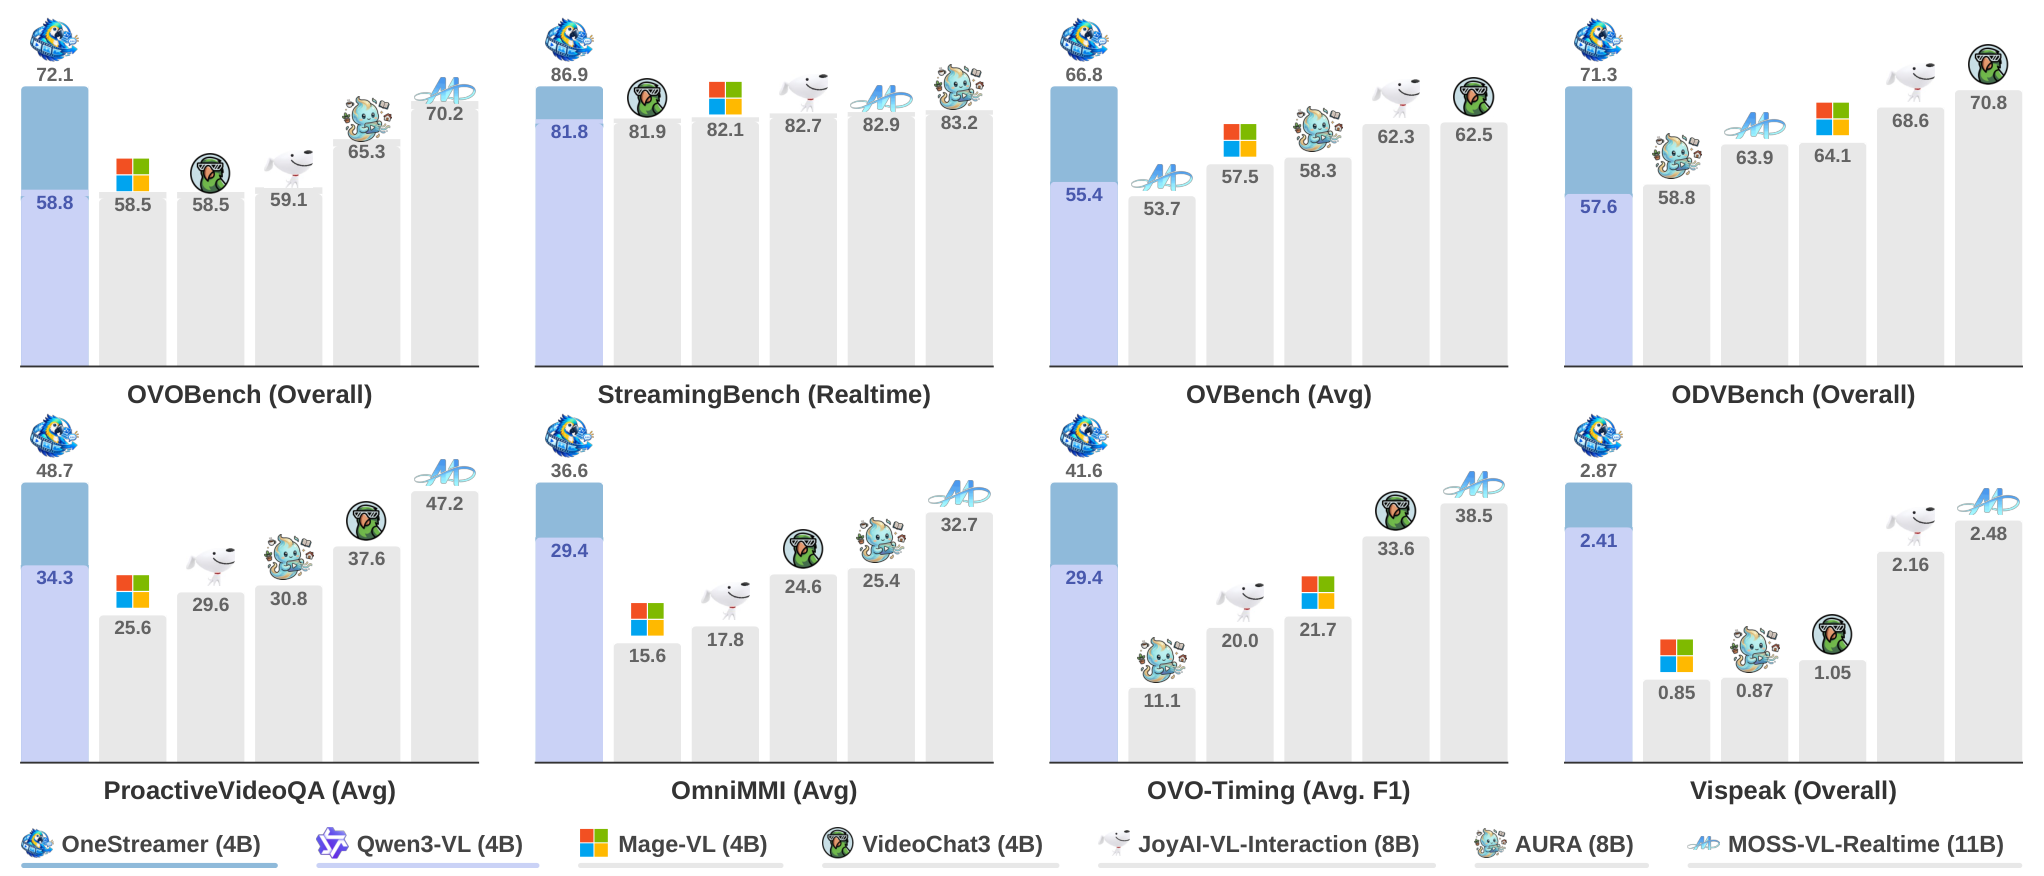
Figure 1 — 벤치마크 평가 결과
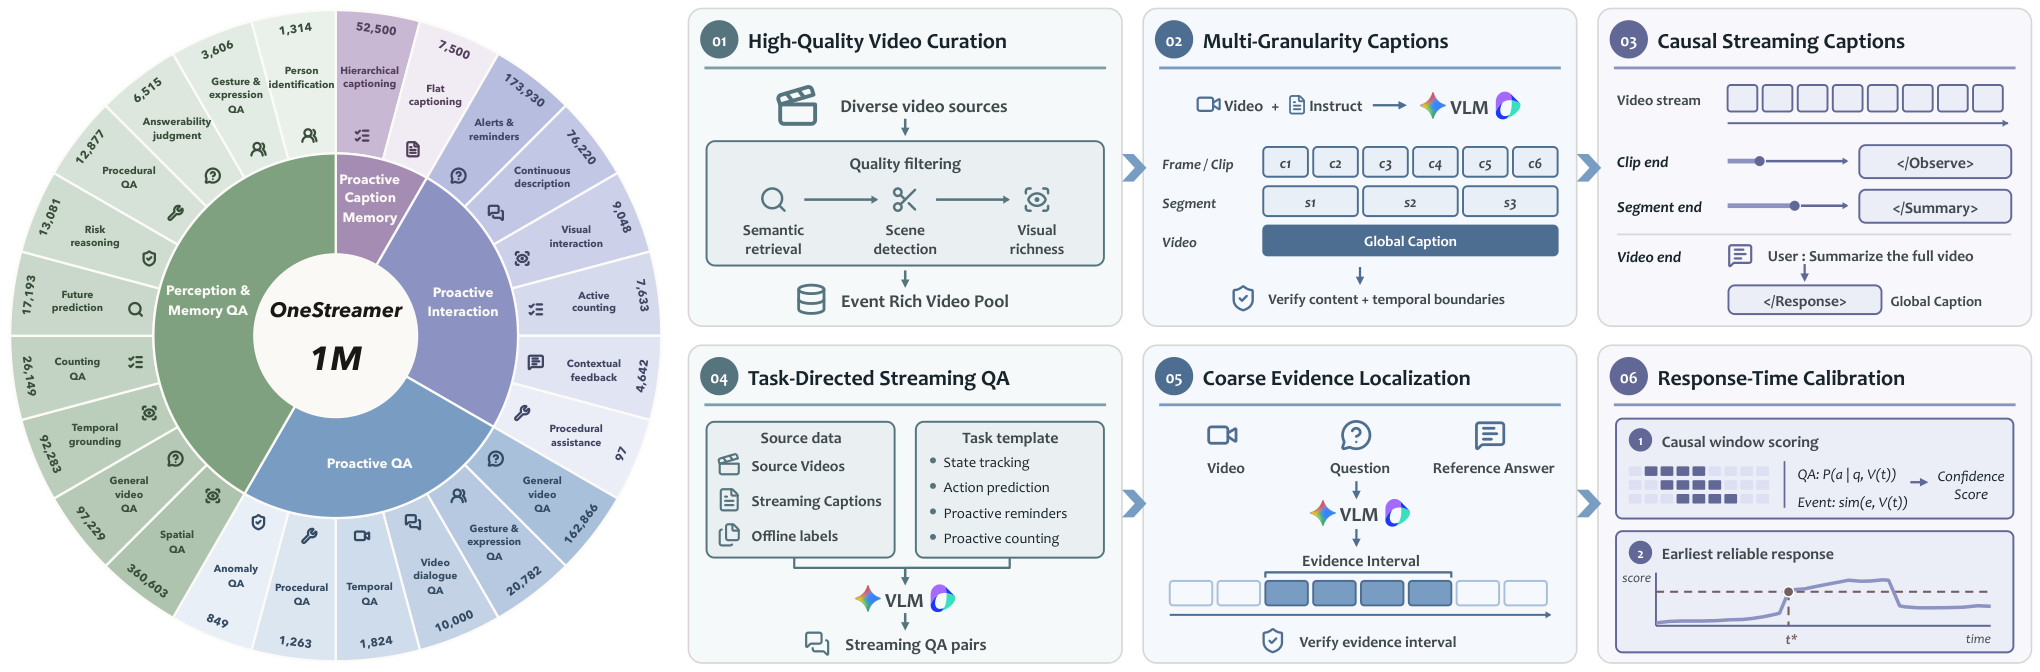
Figure 5 — 데이터 합성 파이프라인
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Proactive Generation을 통해 query-independent evidence recording과 task response를 공동으로 학습하는 streaming video LLM인 OneStreamer를 제시한다. PHCM은 관찰된 콘텐츠를 time-grounded local-detail captions 및 event summaries로 변환하여 recent visual window를 보완하고, PSTL은 state-change 및 state-persistence tokens에 대한 선택적 supervision을 통해 response timing을 최적화한다. 이 연구는 streaming video interaction 분야에서 perception, memory formation, timely response를 통합하는 새로운 shared learning interface로서 proactive generation의 중요성을 강조한다. OneStreamer는 live-stream assistants, wearable agents, security monitoring systems와 같이 실시간 비디오 스트림을 이해하고 적시에 반응해야 하는 다양한 실제 애플리케이션에 상당한 영향을 미칠 것으로 예상된다. 이 모델의 높은 성능과 효율성은 미래의 streaming multimodal AI systems 개발을 위한 강력한 기반을 제공한다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Beyond Dyadic Memory: Interaction-Aware Multimodal Memory with Adaptive Agentic Retrieval for Multi-Party Spoken Conversations
- [논문리뷰] Super Star: Towards Streaming Real-time Interactive Agents for Digital Humans
- [논문리뷰] From Seeing to Acting: Smart Glasses as First-Person Intelligence Platforms
- [논문리뷰] MobileMem: Learning from a Year of Mobile Experiences
- [논문리뷰] Towards Interactive Intelligence for Digital Humans
Review 의 다른글
- 이전글 [논문리뷰] On-Policy or Off-Policy Learning? A Systematic Study of Distillation Dynamics
- 현재글 : [논문리뷰] OneStreamer: Unifying Perception, Memory, and Proactive Response in Streaming Video Interaction
- 다음글 [논문리뷰] OpenTumorBoard: A Real-World Benchmark of Multidisciplinary Tumor Board Discussion Trajectories
댓글