[논문리뷰] Memory as Weights: Internalizing Long-Term History for Streaming Videos
링크: 논문 PDF로 바로 열기
저자: Zhuoming Liu, Jinhong Lin, Lin Zhang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- MaLoW (Memory as LoRA Weights): Streaming VLM을 위한 프레임워크로, historical context를 VLM의 evolving lightweight parameter updates (LoRA weights)로 internalize한다. History는 weights로, current observation은 input으로 분리하여 처리한다.
- HyperNetwork: Recurrent 방식으로 LoRA weights를 효율적으로 생성하고 업데이트하는 데 사용되는 neural network이다.
- LoRA (Low-Rank Adaptation): Pretrained large models의 파라미터를 효율적으로 adaptation하기 위한 low-rank matrix updates 기법이다.
- Streaming VLM: 연속적인 input video stream을 실시간으로 처리하고 user query에 응답하여, 과거 정보를 통합하고 현재 상황을 해석하며 미래 이벤트를 예측하는 Vision-Language Model을 의미한다.
- MaLoW-Instruct: Streaming video understanding을 위해 구축된 대규모 훈련 데이터셋으로, 381K개의 question-answer (QA) 쌍과 56K개의 비디오로 구성되어 있다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
Streaming Vision-Language Models (VLMs)은 과거 정보를 지속적으로 통합하면서도 현재 observation과 user query에 실시간으로 반응해야 하는 근본적인 문제에 직면한다. 기존 memory 메커니즘은 historical observation을 압축, 검색, 또는 캐시하여 input context로 재도입하는데, 이는 historical memory와 current observation이 제한된 context window를 놓고 경쟁하게 만드는 한계를 가진다. 이러한 방식은 memory footprint가 증가하고, 전체 history를 반복적으로 재계산해야 하며, current observation 처리를 방해하고, 상당한 inference overhead를 유발할 수 있다. 따라서 streaming VLM은 memory footprint를 효율적으로 유지하면서도 incrementally하게 진화하고, 현재 observation과 독립적으로 historical 정보를 통합하며, 최소한의 inference overhead를 가지는 새로운 memory 메커니즘이 필요하다. 본 연구는 이러한 한계를 극복하기 위해 history를 모델 weights에 직접 internalize하는 MaLoW 프레임워크를 제안한다 [Figure 1].
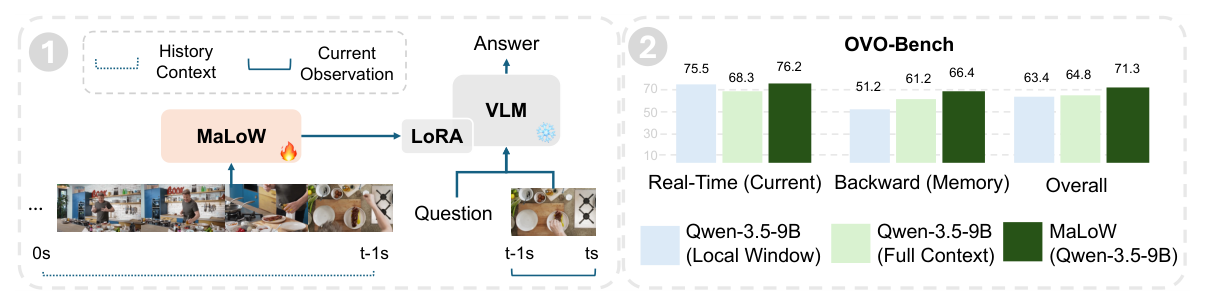
Figure 1 — MaLoW의 핵심 개념 아키텍처와 Memory-input 분리 전략의 이점을 보여주는 주요 다이어그램 및 성능 그래프
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 historical context를 VLM의 evolving lightweight parameter updates인 LoRA weights로 internalize하는 MaLoW를 제안한다. MaLoW는 recurrent HyperNetwork를 사용하여 들어오는 비디오 observation을 fixed-size LoRA weights로 점진적으로 통합하며, 이를 통해 전체 비디오 스트림을 재방문할 필요 없이 누적된 history를 다음 단계로 전달한다. 구체적으로, MaLoW는 compact representation으로 압축된 비디오 클립과 텍스트 context를 사용하여 recurrent hidden states를 업데이트하며, local temporal dependencies 모델링을 위한 State-Space Model과 global historical semantics 보존을 위한 gated summation branch의 두 가지 parallel branch를 유지한다. 이 hidden states는 LoRA weights로 매핑되어 VLM에 적용된다.
실험 결과, MaLoW는 여러 streaming video benchmarks에서 state-of-the-art 성능을 달성했다. 특히 OVO-Bench의 backward split에서 MaLoW는 기존 memory 접근 방식 대비 3.9%~11.8% 더 높은 성능을 보였으며, 단지 23ms의 미미한 latency overhead (전체 inference time의 15% 미만)만을 추가했다 [Figure 4]. Qwen3.5-9B 기반의 MaLoW는 OVO-Bench의 Episodic Memory (EPM) task에서 63.6%로 모든 비교 모델 중 가장 높은 EPM score를 기록했다 [Table 1]. 또한, MaLoW는 Qwen3-VL-4B 기반으로 StreamingBench에서 84.8%의 state-of-the-art 성능을 달성했다 [Table 1]. MaLoW는 다양한 base VLMs (0.8B에서 11B 파라미터)에 걸쳐 일관된 성능 향상을 보였으며, 기존 백본 아키텍처와 파라미터를 유지하면서 1.4%~4.0%의 추가 파라미터만 도입하는 lightweight memory patch임을 입증했다. Vision-Language-Action (VLA) 모델로의 확장에서도 Simpler WidowX에서 action success rate를 9.3% 향상시켜 일반화 능력을 보였다.
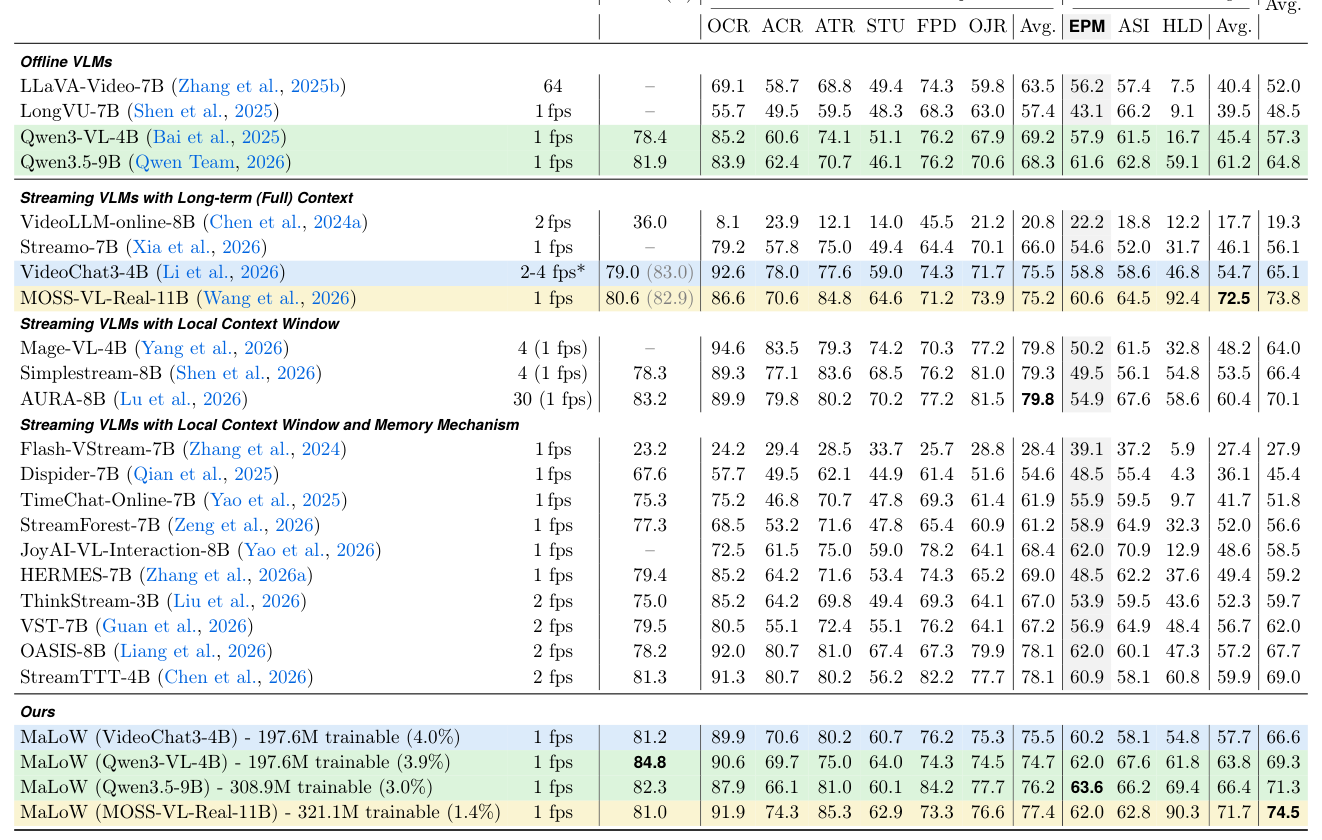
Table 1 — 다양한 스트리밍 비디오 이해 벤치마크에서 MaLoW와 다른 모델들의 정량적 성능을 비교한 핵심 결과 테이블
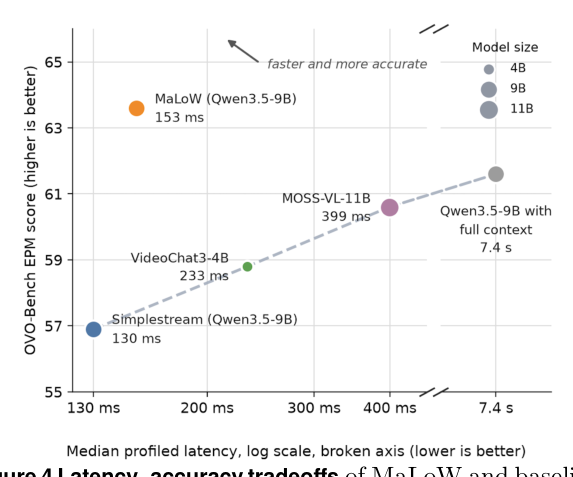
Figure 4 — MaLoW의 inference latency와 memory-critical task 성능 간의 tradeoff를 시각적으로 보여주는 그래프
4. Conclusion & Impact (결론 및 시사점)
본 연구는 streaming VLM을 위한 새로운 memory 프레임워크인 MaLoW를 성공적으로 제안했다. MaLoW는 기존 방식처럼 압축되거나 검색된 history를 input context에 반복적으로 주입하는 대신, history를 VLM의 evolving LoRA weights로 internalize하고 current observation은 input으로 유지하는 독창적인 접근 방식을 채택한다. 이러한 memory와 input의 분리 덕분에 MaLoW는 전체 비디오 스트림을 재방문하거나 context window를 지속적으로 확장할 필요 없이 long-term 정보를 효율적으로 전달할 수 있다. 또한, 이 프레임워크는 lightweight memory patch로서 base VLM 아키텍처와 파라미터를 변경하지 않고 오직 compact LoRA weights만 시간에 따라 진화시킨다. MaLoW는 streaming video understanding 벤치마크에서 강력한 성능을 입증하고 memory-critical task에서 상당한 이득을 제공하며, VLA 모델로 확장되어 action success rate를 향상시키는 등 폭넓은 적용 가능성을 보여주었다. 본 연구는 streaming VLM 분야에서 memory의 저장 및 활용 방식에 대한 새로운 관점을 제시하며, 향후 long-term memory 연구에 중요한 시사점을 제공할 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] VLA-Δ: Learning Physical State Transition for Vision-Language-Action Models
- [논문리뷰] Towards Agentic Robots: Model, Data, Environment, and Harness
- [논문리뷰] Glance Forcing: Making Bidirectional Diffusion Autoregressive at a Glance
- [논문리뷰] SanSi: A Looped Typed Decision Model for System 1.5 Thinking
- [논문리뷰] UniWAM: Unified World-Action Model
Review 의 다른글
- 이전글 [논문리뷰] MLExpert: Towards a Generalist Agentic Model for Autonomous Machine Learning Engineering
- 현재글 : [논문리뷰] Memory as Weights: Internalizing Long-Term History for Streaming Videos
- 다음글 [논문리뷰] Mosaic: Multi-Session Agentic Reinforcement Learning
댓글