[논문리뷰] Mosaic: Multi-Session Agentic Reinforcement Learning
링크: 논문 PDF로 바로 열기
저자: Yilong Xu, Minrui Xu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Agentic Reinforcement Learning (Agentic RL): Large Language Model (LLM) agents가 multi-turn reasoning, tool use, 그리고 외부 환경과의 상호작용을 통해 온라인 rollout 및 reward feedback을 활용하여 학습하는 과정입니다.
- Multi-Session Agentic Reinforcement Learning: 기존 Agentic RL의 single-session 가정을 확장하여, trajectory 내에서 임의의 수의 session을 지원하는 학습 환경입니다. 이는 Context Compaction이나 Subagent Forking과 같은 고급 추론 기술을 포함합니다.
- Context Compaction: 실행 기록을 압축하여 context space를 확보하고, 후속 action을 조건화하는 prefix를 재작성하여 새로운 session을 시작하는 기술입니다.
- Subagent Forking: 전역 목표(global goal)를 subagent에 위임하여 새로운 branch session을 생성하는 기술입니다.
- Session-Aware Trajectory-Level Advantage Estimation: Task outcome에 따라 session count의 within-group ranking을 사용하여 outcome-based advantage를 조정하는 방법론입니다. 이는 성공적인 trajectory는 효율적으로 작업을 해결하도록 유도하고, 실패한 trajectory는 충분한 exploration을 수행하도록 장려합니다.
- Session-Level Advantage Shaping: 각 session의 marginal outcome gain을 즉각적인 reward로 계산하고, session type별로 group-relative normalization을 적용하여 trajectory-level advantage와 결합하는 방법론입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 Agentic Reinforcement Learning(RL) 방법론들이 대부분 single-session trajectory를 가정하여, multi-turn 상호작용이 단일하게 누적되는 context 내에서 진행된다는 한계를 지적합니다. 그러나 Context Compaction 및 Subagent Forking과 같은 LLM agents의 고급 추론 기술들은 자연스럽게 여러 session에 걸친 trajectory를 생성하며, 이는 single-session 학습 가정과 추론 시의 실행 방식 간의 불일치를 초래합니다. 이러한 불일치는 Agentic RL의 일관성을 저해하고 최적화 잠재력을 제한합니다. 기존의 Multi-Session rollout 처리 방식인 Broadcasting은 trajectory-level advantage를 모든 session에 단순히 복제하므로, 각 session의 개별적인 기여도를 구분하지 못하고 session 할당을 효과적으로 안내하지 못하는 문제점이 있습니다. 이로 인해 trajectory가 더 많은 session에 걸쳐질수록 학습 signal의 targeting이 저하됩니다. 저자들은 이러한 한계를 극복하기 위해 Multi-Session Agentic Reinforcement Learning이라는 새로운 setting을 도입하고, Critic-Free Hierarchical Optimization을 통해 Multi-Session LLM agents의 성능을 개선하고자 합니다 [Figure 1].
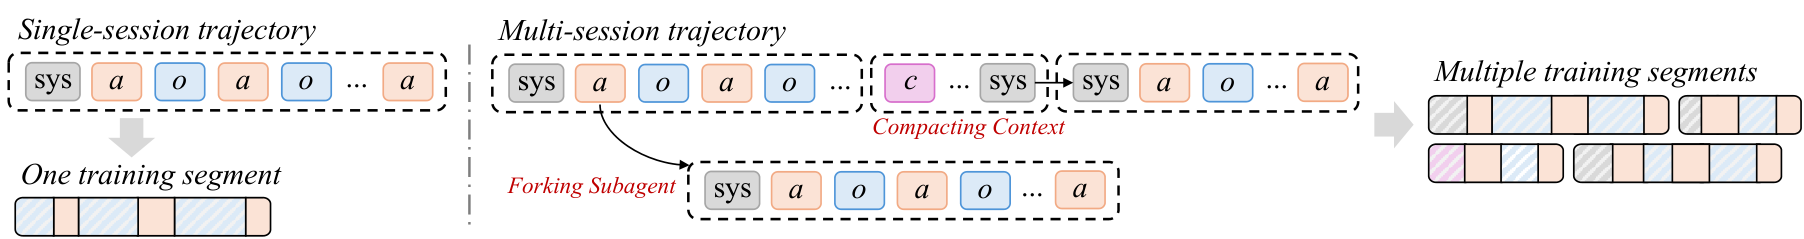
Figure 1 — Multi-session 및 single-session trajectory 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Multi-Session Agentic RL의 최적화를 위해 Mosaic이라는 Critic-Free Hierarchical Optimization 방법론을 제안합니다 [Figure 2]. Mosaic은 크게 두 가지 핵심 구성 요소로 이루어져 있습니다. 첫째, Session-Aware Trajectory-Level Advantage Estimation은 outcome-based advantage를 session 사용 신호로 보정합니다. 이는 task outcome에 따라 session count의 within-group ranking을 활용하여, 성공적인 trajectory는 더 적은 session으로 효율적인 문제 해결을, 실패한 trajectory는 충분한 exploration을 장려합니다. 이 과정에서 session usage signal은 outcome advantage의 부호는 유지하되 magnitude를 조절하여, 동질적인 reward group 내에서 advantage margin을 확장합니다. 둘째, Session-Level Advantage Shaping은 각 session의 marginal outcome gain을 즉각적인 reward로 계산하고, session type(Normal, Compaction, Subagent)별로 group-relative normalization을 적용합니다. 이 Shaping signal은 trajectory-level advantage와 결합되어, 전역적인 outcome-oriented signal과 지역적인 marginal effect를 동시에 반영하는 계층적 최적화 목표를 형성합니다.
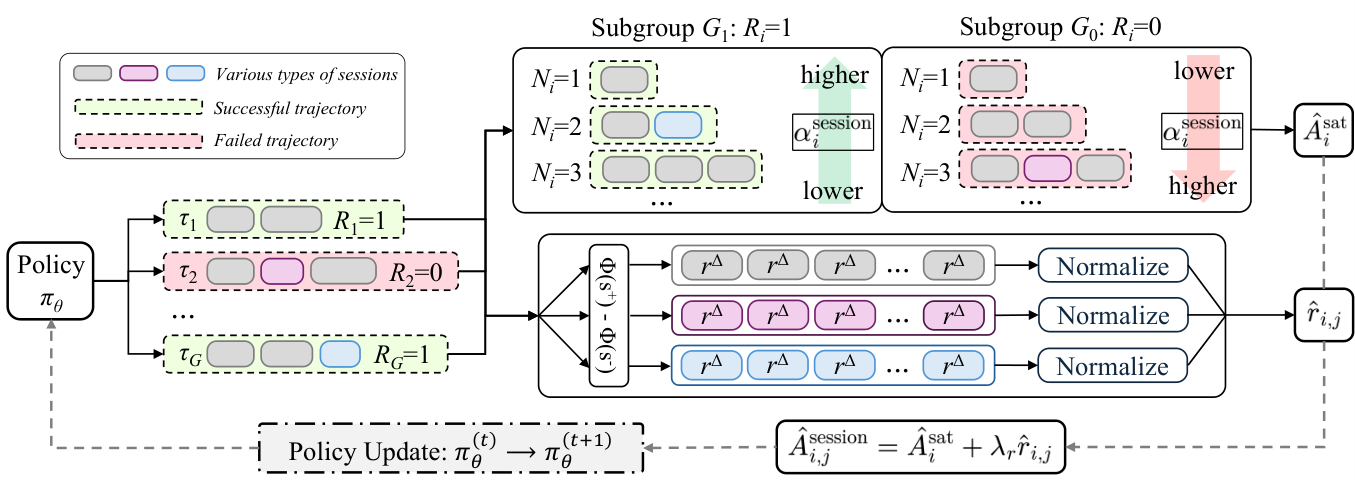
Figure 2 — 제안된 Mosaic 파이프라인 개요
실험은 BrowseComp 벤치마크와 Qwen3.5-4B 모델을 사용하여 수행되었습니다. Mosaic은 Context Compaction 및 Subagent Forking 시나리오 모두에서 Broadcasting을 포함한 여러 single-session 및 multi-session Agentic RL baseline을 능가하는 성능을 보였습니다. 특히, Mosaic은 Broadcasting baseline 대비 Accuracy에서 최대 10.1%의 상대적 개선을 달성했으며, 동시에 trajectory당 평균 session 사용량은 3.17개에서 2.35개로 감소시키는 효율성을 보여주었습니다 [Table 1]. Ablation study를 통해 Session-Aware Trajectory-Level Advantage Estimation과 Session-Level Advantage Shaping 각각이 최종 성능 향상에 기여함이 확인되었습니다 [Figure 3]. 추가 분석 결과, Mosaic은 session utility와 allocation을 개선하여 더 나은 task performance를 달성하며, 이는 Multi-Session Optimization의 효과적인 방향임을 시사합니다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 기존 Agentic RL의 single-session 가정과 Context Compaction 및 Subagent Forking과 같은 고급 추론 기술 간의 불일치를 해결하기 위해 Multi-Session Agentic Reinforcement Learning이라는 새로운 setting을 제안합니다. 저자들은 이러한 setting에서 기존 Broadcasting 방식의 coarse supervision 문제를 극복하기 위해 Critic-Free Hierarchical Optimization 기반의 Mosaic 방법론을 제시합니다. Mosaic은 Session-Aware Trajectory-Level Advantage Estimation과 Session-Level Advantage Shaping을 결합하여, Qwen3.5-4B Agent가 BrowseComp 벤치마크에서 single-session 및 multi-session baseline들을 뛰어넘는 우수한 성능을 달성함을 입증했습니다. 이 연구는 Multi-Session Agentic RL 분야에서 trajectory 내 session의 효율적인 활용과 할당이 성능 향상의 핵심임을 강조하며, 향후 LLM agent가 더 복잡하고 장기적인 task를 해결하는 데 있어 중요한 기반을 제공할 것으로 기대됩니다. 특히, Mosaic이 보여준 session utility 및 allocation 개선은 multi-session agentic RL 연구의 유망한 미래 방향을 제시합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] CUDA Agent: Large-Scale Agentic RL for High-Performance CUDA Kernel Generation
- [논문리뷰] Exploring Reasoning Reward Model for Agents
- [논문리뷰] LongCat-Flash-Thinking-2601 Technical Report
- [논문리뷰] General Agentic Memory Via Deep Research
- [논문리뷰] ERGO: Entropy-guided Resetting for Generation Optimization in Multi-turn Language Models
Review 의 다른글
- 이전글 [논문리뷰] Memory as Weights: Internalizing Long-Term History for Streaming Videos
- 현재글 : [논문리뷰] Mosaic: Multi-Session Agentic Reinforcement Learning
- 다음글 [논문리뷰] OmniCompass: A Holistic Benchmark for Omni-Modal Video Grounding and Understanding
댓글