[논문리뷰] Retrieval-Augmented Skill Optimization via Cross-Harness Adaptation
링크: 논문 PDF로 바로 열기
메타데이터
저자: Jaewon Chu, Ji Soo Lee, Jihwan Park, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Agent Skill: 특정 Execution Harness 환경에서 에이전트가 작업을 효과적으로 수행하도록 가이드하는 재사용 가능한 자연어 기반의 절차적 아티팩트(Artifact)를 의미합니다.
- Cross-Harness Adaptation: 서로 다른 도메인이나 Harness에서 생성된 외부 지식을 타겟 환경의 어휘, 도구, 파라미터 규격에 맞춰 재표현하고 추상화하는 핵심 기술입니다.
- RASI (Retrieval-Augmented Skill Initialization): 에이전트 Rollout 없이도 외부 지식 저장소에서 관련 절차를 검색하고 적응시켜 초기 스킬을 구성하는 단계입니다.
- RASU (Retrieval-Augmented Skill Update): 에이전트의 실행 피드백을 통해 실패 원인을 파악하고, 이에 대응하는 지식을 검색하여 기존 스킬을 반복적으로 정교화하는 단계입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 Skill Optimization 방식들이 방대한 외부 지식 저장소를 활용하지 못하고, 오직 에이전트 자신의 Rollout 경험에만 의존하여 비용이 많이 드는 반복적 정교화 과정을 거친다는 문제를 해결하고자 합니다. 기존 방식들은 수백만 개의 publicly available 스킬이 존재함에도 불구하고, 이를 활용하지 않고 에이전트의 시행착오를 통해 학습하므로 효율성이 저하되는 한계가 있습니다. 특히, 외부에서 검색된 스킬은 타겟 도메인이나 Harness와 불일치(Mismatch)하는 경우가 많아 단순 재사용만으로는 성능 향상을 기대하기 어렵습니다. 저자들은 이러한 제약을 극복하기 위해 외부 지식을 검색하고 타겟 환경에 맞게 적응시키는 새로운 프레임워크인 RASO를 제안합니다 [Figure 1].
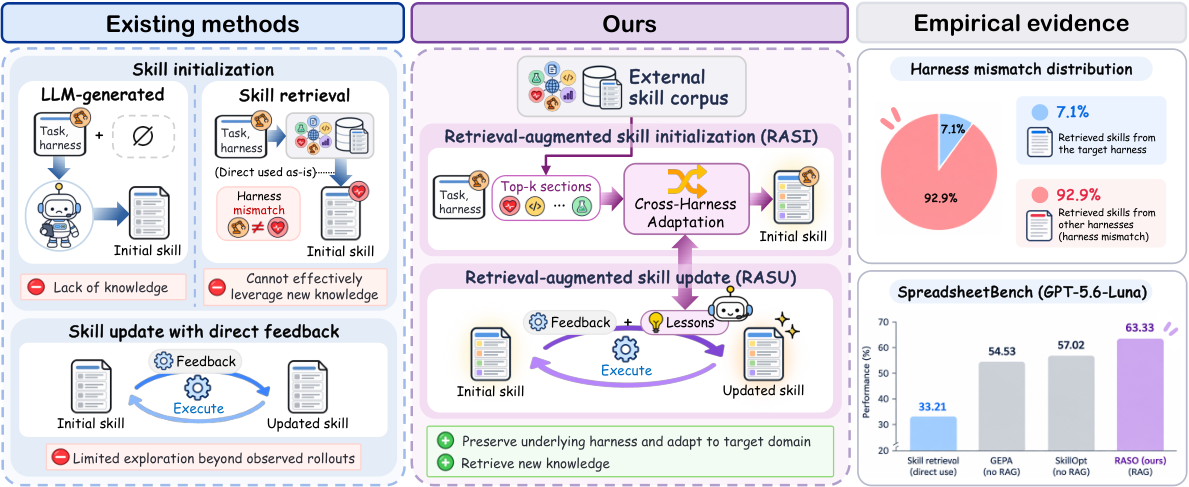
Figure 1 — RASO와 기존 방법론 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 외부 스킬 코퍼스를 활용하여 스킬을 최적화하는 RASO 프레임워크를 제안하며, 이는 RASI와 RASU라는 두 가지 보완적인 단계로 구성됩니다 [Figure 2]. RASI는 작업 및 Harness 설명만으로 초기 스킬을 설계하며, RASU는 실제 실행 후 발생한 피드백을 기반으로 외부 지식을 검색하여 스킬을 지속적으로 개선합니다. 두 단계 모두 Cross-Harness Adaptation을 통해 이질적인 소스 지식을 타겟 환경에 최적화된 형식으로 변환합니다 [Figure 5]. 실험 결과, RASO는 GPT-5.6-Luna와 Qwen-3.5-9B 모델을 사용한 4개의 에이전트 벤치마크(OfficeQA, SpreadsheetBench, ALFWorld, WebShop)에서 기존 baseline들을 압도하는 성능을 보였습니다. 정량적으로 RASI는 검색 기반의 RFSI(Retrieval-Free Skill Initialization) 대비 OfficeQA에서 최대 +5.63 포인트 높은 성능을 기록했으며, RASO 전체 프레임워크는 기존 최강의 최적화 기법(예: SkillOpt, WikiSkill)보다 SpreadsheetBench에서 최대 +6.31 포인트 더 우수한 성능을 달성했습니다 [Table 1]. 이러한 결과는 외부 지식의 활용과 적응적 정교화가 스킬 성능 향상에 결정적임을 입증합니다.
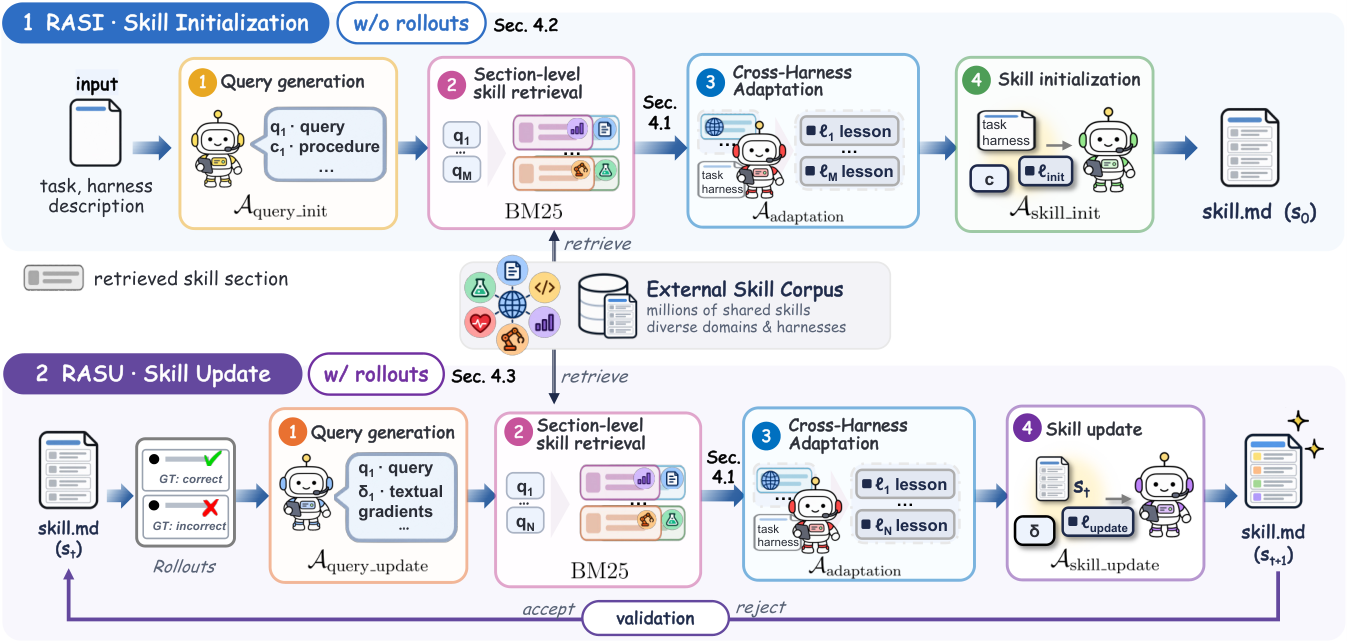
Figure 2 — RASO 전체 프레임워크 아키텍처
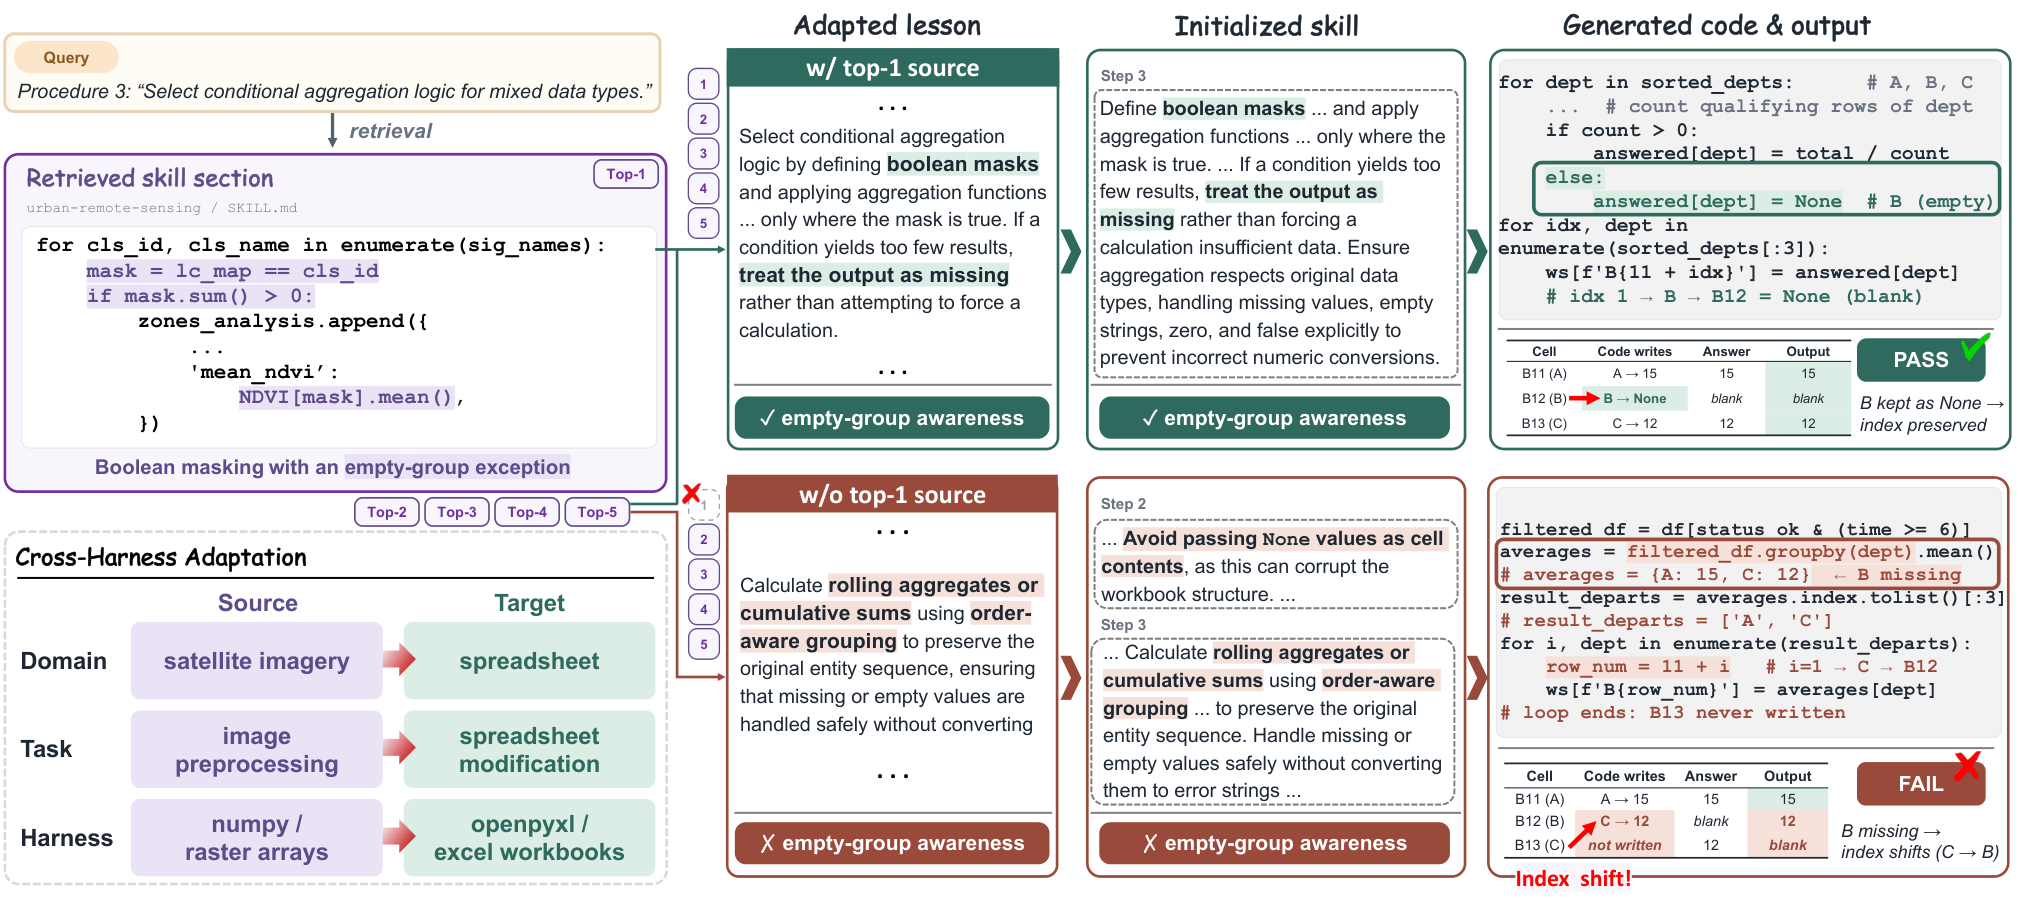
Figure 5 — Cross-Harness Adaptation 정성적 예시
4. Conclusion & Impact (결론 및 시사점)
본 연구는 외부 스킬 코퍼스를 효율적으로 활용하는 RASO를 통해 에이전트 스킬 최적화의 새로운 지평을 열었습니다. 특히 Cross-Harness Adaptation을 통해 도메인 간 지식 전달의 어려움을 해결함으로써, 데이터 효율적인 학습이 가능함을 보여주었습니다. 이 연구는 향후 복잡한 에이전트 태스크 수행 시, 모델의 파라미터 지식에만 의존하지 않고 외부 지식을 능동적으로 검색하고 적응시키는 지능형 에이전트 아키텍처 발전에 중요한 시사점을 제공합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] COBRA-Skills: Contextual Bandit-Guided Evolution for Agent Skill Optimization
- [논문리뷰] Memory for Large Language Models
- [논문리뷰] Skill Self-Play: Pushing the Frontier of LLM Capability with Co-Evolving Skills
- [논문리뷰] Socratic-SWE: Self-Evolving Coding Agents via Trace-Derived Agent Skills
- [논문리뷰] LLM2Vec-Gen: Generative Embeddings from Large Language Models
Review 의 다른글
- 이전글 [논문리뷰] Removing the NEEDLE in the Haystack: Backdoor Removal in LLMs via Weight Orthogonalisation
- 현재글 : [논문리뷰] Retrieval-Augmented Skill Optimization via Cross-Harness Adaptation
- 다음글 [논문리뷰] SILSA: Sliding-Window Slice Latents for Topology-Preserving High-Resolution 3D Generation
댓글