[논문리뷰] 4DCodeBench: Benchmarking Agents on Inverse Graphics of Dynamic Scenes
링크: 논문 PDF로 바로 열기
메타데이터
저자: Ruihong Shen, Žiga Kovačič, Peter Kulits, Xingrui Wang, Zizhang Li, Joshua B. Tenenbaum, Alan Yuille, Jieneng Chen, Jiajun Wu
1. Key Terms & Definitions (핵심 용어 및 정의)
- 4D Inverse Graphics: 비디오 관찰 결과를 바탕으로, 장면의 3D geometry와 시간에 따른 변화(dynamics)를 표현하는 실행 가능한 코드를 생성하여 역으로 그래픽 모델을 복원하는 작업입니다.
- 4D Code: 에이전트가 생성한 실행 가능한 프로그램으로, 장면의 3D geometry를 구성하고 시간 $t$에 따른 상태 변화 $s_{\Gamma}(t)$를 렌더링할 수 있는 일련의 명령어를 지칭합니다.
- Dynamic IoU: 모델이 생성한 재구성 결과와 참조 비디오 간의 움직이는 물체 영역 일치도를 평가하는 정량적 지표입니다.
- Trajectory DTW: 합성 장면에서 물체의 3D 경로가 시간에 따라 어떻게 변화하는지를 ground truth와 비교하여 측정하는 동적 성능 평가 지표입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 멀티모달 코딩 에이전트가 복잡한 물리적 환경의 동역학을 이해하고 이를 실행 가능한 코드로 구현하는 능력을 체계적으로 평가하고자 합니다 [Figure 1]. 기존의 역그래픽(Inverse Graphics) 연구들은 정적 장면 복원에 치중되어 있어, 변형(deformation), 유체 흐름(fluid flow), 파괴(fracture) 등 시간에 따라 변화하는 동적 장면을 처리하는 데 한계가 있습니다. 이러한 동적 장면은 단순히 정적 물체를 배치하는 것을 넘어 물리적 상호작용과 변화하는 geometry를 정확히 모델링해야 하므로, 에이전트가 스스로 적절한 추상화 도구와 시뮬레이션 방식을 선택해야 하는 고차원적인 추론 능력을 요구합니다.
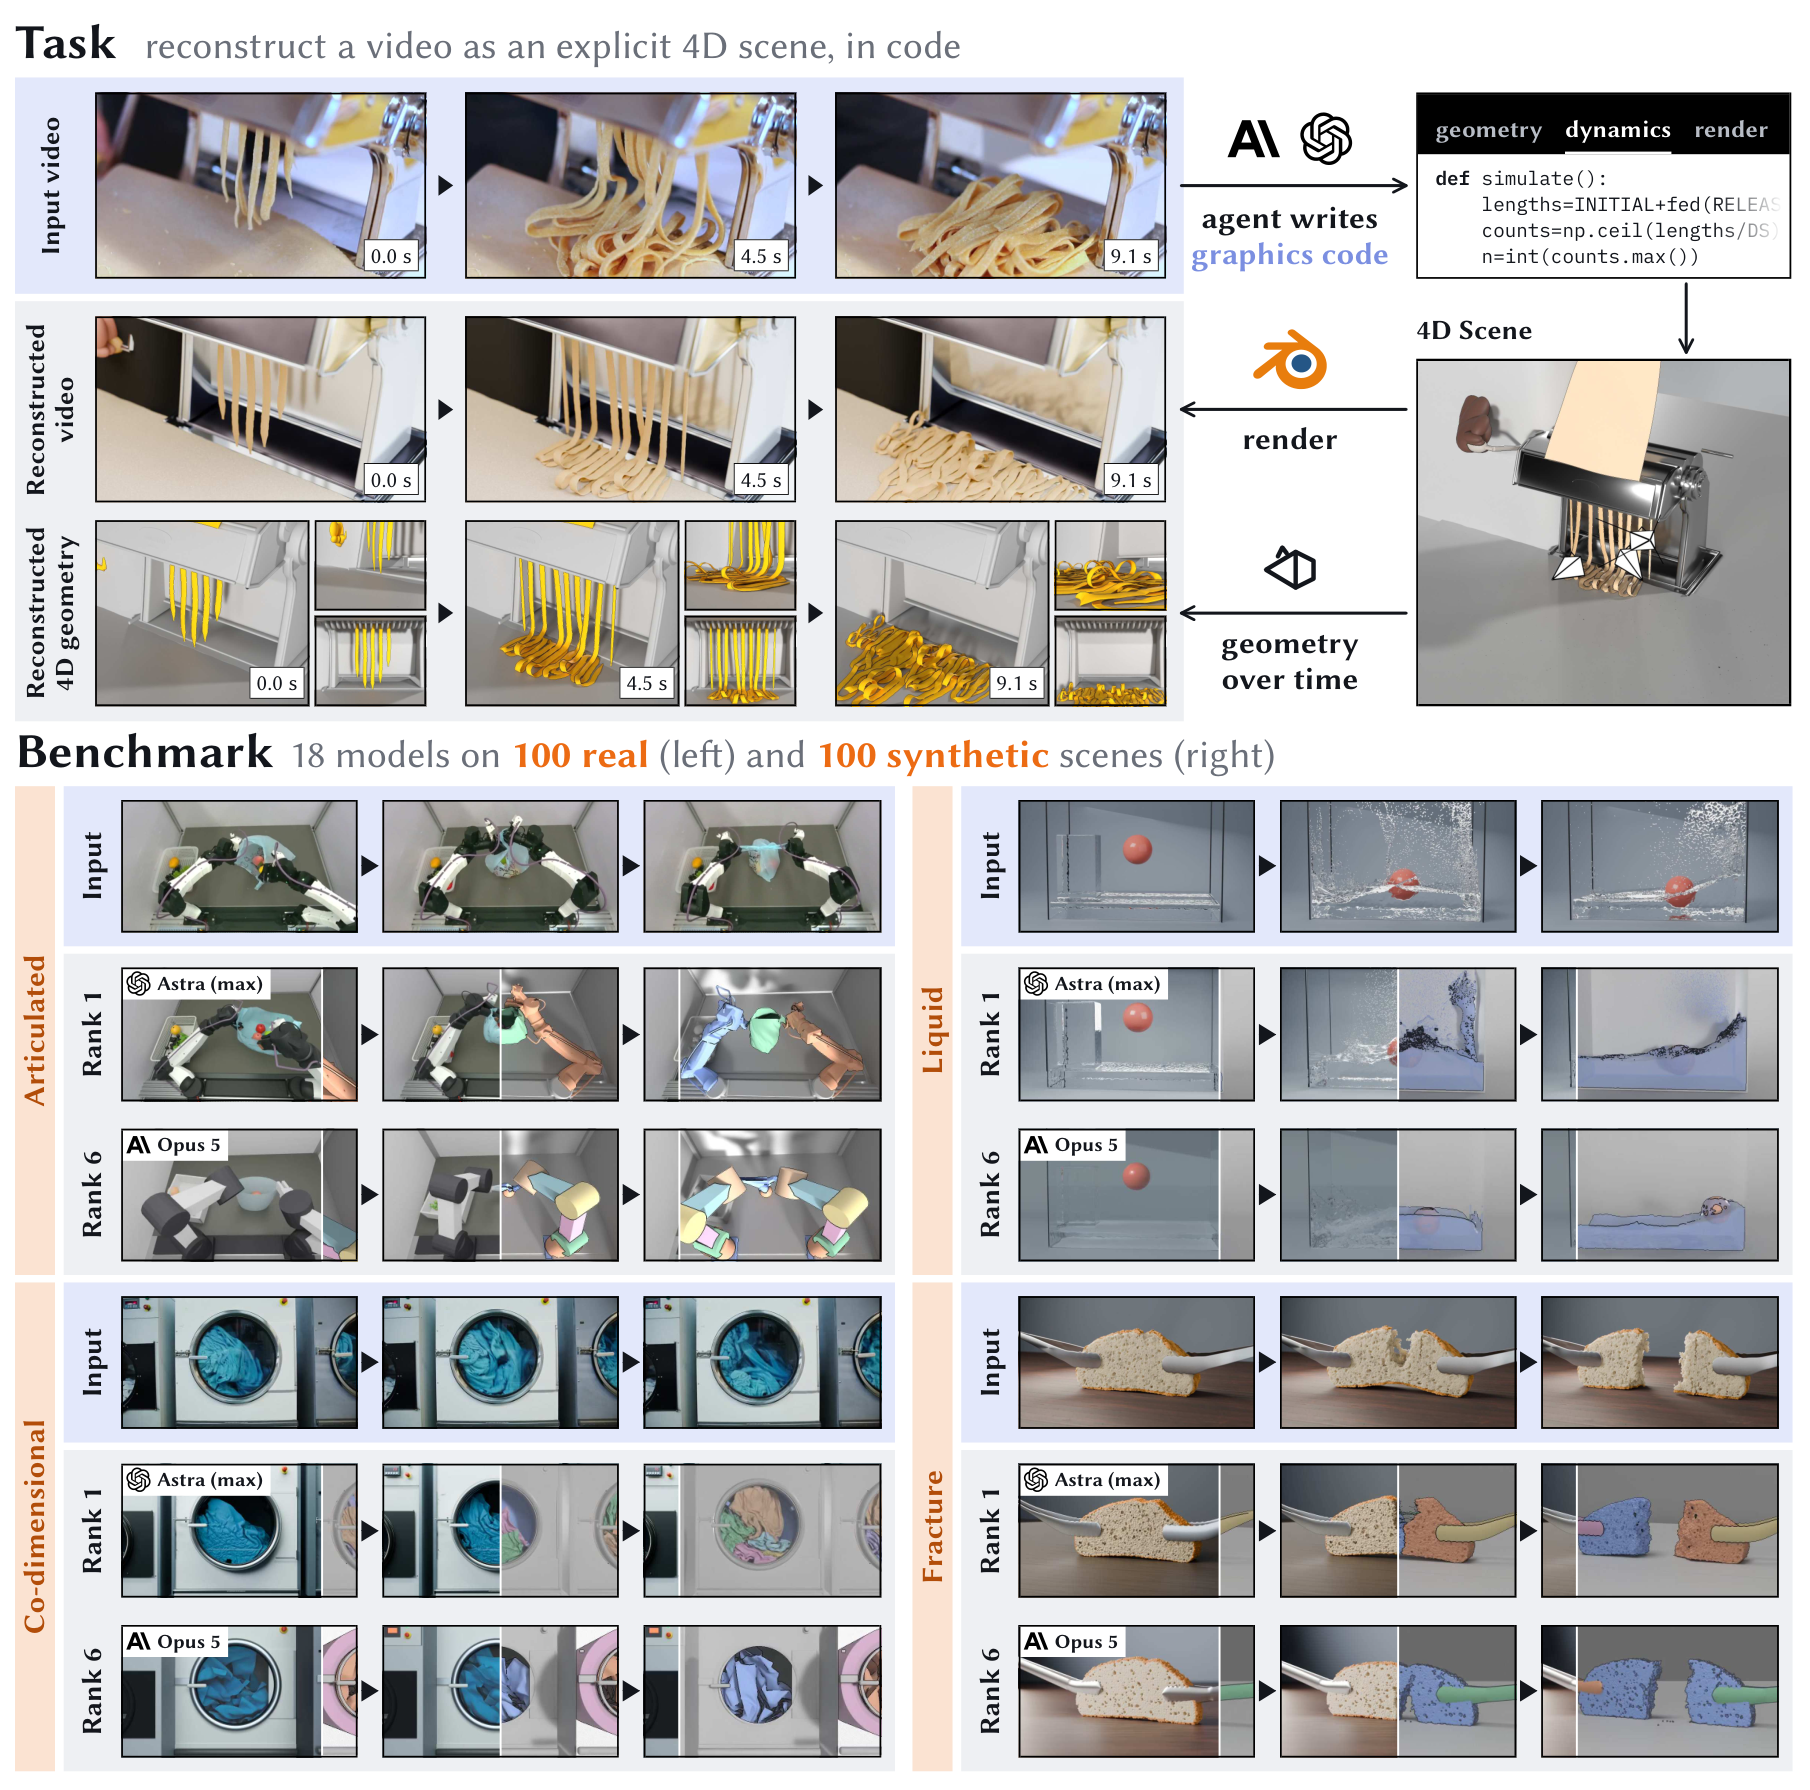
Figure 1 — 4DCodeBench 작업 개요
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 100개의 실제 비디오와 100개의 합성 장면으로 구성된 4DCodeBench를 구축하여 18개의 최신 멀티모달 코딩 에이전트 모델들을 평가합니다. 에이전트는 입력된 비디오를 보고 장면의 물리적 특성을 추론하여 Blender와 호환되는 실행 가능한 코드를 작성해야 하며, 이 과정에서 분석적 움직임(analytic motion) 혹은 물리 시뮬레이션 라이브러리를 자율적으로 선택합니다. 주요 실험 결과, 모델들은 외형(appearance)과 정적 geometry 복원에는 우수한 성능을 보이나, 동역학(dynamics) 재구성 성능은 상대적으로 낮게 나타나며 정적 vs 동적 성능 간의 격차가 뚜렷함을 확인하였습니다 [Figure 8]. 또한, 인퍼런스 타임의 추론 노력(reasoning effort)이 증가할수록 Astra 모델의 2D 및 3D Dynamics 성능이 점진적으로 향상됨을 관찰하였습니다 [Figure 4]. 평가 지표의 신뢰성을 검증하기 위해 수행된 인간 선호도 평가(human preference study)와 자동화된 VLM 평가 간에는 매우 높은 상관관계($\rho=0.980$)가 관찰되었습니다 [Figure 2].
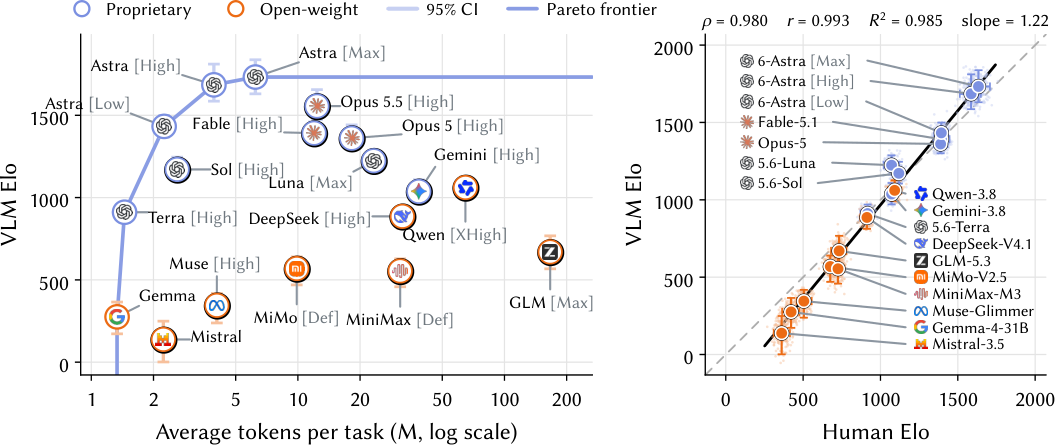
Figure 2 — 성능 및 인간 평가 정렬
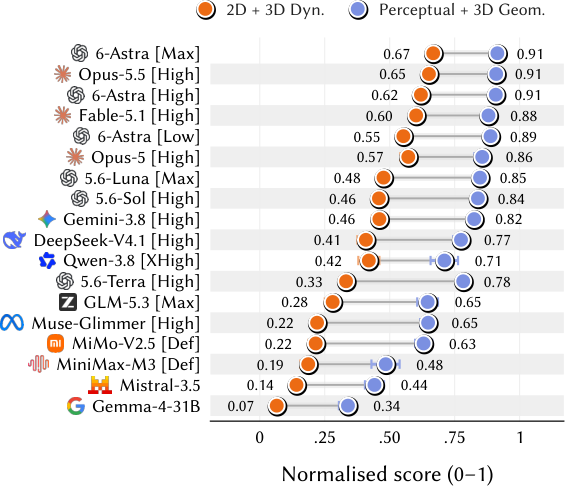
Figure 8 — 정적-동적 성능 격차
4. Conclusion & Impact (결론 및 시사점)
본 논문은 동적 장면 복원 능력에 대한 벤치마킹 체계를 제시하며, 현재의 대형 언어 모델 및 코딩 에이전트들이 복잡한 물리적 환경의 시계열적 변화를 모델링하는 데 여전히 어려움을 겪고 있음을 입증하였습니다. 이 연구는 단순히 생성된 결과의 정적인 시각적 유사성을 넘어, 물리학적 원리를 코드로 구현하는 에이전트의 능력을 측정한다는 점에서 향후 물리 기반 시뮬레이션 에이전트 연구에 중요한 토대를 마련합니다. 향후 연구 방향으로는 에이전트가 초기 조건이나 외부 힘을 조작하는 인터벤션을 통해 더 높은 수준의 물리적 이해를 습득하도록 유도하는 방향이 제시되었습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] WorldAuditBench: Interactive 3D World Auditing with Multimodal Agents
- [논문리뷰] BVB: Benchmarking Agentic Video Understanding via Programmatic Reconstruction in Blender
- [논문리뷰] HarnessDev: Can LLMs Create and Evolve Their Own Agent Harness?
- [논문리뷰] Video-IFBench: Evaluating Instruction Following of Multimodal LLMs in Video Understanding Scenarios
- [논문리뷰] VideoGAIA: A Benchmark for General AI Assistants on Agentic Video Understanding
Review 의 다른글
- 이전글 [논문리뷰] World Observer: Joint Actor-Observer Generation for Persistent World Modeling
- 현재글 : [논문리뷰] 4DCodeBench: Benchmarking Agents on Inverse Graphics of Dynamic Scenes
- 다음글 [논문리뷰] Beyond Future Prediction: Denoising as Generative Adaptation for Robot Control
댓글