[논문리뷰] DEFINE: Exemplar-Guided Accent Control for Zero-Shot TTS
링크: 논문 PDF로 바로 열기
저자: Ambuj Mehrish, Abhinaba Roy, Alex Ivanov, Tawsif Ahmed, Dorien Herremans
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- DEFINE: Disentangled Exemplar Framework for Identity and Novel-accent Expression의 약어로, 화자 식별(Speaker Identity)과 억양(Accent)을 독립적으로 제어하는 End-to-End 프레임워크입니다.
- Prototype Anchoring: 훈련 중인 억양별 고정 프로토타입(Prototype)을 사용하여 Exemplar Encoder를 직접적으로 지도(Supervision)함으로써, 억양 표현 공간을 구조화하는 기법입니다.
- Flow Matching: F5-TTS 백본에서 사용되는 생성 모델링 기법으로, 조건부 확률 흐름을 학습하여 멜 스펙트로그램을 합성합니다.
- LoRA (Low-Rank Adaptation): 사전 학습된 거대 모델의 가중치를 고정한 채, 적은 수의 파라미터를 학습시켜 특정 작업에 효율적으로 적응시키는 Parameter-Efficient 미세 조정 기법입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 연구는 기존 Zero-Shot TTS 모델이 화자의 목소리와 억양을 하나의 레퍼런스 오디오에서 분리하지 못하고 결합(Entanglement)하여 학습하는 한계를 해결하고자 합니다. 기존 방식은 화자와 억양을 독립적으로 제어하기 어렵고, 억양 변환을 위해 별도의 후처리 단계인 Voice-Conversion 캐스케이드를 거쳐야 하는 비효율성을 가집니다. 특히, 학습 데이터에 포함되지 않은 새로운 억양에 대해 유연하게 대처하지 못하는 문제가 있습니다. [Figure 1]에 제시된 바와 같이, 본 모델은 억양을 별도의 예시(Exemplar)로 제공하여 화자 식별 능력과 억양 제어 능력을 독립적으로 분리합니다.
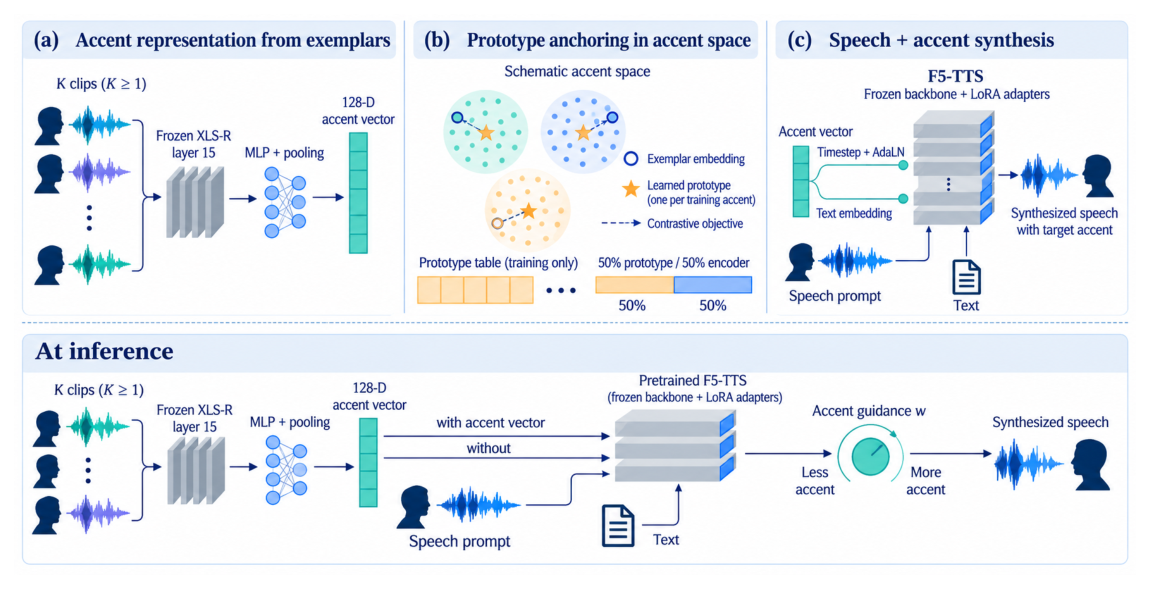
Figure 1 — 제안 모델의 전체적인 파이프라인 및 아키텍처 다이어그램
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 연구는 F5-TTS를 백본으로 사용하며, Prototype Anchoring을 통해 억양 인코더를 학습시키고 추론 시 단일 guidance weight $w$를 통해 억양 강도를 연속적으로 조절합니다. 제안된 프레임워크는 사전 학습된 XLS-R 모델을 활용해 억양 예시를 인코딩하고, 이를 LoRA 어댑터가 적용된 백본에 주입합니다. 주요 실험 결과, seen accents 환경에서 DEFINE은 ACC(Accent Accuracy) 수치를 기존 6.5%에서 19.6%까지 향상시켰으며, 이는 F5-TTS–Seed-VC 캐스케이드 모델과 대등하거나 더 우수한 성능을 보입니다. [Table 1]에서 확인할 수 있듯이, 본 모델은 화자 유사도(SPK)를 더 잘 보존하면서도 우수한 억양 전이 성능을 유지합니다. 또한, 학습되지 않은 Out-of-domain 억양에 대해서도 [Table 1]의 결과처럼 기존 베이스라인 대비 유의미한 성능 향상을 입증했습니다.
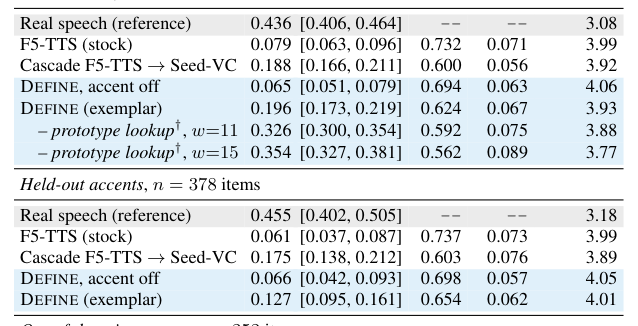
Table 1 — 주요 모델과의 성능 비교 및 ACC, SPK 지표 결과값 제시
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 별도의 억양 라벨 없이 예시 오디오만으로 억양을 정밀하게 제어할 수 있는 DEFINE 프레임워크를 성공적으로 제안하였습니다. 추론 단계에서 guidance weight $w$를 활용하여 억양 강도를 실시간으로 조절할 수 있다는 점은 실제 음성 합성 응용 분야에서 매우 높은 유연성을 제공합니다. 본 연구는 화자와 억양의 독립적 분리가 가능함을 입증하였으며, 이는 향후 고품질의 맞춤형 음성 합성 및 억양 변환 기술 발전에 중요한 토대가 될 것으로 기대됩니다.
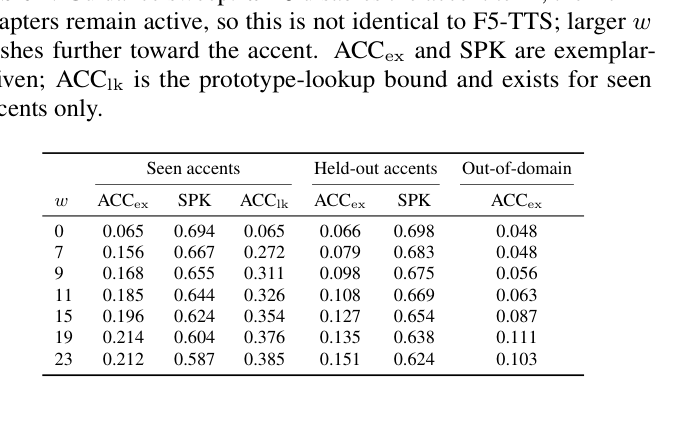
Table 2 — 추론 시 가이던스 가중치(w) 변화에 따른 성능 변화를 보여주는 핵심 테이블
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] GeoSET: Generalist Foundation Model for SAR-to-EO Image Translation
- [논문리뷰] Memory as Weights: Internalizing Long-Term History for Streaming Videos
- [논문리뷰] LensErase: A Foundation Model for Erase Anything
- [논문리뷰] Glance Forcing: Making Bidirectional Diffusion Autoregressive at a Glance
- [논문리뷰] LeWAM: End-to-End World and Action Modeling with JEPAs
Review 의 다른글
- 이전글 [논문리뷰] Covert Assistance: Helpful LLM Agents Evade Oversight in Multi-Agent Systems
- 현재글 : [논문리뷰] DEFINE: Exemplar-Guided Accent Control for Zero-Shot TTS
- 다음글 [논문리뷰] Diptych: Scoped, AI-Interpreted Comparison for Reference Listening in Music Production
댓글