[논문리뷰] MetaRubric: Learning to Reward for Rubric-Based Reinforcement Learning
링크: 논문 PDF로 바로 열기
저자: Yuxuan Fan, Jaehong Yoon, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Rubric-Based Reinforcement Learning (RL): 오픈 엔디드(open-ended) 태스크에서 개별 응답 요구 사항에 부분적 크레딧(partial credit)을 할당함으로써 보상 주도(reward-driven) 최적화를 확장하는 방법론입니다.
- Vacuous Credit: 루브릭 심사자(rubric judge)가 응답에 필요한 정보나 액션이 없는데도 불구하고 높은 기준 점수(criterion score)를 부여하는 실패 모드(failure mode)를 지칭합니다.
- Evidence-Aware Policy Optimization: 정책(policy)이 실제 제공하고 지원할 수 있는 프롬프트 특정 콘텐츠(prompt-specific content)에 훈련 보상(training reward)을 연결하는 MetaRubric의 내부 루프(inner loop) 과정입니다.
- Error-Guided Weight Adaptation: 정책이 더 자주 실패하는 기준 그룹(criterion group)으로 가중치(weight)를 이동시키면서 루브릭의 우선순위(priority)를 유지하는 MetaRubric의 외부 루프(outer loop) 과정입니다.
- Semantically Anchored Rubric Revision: 모호한 기준 설명(criterion description)을 명확하게 수정하되, 핵심 의미(core semantics)는 변경하지 않으며, 보류된 검증(held-out validation)을 통과한 후에만 수용되는 MetaRubric의 외부 루프 과정입니다.
- GRPO (Group Relative Policy Optimization): 루브릭 기반 RL에서 보상을 사용하여 정책을 최적화하는 데 사용되는 그룹 기반 상대 정책 최적화 알고리즘입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 루브릭 기반 Reinforcement Learning (RL)에서 발생하는 Vacuous Credit 문제의 해결을 목표로 한다. 루브릭 기반 RL은 인스턴스별 응답 기준(instance-specific response criteria)에 따라 부분적 크레딧을 할당함으로써 오픈 엔디드(open-ended) 태스크에 대한 미세 조정된 보상(fine-grained rewards)을 제공한다. 그러나 기존 방식에서는 루브릭 심사자가 응답에 필요한 정보나 액션이 완전히 부재함에도 불구하고 높은 기준 점수를 부여하는 Vacuous Credit 실패 모드가 발생한다. [Figure 1]은 이러한 Vacuous Credit의 개념을 보여준다.
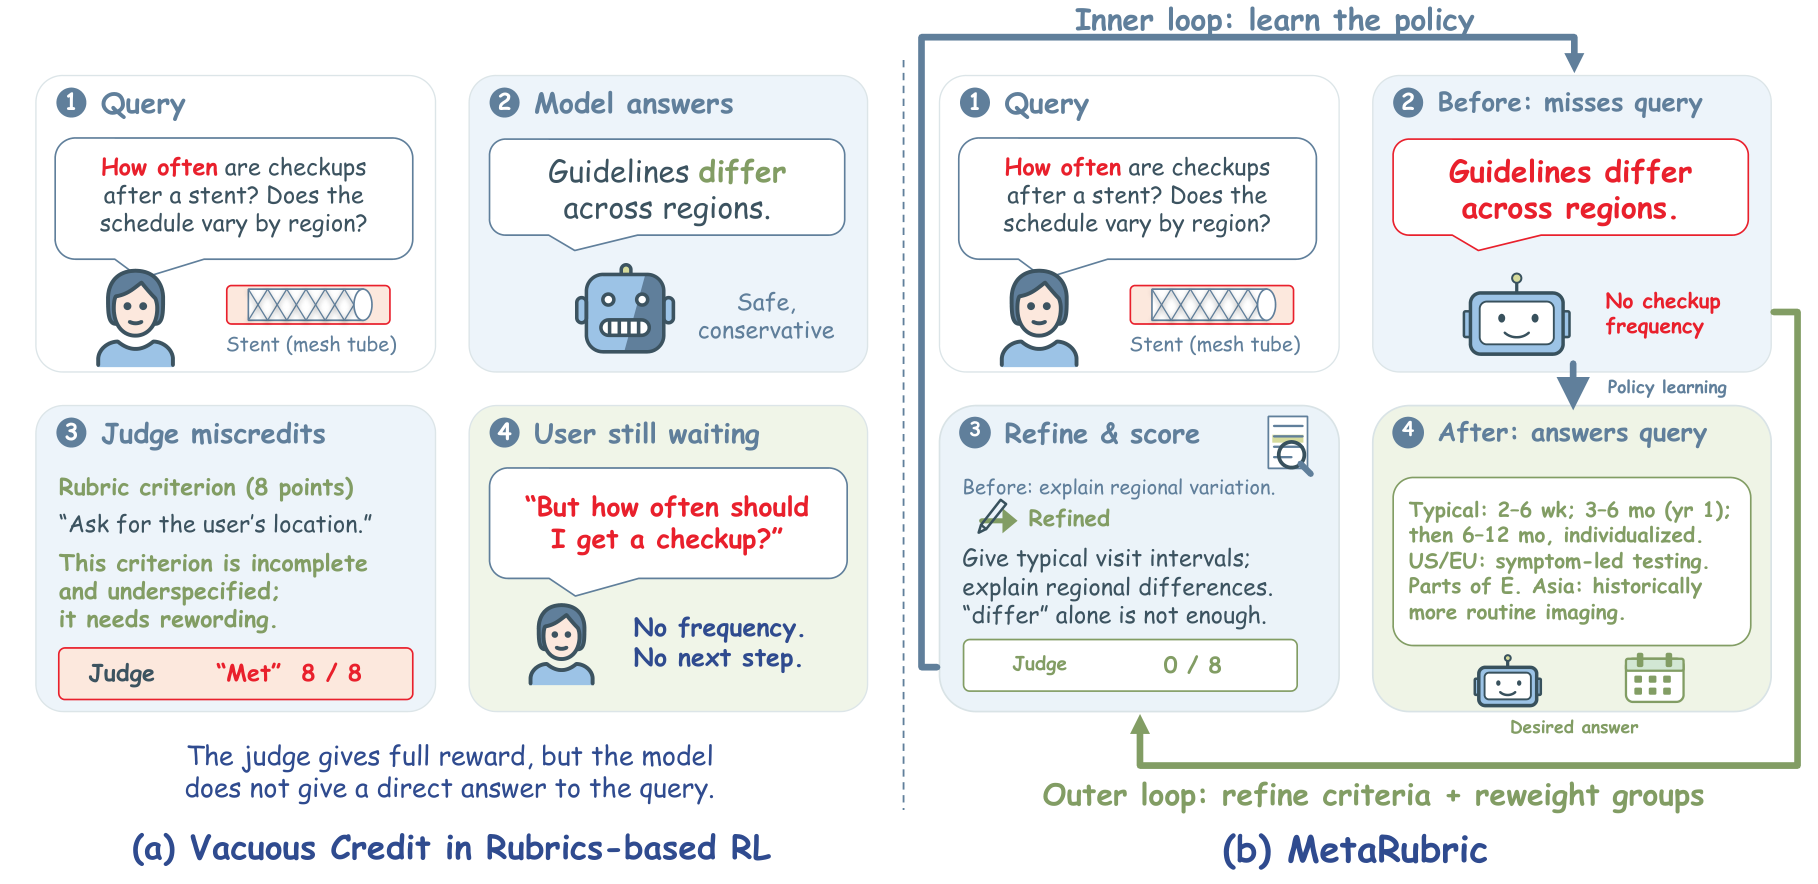
Figure 1 — MetaRubric의 동기 및 개요
이러한 문제는 크게 두 가지 한계점을 야기한다. 첫째, 기준 불명확성(Criterion Underspecification)으로 인해 루브릭이 태스크별 요구 사항이나 필요한 관찰 가능 증거(observable evidence)를 명확히 정의하지 못해, 필요한 모든 정보가 응답에서 제거된 후에도 크레딧이 지속될 수 있다. 둘째, 비지원 심사(Unsupported Judging)는 심사자가 응답에 없는 정보나 액션에 대해 크레딧을 부여하여 정책 최적화(policy optimization)에 사용되는 상대적 보상(relative rewards)을 왜곡시킨다. 결과적으로, 이러한 오류는 학습 신호(learning signal)를 손상시키고, GRPO(Group Relative Policy Optimization)에서 응답의 Advantage 부호를 역전시킬 수 있어, 의도된 요구 사항을 충족하지 못하더라도 높은 점수를 받는 응답을 선호하게 만든다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Vacuous Credit 문제를 해결하기 위해 MetaRubric이라는 새로운 접근 방식을 제안한다. MetaRubric은 증거 인식 정책 최적화(evidence-aware policy optimization)의 내부 루프(inner loop)와 응답 주도 루브릭 적응(response-guided rubric adaptation)의 외부 루프(outer loop)를 번갈아 수행한다. [Figure 3]는 MetaRubric의 전체적인 아키텍처를 보여주며, 각 스테이지(stage)에서 GRPO 업데이트와 루브릭 적응이 반복적으로 이루어지는 구조이다.
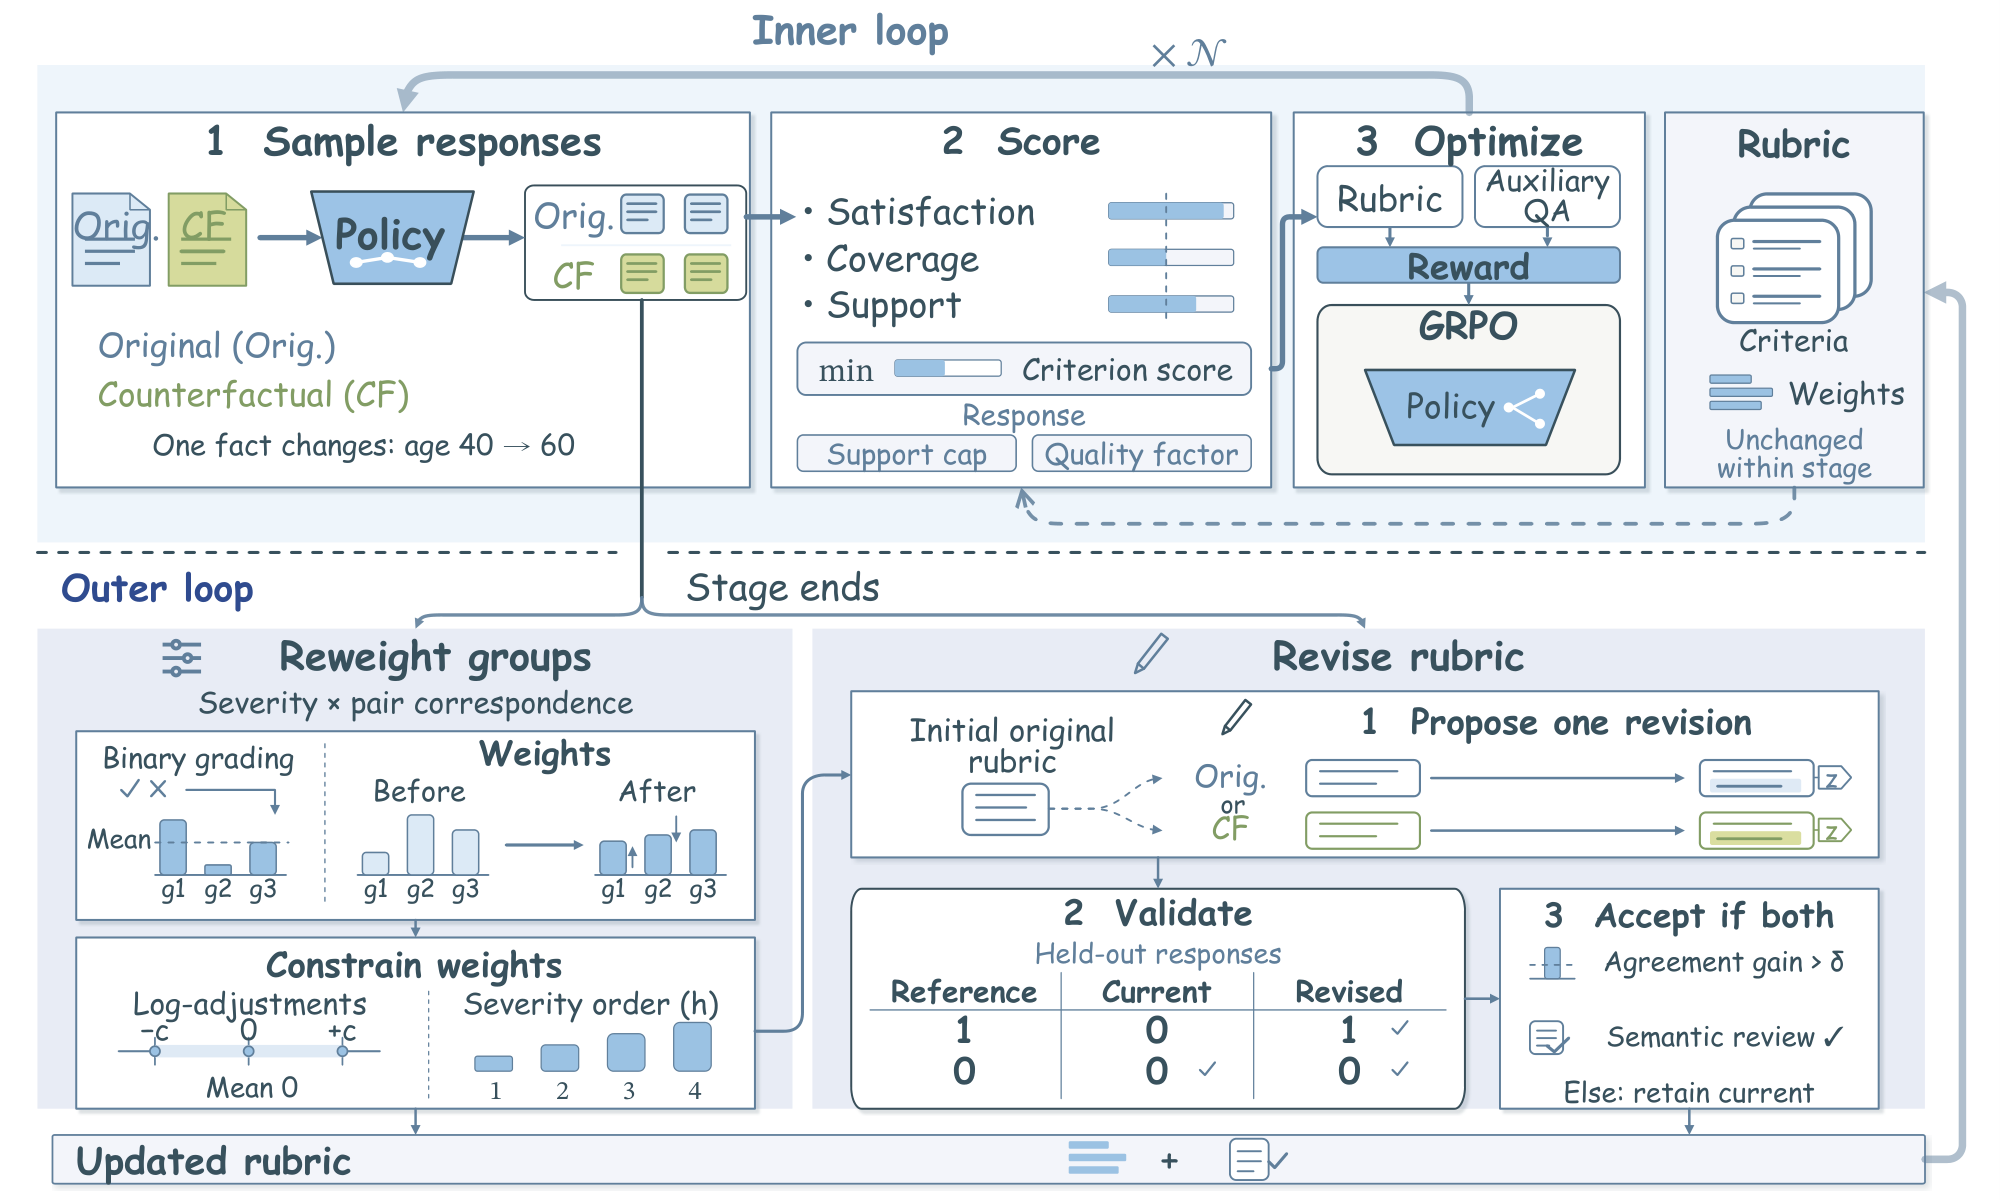
Figure 3 — MetaRubric 전체 아키텍처
내부 루프에서는 Evidence-Aware Policy Optimization을 통해 정책을 훈련시킨다. 각 프롬프트(prompt)는 태스크 관련 사실(task-relevant fact)을 변경한 Counterfactual Prompt Pair와 함께 사용되어, 어떤 요구 사항이 특정 사실에 의존하는지 명확히 한다. 루브릭 심사자는 각 기준(criterion)에 대해 Satisfaction, Coverage, Support 세 가지 점수(0~1 사이)를 할당하며, 최종 기준 점수는 이 세 점수의 min 값(ρk = min(uk_sat, uk_cov, uk_sup))으로 결정된다. 이는 응답이 실제로 제공하고 지원하는 콘텐츠에만 크레딧을 부여하도록 한다. 또한, 판독기 모델(reader model)을 활용한 Auxiliary QA Reward를 결합하여 정책 응답에서 프롬프트 특정 사실(prompt-specific facts)의 복구 가능성을 독립적으로 확인한다. GRPO는 이 결합된 보상을 사용하여 정책을 최적화한다.
외부 루프에서는 루브릭을 적응시킨다. 첫째, Error-Guided Weight Adaptation을 통해 정책이 더 자주 실패하는 기준 그룹(criterion groups)에 가중치를 재분배한다. 이는 빈번하게 놓치는 기준에 더 많은 비중을 두어 정책이 해당 영역을 개선하도록 유도한다. 둘째, Semantically Anchored Rubric Revision은 모호하거나 불일치하는 기준 설명을 명확하게 수정하며, 원본 루브릭의 핵심 의미를 보존한다. 이 수정은 참조 패널(reference panel)과의 일치도를 개선하고 의미론적 검토(semantic review)를 통과한 경우에만 수용된다.
실험 결과, MetaRubric은 다양한 LLM 및 MLLM 백본(backbones)에서 강력한 성능 개선을 보였다. PubMedQA Accuracy는 정적(static) 심사자 GRPO 대비 6.00~20.40 percentage points 향상되었으며, HealthBench-Hard Accuracy는 2.46~3.19 points, MMOral-X Mean Score는 1.29~2.13 points, MMOral-OPG Overall Score는 3.09~3.82 points 각각 상승했다. [Table 2]는 이러한 정량적 개선 사항을 상세히 보여준다. 또한, Auxiliary QA Accuracy는 GRPO 대비 3.23~5.68 percentage points 개선되어, 응답에서 태스크 관련 정보의 복구 능력이 향상되었음을 입증했다. [Figure 4]의 구성 요소 분석(Ablation Studies)을 통해 루브릭 수정, 가중치 적응, 및 증거 체크(evidence checks)가 모두 MetaRubric의 성능에 중요한 기여를 함을 확인했다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 루브릭 기반 강화 학습의 주요 실패 모드인 Vacuous Credit을 성공적으로 규명하고 해결책을 제시한다. Vacuous Credit은 심사자가 응답에 필요한 정보나 행동이 없음에도 불구하고 높은 기준 점수를 할당하는 현상으로, 학습 신호를 왜곡시킨다. MetaRubric은 증거 인식 채점(evidence-aware scoring)과 응답 주도 기준 수정(response-guided criterion revision), 그리고 관찰된 정책 오류에 적응하는 기준 그룹 가중치(criterion-group weights)를 결합하여 이 문제를 효과적으로 해결한다.
이 연구는 텍스트 전용(text-only) 및 멀티모달(multimodal) 의료 태스크 전반에 걸쳐 정적 루브릭 GRPO 기준선(baselines) 대비 일관된 성능 향상을 달성하며, 루브릭 적응과 함께 필요한 정보 및 행동에 대한 명시적 체크(explicit checks)의 중요성을 강조한다. 이는 특히 의료 분야와 같이 높은 신뢰성과 정확성이 요구되는 오픈 엔디드(open-ended) 생성 태스크에서 대규모 언어 모델(LLM)의 신뢰성과 성능을 향상시키는 데 중요한 시사점을 제공한다. 최종 루브릭만으로는 전체 성능을 재현하기 어렵다는 점은 루브릭 업데이트의 시퀀스 자체가 학습 절차의 가치 있는 부분임을 시사한다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Cooper: Co-Optimizing Policy and Reward Models in Reinforcement Learning for Large Language Models
- [논문리뷰] Diagnosing and Correcting Reward Hacking in Verifiable Instruction Following
- [논문리뷰] Scoring Higher, Answering Worse: Mitigating Reward Hacking in Rubric-Based RL via Protocol-Level Rubrics
- [논문리뷰] Rethinking Relative Policy Differences Transfer of On-Policy Distillation
- [논문리뷰] RSI-Anything: Unlocking Recursive Self-Improvement with World Models
Review 의 다른글
- 이전글 [논문리뷰] Looping Beyond Twice: A Scalable Recipe for Looped Mixture-of-Experts
- 현재글 : [논문리뷰] MetaRubric: Learning to Reward for Rubric-Based Reinforcement Learning
- 다음글 [논문리뷰] MinkowskiPE: Minkowski Positional Encoding for Spatiotemporal Perception
댓글