[논문리뷰] Multilingual GSM-Symbolic: What determines capability transfer across languages?
링크: 논문 PDF로 바로 열기
**저자:** Kenneth Enevoldsen, Riley Herchert, Sofie Mosegaard, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- **Multilingual GSM-Symbolic**: 15개 언어에 걸쳐 30,000개의 item-matched 질문-답변 쌍을 포함하는 확장 가능한 다국어 수학적 데이터셋으로, 오버피팅을 방지하고 일반화를 보장하기 위해 symbolic templates를 활용한다.
- **Capability Transfer**: 한 언어에서 습득한 모델의 능력이 다른 언어로 얼마나 잘 전이되는지를 나타내는 개념이다.
- **GLMM (Generalized Linear Mixed Model)**: 개별 instance의 성능을 모델링하여 cross-lingual transfer를 지배하는 언어-레벨 특징(language-level features)을 추정하는 데 사용되는 통계 모델이다.
- **Typological Distance**: URIEL에서 103가지 morphosyntactic features의 cosine distance를 사용하여 측정되는 언어 간의 구조적 유사성 또는 비유사성이다.
- **Language Resource Level**: Common Crawl 페이지 수를 프록시로 사용하여 측정되는 언어의 resource 수준으로, LLM pretraining에서 일반적으로 사용된다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의)
현대 LLM은 다양한 자연어 문제 해결에 뛰어난 능력을 보이지만, 한 언어에서 습득한 능력이 다른 언어로 어떻게 전이되는지에 대한 이해는 부족하다. 기존의 cross-lingual 평가 방식은 비교 불가능하며 saturation-prone한 데이터셋에 의존하며, transfer의 결정 요인들을 종합적으로 검토하지 못하는 한계가 있다. 이러한 문제로 인해 모델 개발자들은 모든 언어 쌍에 대한 철저한 평가를 피하고, low-resource languages에서의 성능을 제한하는 요인들을 직접적으로 개선하기 어렵다. 본 논문은 이러한 한계를 극복하고 cross-lingual capability transfer를 예측하는 요인을 식별하기 위해 Multilingual GSM-Symbolic 데이터셋을 제안한다 [Figure 1].
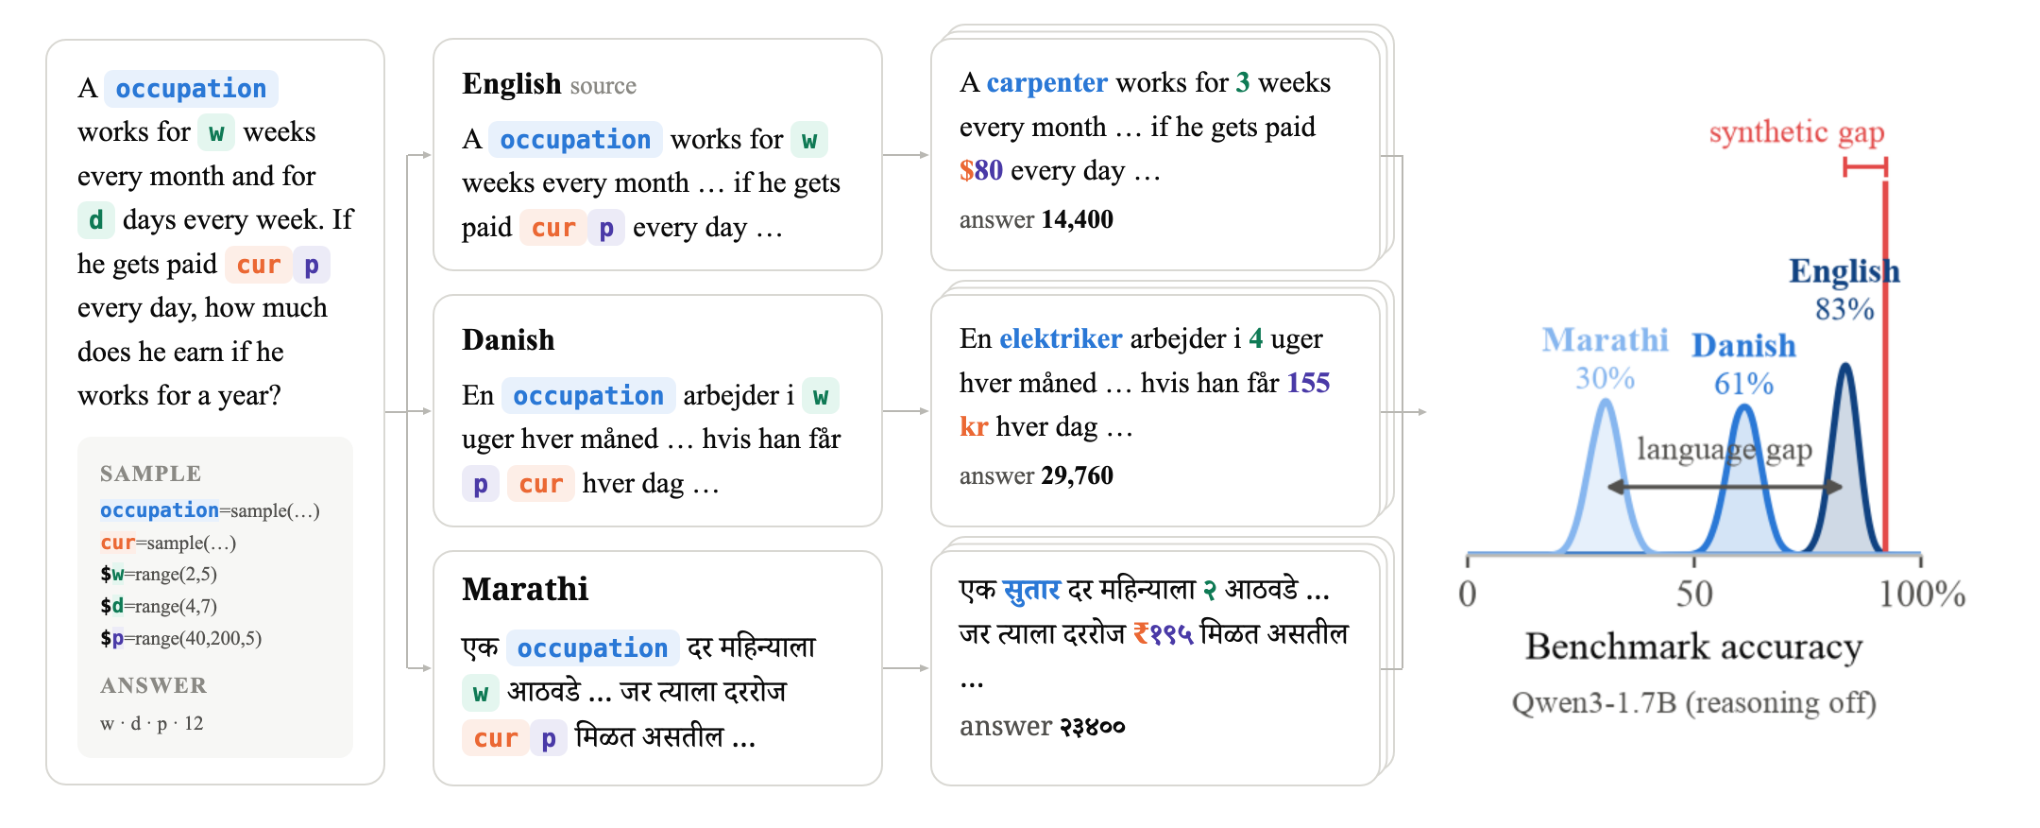
*Figure 1 — Multilingual GSM-Symbolic 개요*
## 3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 cross-lingual capability transfer의 결정 요인을 연구하기 위해 **Multilingual GSM-Symbolic**이라는 새로운 데이터셋을 구축하고, Generalized Linear Mixed Model (GLMM)을 사용하여 성능을 모델링했다. 이 데이터셋은 GSM-Symbolic에서 파생된 100개의 symbolic templates를 15개 언어(일본어, 중국어, 러시아어, 힌디어, 프랑스어, 아랍어, 에스토니아어, 아이슬란드어, 덴마크어, 네덜란드어, 독일어, 영어, 우크라이나어, 이탈리아어, 마라티어)로 번역 및 현지화하여 30,000개의 item-matched 질문-답변 쌍을 포함한다. 모든 번역은 LLM 지원을 받은 원어민 전문가에 의해 수행되었으며, 철저한 manual review 및 automated test-suite를 통한 검증 과정을 거쳤다.
GLMM 분석 결과, capability의 가장 큰 결정 요인은 **model size** (β=1.77), **language resource level** (β=0.77), **reasoning** (β=0.67), 그리고 **typological distance** (β=−0.25) 순으로 나타났다 [cite: 1, Figure 2]. 특히, **model size**와 **reasoning**은 low-resource languages와 high-resource languages 간의 성능 격차를 줄이는 데 효과적인 lever로 작용했으며 (각각 β=−0.27, β=−0.20), 반면 typologically distant languages에는 이러한 lever의 영향이 미미하거나 없었다 [cite: 1, Figure 4]. 또한, 본 분석 프레임워크는 언어 간(between-language) variance의 <strong>92%</strong>를 설명하며, 모델의 unseen language에 대한 성능을 **6.0pp** (Pearson r=0.96) 오차 범위 내에서 예측할 수 있음을 입증했다 [cite: 1, Figure 6]. 단 10개의 target language templates를 포함하면 이 예측 오차는 **4.19pp**로 더욱 감소한다.
## 4. Conclusion & Impact (결론 및 시사점)
본 연구는 Multilingual GSM-Symbolic이라는 검증되고 확장 가능한 고품질 데이터셋을 제시하며, 언어 간 capability transfer를 결정하는 핵심 요인들을 정량적으로 분석했다. 연구 결과, **model size**, **language resource level**, **reasoning**, **typological distance**가 모델 성능에 가장 큰 영향을 미치는 것으로 밝혀졌으며 [cite: 1, Figure 2], 특히 **model size**와 **reasoning**은 low-resource languages에서의 성능 격차를 줄이는 데 중요한 역할을 한다 [cite: 1, Figure 4]. 이러한 발견은 LLM 개발자들이 low-resource language를 위한 모델 성능을 향상시키는 데 있어 어떤 요인에 집중해야 할지에 대한 actionable insights를 제공한다. 또한, unseen language에 대한 모델 성능을 높은 정확도로 예측할 수 있음을 보여주어, 비용이 많이 드는 exhaustive evaluation 없이도 신뢰할 수 있는 성능 추정치를 얻을 수 있음을 시사하며, 이는 multilingual LLM 평가의 효율성을 크게 높일 수 있다 [cite: 1, Figure 6].
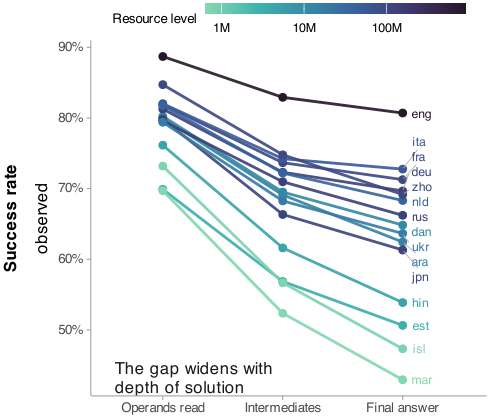
*Figure 2 — 고정 효과 및 95% Wald 구간*
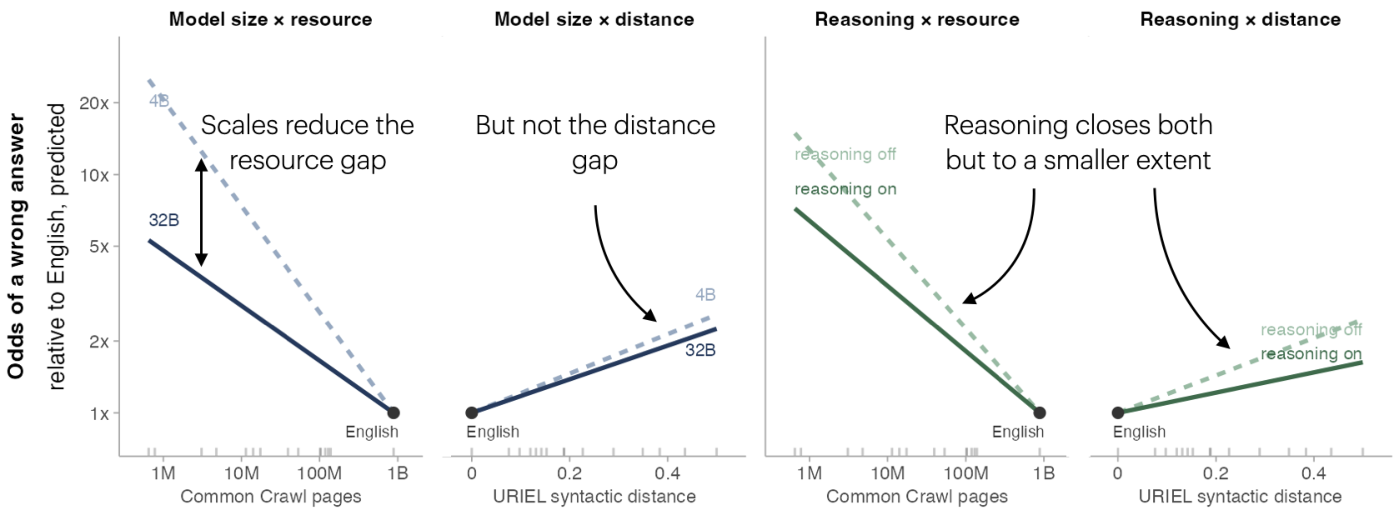
*Figure 4 — 자원 수준 및 유형 거리별 레버*
> ⚠️ **알림:** 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
- [논문리뷰] Semifactual Credit-Augmented Policy Optimization
- [논문리뷰] Questioning the Questions: Sustaining Self-Evolution in Reasoning Models
- [논문리뷰] DiffGate: Difficulty-Gated Teacher Guidance for On-Policy Distillation
- [논문리뷰] The Missing Primitive: Diagnosing and Repairing Mathematical Reasoning in Large Language Models
Review 의 다른글
- 이전글 [논문리뷰] MotorMind: Scaffolding General Vision Language Models for Zero-Shot Robot Manipulation
- 현재글 : [논문리뷰] Multilingual GSM-Symbolic: What determines capability transfer across languages?
- 다음글 [논문리뷰] Native Action-Prior Learning from Videos for World Action Models
댓글