[논문리뷰] WEFT: Scaling Tool-Use Post-Training for General-Purpose Agents
링크: 논문 PDF로 바로 열기
저자: Bo Mao, Hang He, Linting Wang, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- WEFT: (Whole-system Evolution For Tool-use Post-training) 환경, 작업, 에이전트, 평가자로 구성된 전체 agentic interaction system의 확장 및 진화를 수행하는 post-training 프레임워크입니다.
- MegaMCP: 개별 rollout 간 도구 서비스(tool services)를 공유하면서도 데이터베이스와 작업 공간을 독립적으로 격리하여, 재시작 및 후보 샘플링을 효율적으로 지원하는 인프라입니다.
- Prefix-Preserving Rejection Sampling: 전체 trajectory를 폐기하는 대신 검증된 중간 단계(prefix)를 유지하고 실패한 atomic task만 재수행하는 고품질 데이터 생성 기법입니다.
- Atomic-Turn Credit Assignment: 전체 경로가 아닌 atomic task 단위의 결과를 기반으로 보상을 부여하여 보다 세분화된 learning signal을 제공하는 RL 학습 기법입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 단순히 실행 가능한 환경을 늘리는 것만으로는 agentic tool-use 능력이 향상되지 않으며, 전체 agentic interaction system의 구조적 개선이 필요하다는 문제의식에서 출발합니다. 기존의 환경 스케일링 연구들은 실행 가능한 환경(executable environments) 합성에는 집중했으나, 작업의 타당성이나 평가 과정에서의 오류를 배제하지 못해 잘못된 학습 신호를 생성하는 한계가 있었습니다. 특히, 단순한 환경 확장이 아닌 환경, 작업, Harness, 평가자 간의 응집력 있는 상호작용이 학습 효율을 결정짓는다는 점을 간파하여, WEFT는 시스템 전반의 자가 진화(self-evolution) 메커니즘을 도입하였습니다. 이는 [Figure 1]에서 볼 수 있듯이 기존 방식이 겪는 misleading learning signal 문제를 극복하기 위한 근본적인 해결책을 제시합니다.
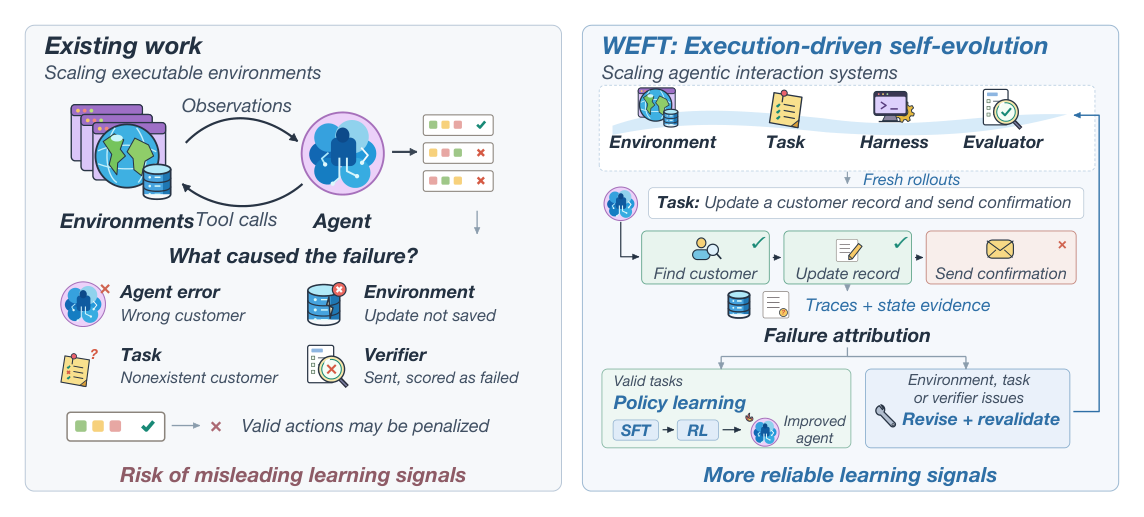
Figure 1 — 기존 방식과 WEFT의 차이점 및 Failure attribution 메커니즘을 시각적으로 보여주는 핵심 다이어그램
## 3. Method & Key Results (제안 방법론 및 핵심 결과)
WEFT는 도구 정의로부터 stateful한 환경을 합성하고, 이를 바탕으로 검증된 atomic task를 구성하여 전체적인 agentic interaction system을 스케일링하는 end-to-end 프레임워크입니다. 본 연구는 Execution-driven self-evolution을 통해 실행 트레이스(traces)와 상태 증거(state evidence)를 기반으로 실패 원인을 진단하고, 컴포넌트를 개별적으로 수정하여 환경과 verifier의 신뢰성을 지속적으로 개선합니다. 학습 단계에서는 MegaMCP를 활용해 concurrent rollout 비용을 획기적으로 절감하며, [Table 1]에 제시된 결과와 같이 WEFT-14B 모델은 기존 Agent-World-14B 대비 BFCL V4, τ²-Bench, Claw-Eval 지표에서 각각 6.41%, 2.23%, 12.27%p 향상된 성능을 기록했습니다. 또한, WEFT-35B-A3B는 Toolathlon-Verified에서 45.99%, AutomationBench에서 26.50%의 높은 정확도를 달성하며 복잡한 long-horizon workflow 처리 능력을 입증했습니다.
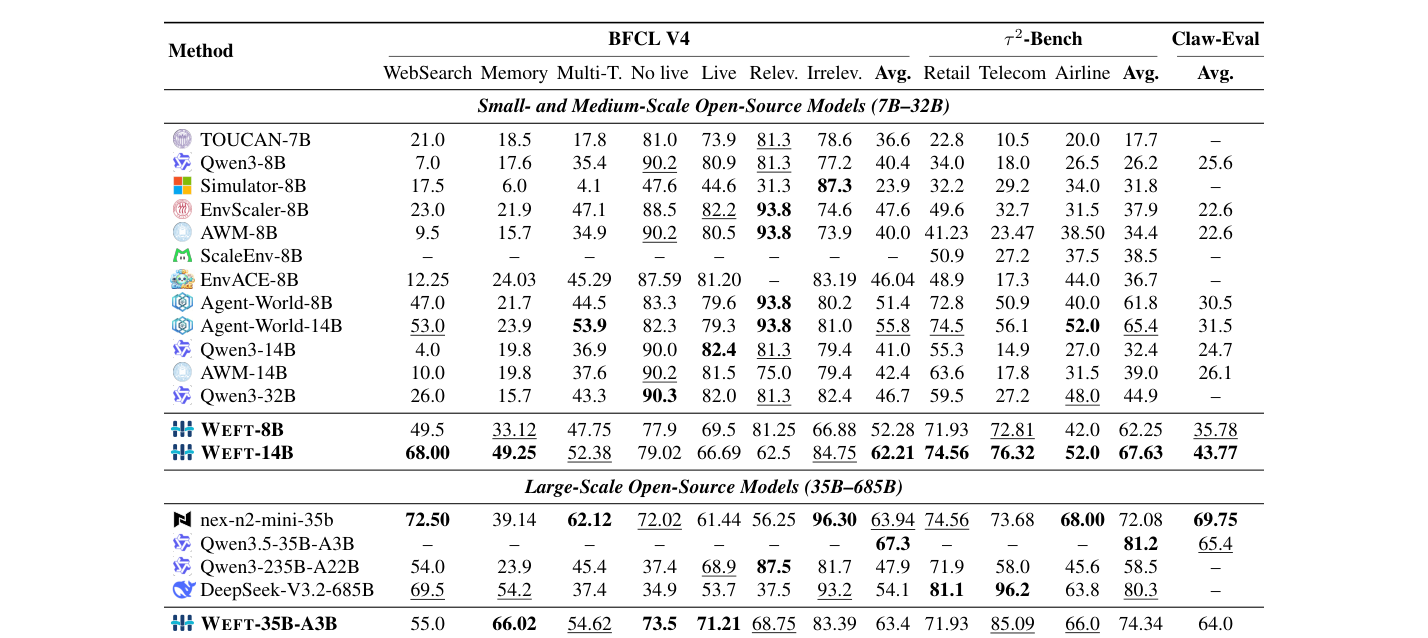
Table 1 — WEFT 모델과 기존 SOTA 모델들 간의 성능 비교를 나타내는 주요 벤치마크 테이블
## 4. Conclusion & Impact (결론 및 시사점) WEFT는 tool-use post-training이 단순한 환경 확장이 아닌 시스템 엔지니어링의 문제임을 입증하며, 실행 경험을 데이터 생성과 시스템 개선의 이중 도구로 활용하는 패러다임을 정립했습니다. 본 연구에서 제안한 self-evolution loop와 MegaMCP 인프라는 에이전트 개발 과정에서의 자원 소모를 최소화하면서도, 학습 신호의 질을 획기적으로 높일 수 있는 실용적인 방법론을 제공합니다. 이는 향후 대규모 에이전트 모델의 안정적인 배포와 지속 가능한 학습 시스템 구축에 있어 중요한 학술적·기술적 이정표가 될 것으로 평가됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Player-1: Learning to Play from Synthetic Experience
- [논문리뷰] Learning More by Training Less: Uncertainty-Guided Progressive Contraction for Efficient Reasoning Post-Training
- [논문리뷰] Understanding and Enhancing Backdoor Persistency in LLM Agent Post-Training
- [논문리뷰] The Missing Primitive: Diagnosing and Repairing Mathematical Reasoning in Large Language Models
- [논문리뷰] Where-OPD: Spatially Guided On-Policy Self-Distillation of MLLMs with Synthetic Scenes
Review 의 다른글
- 이전글 [논문리뷰] VeriHarness: Scaling Agentic Verification for Long-Horizon Tasks
- 현재글 : [논문리뷰] WEFT: Scaling Tool-Use Post-Training for General-Purpose Agents
- 다음글 [논문리뷰] Where Does Retrieval-Based Open-Ended Evaluation Fail? Automatic Taxonomy Induction from Long-Form Medical Answer Factuality Verification
댓글