[논문리뷰] VeriHarness: Scaling Agentic Verification for Long-Horizon Tasks
링크: 논문 PDF로 바로 열기
메타데이터
저자: Caiqi Zhang, Rujun Han, Zifeng Wang, Zoey CuiZhu, Nigel Collier, Tomas Pfister, Chen-Yu Lee
1. Key Terms & Definitions (핵심 용어 및 정의)
- VeriHarness: 동일한 LLM 모델을 사용하여 생성된 여러 rollout을 검증하기 위한 plug-and-play 형태의 에이전트 프레임워크입니다.
- Disagreement Resolver: 여러 rollout 간에 의견이 갈리는(disputed) claims을 환경 증거(environmental evidence)를 활용해 해결하는 컴포넌트입니다.
- Consensus Challenger: 모든 rollout이 동의하는(consensus) claims이라도 그 안에 잠재된 오류를 찾아내기 위해 증거를 검색하고 요구사항을 검토하는 컴포넌트입니다.
- Verification Skills: 특정 오류 모드를 식별하고 검증 절차를 수행하는 재사용 가능한 지식 라이브러리(skill library)입니다.
- Evidence-backed Revision: 단순히 최선의 rollout을 선택하는 것을 넘어, 수집된 증거를 바탕으로 최종 아티팩트를 수정하고 개선하는 과정입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 복잡한 long-horizon 작업을 수행하는 LLM 에이전트의 출력을 외부 정답지나 rubric 없이 신뢰성 있게 검증하는 문제를 해결합니다. 기존의 Majority Voting이나 LLM-as-a-judge 방식은 모델이 이미 믿고 있는 내용에 의존하기 때문에, 다수의 결과물이 모두 동일한 오류를 범하고 있을 때 이를 식별하지 못한다는 한계가 있습니다 [Figure 2]. 또한, 단순한 투표(voting)만으로는 불일치하는(disputed) 주장들 속에 포함된 올바른 대안을 효과적으로 활용하기 어렵습니다. 따라서 저자들은 환경 증거와 상호 보완적인 검증 기법을 활용하여 생성자의 모델을 직접 검증자로 전환하는 새로운 프레임워크가 필요하다고 판단했습니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들이 제안하는 VeriHarness는 Generator와 동일한 모델을 Verifier로 활용하며, Workspace, Evidence Tools, Verification Protocol, Skill Library로 구성됩니다 [Figure 3]. 이 프레임워크는 불일치하는 주장을 해결하는 Disagreement Resolver와 공유된 결론을 공격적으로 검증하는 Consensus Challenger라는 두 가지 핵심 기능을 수행합니다. 실험 결과, VeriHarness는 5개의 long-horizon 벤치마크에서 기존의 모든 선택(selection) 및 검증(verification) baseline 대비 가장 높은 성능을 기록했습니다 [Table 2]. 특히 Gemini 3.5 Flash와 Claude Opus 4.8 모델에서 각각 단일 rollout 대비 6.2점 및 6.4점의 성능 향상을 달성했습니다. 또한, 실패 피드백을 통해 Verification Skills를 스스로 발전(self-evolve)시킬 수 있음을 입증했으며, 이는 인공적으로 작성된 라이브러리보다 더 정교하고 작업 특화된 검증 절차를 학습할 수 있게 합니다 [Figure 4].
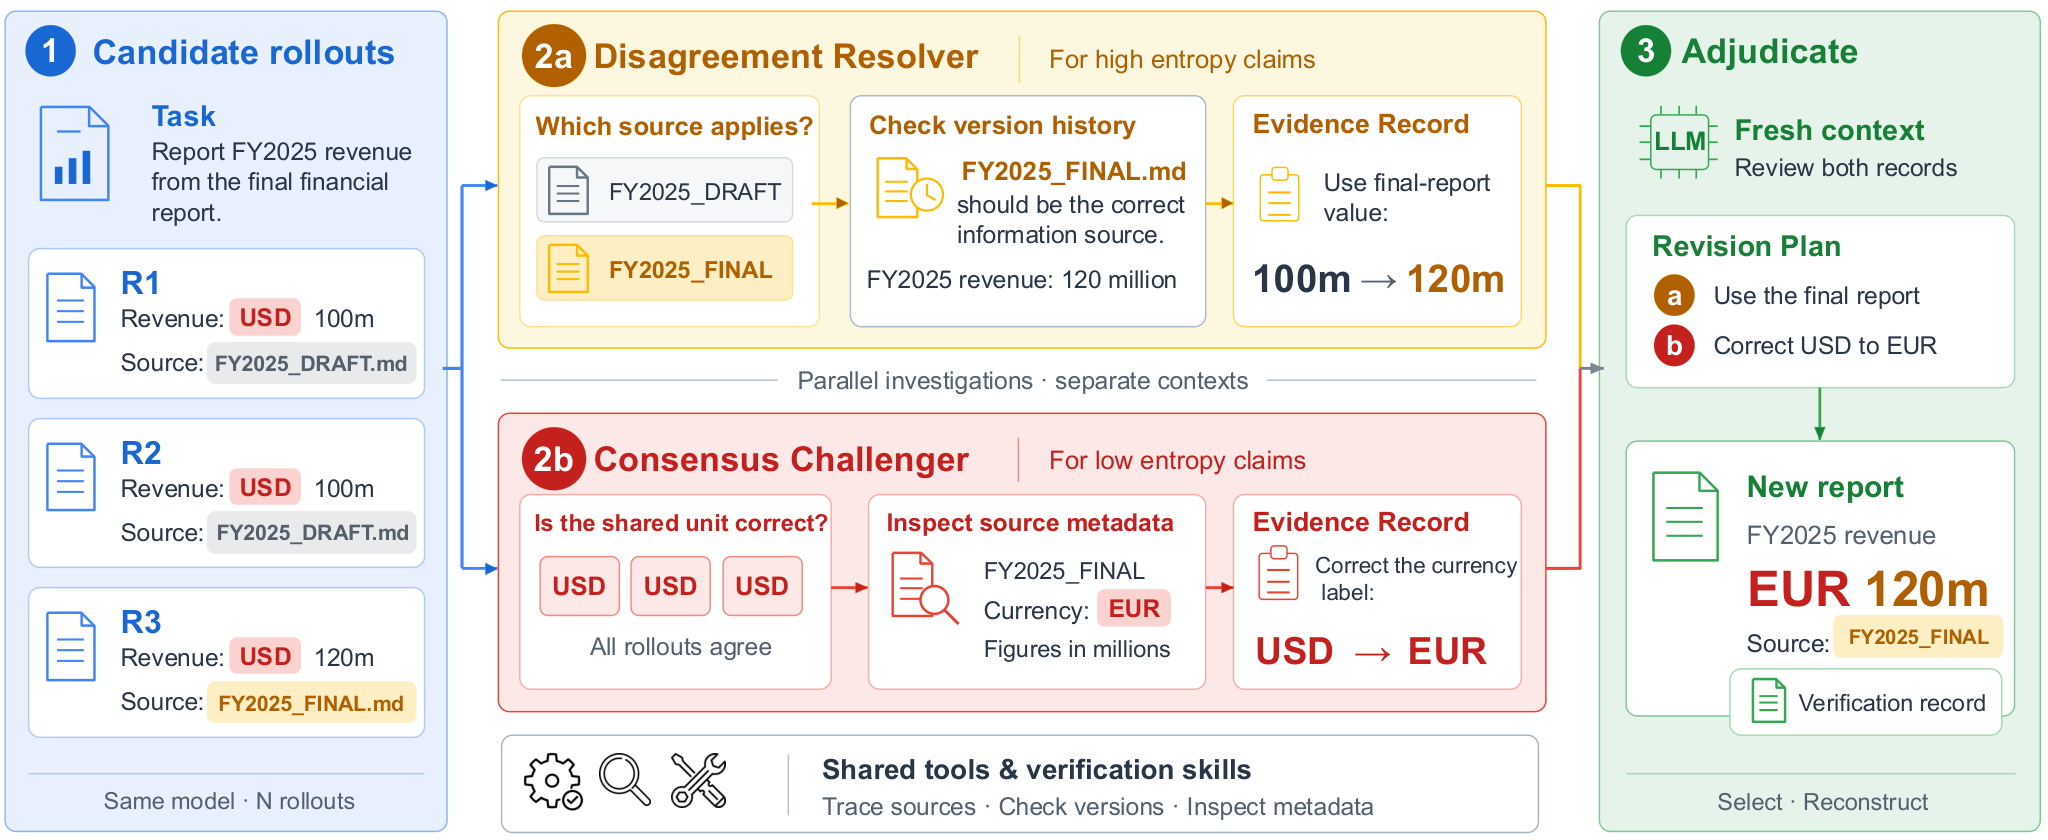
Figure 3 — VeriHarness 작업 예시
4. Conclusion & Impact (결론 및 시사점)
본 논문은 LLM 에이전트가 복잡한 작업을 수행할 때 필요한 검증 능력을 모델의 사전 학습 없이 test-time에 확장하는 VeriHarness를 성공적으로 제시했습니다. 이 연구는 consensus가 항상 정답을 보장하지 않는다는 점을 밝히고, 환경 증거와 재사용 가능한 스킬을 결합하여 에이전트의 자기 검증 능력을 비약적으로 향상시켰습니다. 본 연구에서 릴리즈한 26,000개 이상의 rollout 데이터셋은 향후 에이전트 검증 연구의 중요한 자산이 될 것으로 기대됩니다.
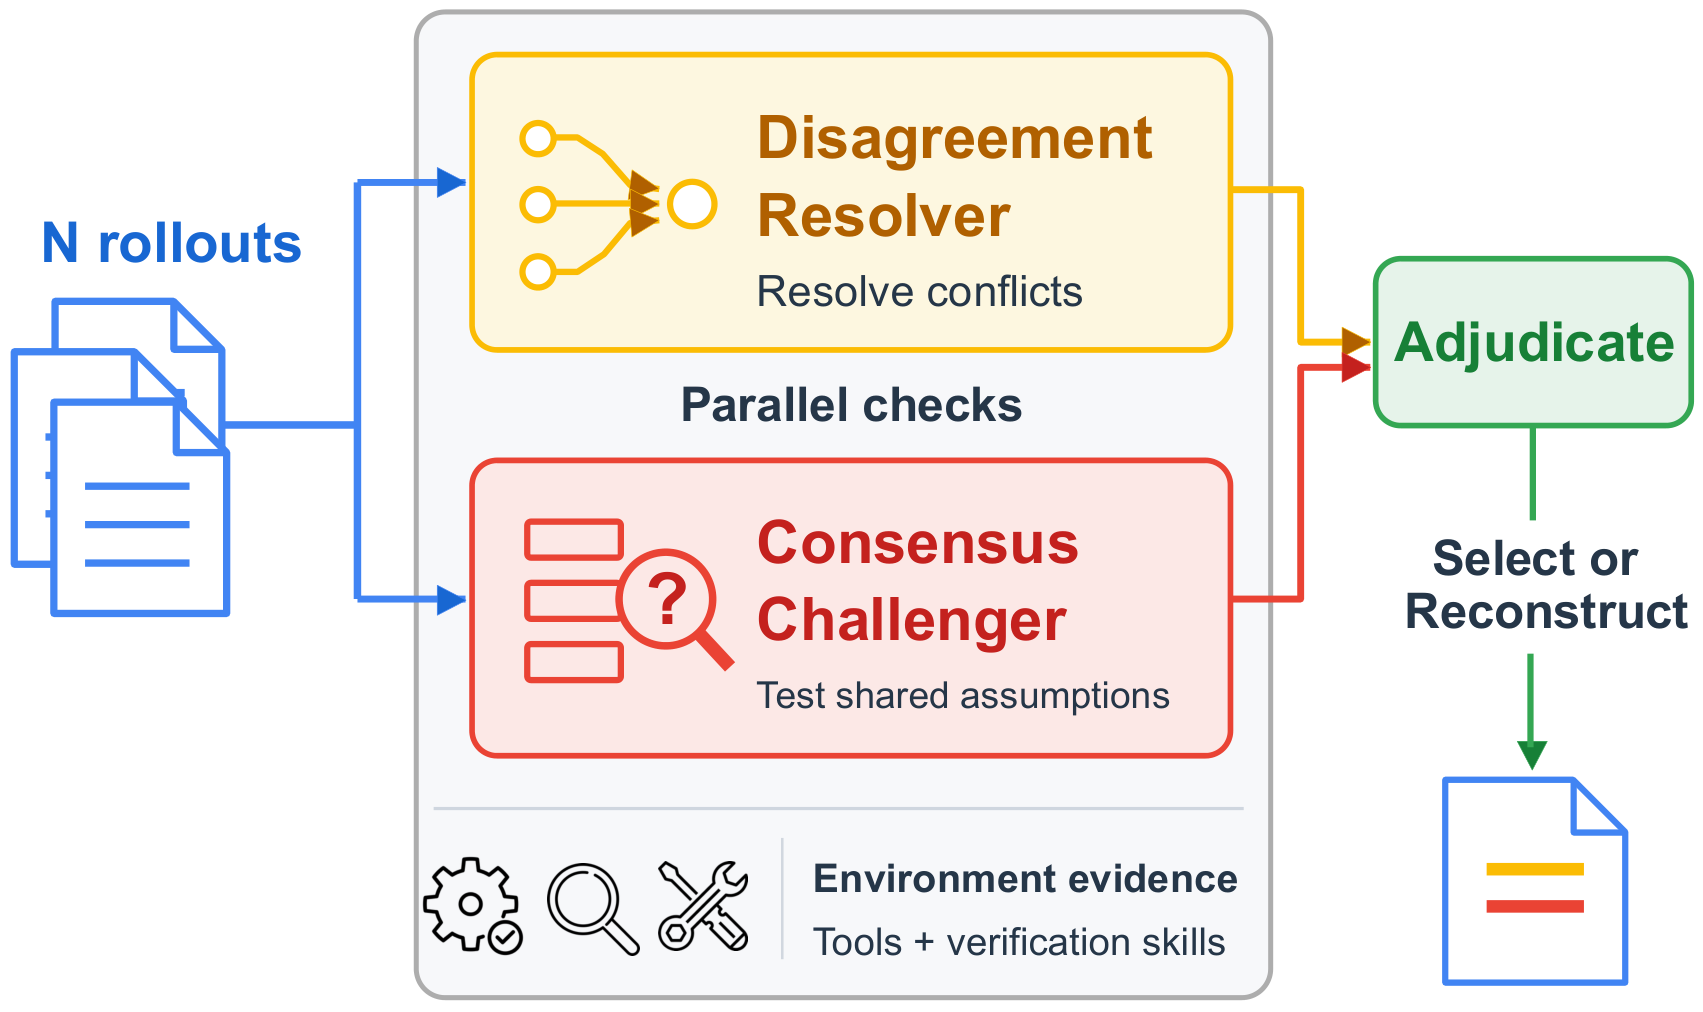
Figure 1 — VeriHarness 개요
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] ProgAgent: Learning Tool Orchestration through Programmatic Training
- [논문리뷰] Scaling Agentic Data for Long-Horizon Terminal Intelligence
- [논문리뷰] ASCENT: Online Test-Time Training of Long-Horizon Agents via Self-Distillation of Verified Experience
- [논문리뷰] World Action Modeling with Progressive Visual Planning
- [논문리뷰] EmbodiedMemory-Bench: Benchmarking Embodied Memory for Long-Horizon Embodied Tasks
Review 의 다른글
- 이전글 [논문리뷰] Triadic Linear Attention: Three-Dimensional Recurrent States for Long-Context Sequence Modeling
- 현재글 : [논문리뷰] VeriHarness: Scaling Agentic Verification for Long-Horizon Tasks
- 다음글 [논문리뷰] WEFT: Scaling Tool-Use Post-Training for General-Purpose Agents
댓글