[논문리뷰] Triadic Linear Attention: Three-Dimensional Recurrent States for Long-Context Sequence Modeling
링크: 논문 PDF로 바로 열기
저자: Oliver Sieberling, Bharat Runwal, David Jin, Ryan Chin, Rameswar Panda, Yoon Kim
1. Key Terms & Definitions (핵심 용어 및 정의)
- Linear Attention: 일반적인 RNN의 벡터(vector-valued) 은닉 상태를 키(key)와 값(value) 벡터의 dyadic outer product를 사용하여 행렬(matrix-valued) 은닉 상태로 확장하는 메커니즘입니다.
- Triadic Linear Attention: 기존 Linear Attention을 확장하여, 키(key), 두 번째 키(second key), 값(value)의 triadic outer product를 사용하여 3차(third-order, 3D) 텐서(tensor) 상태에 기록하고, 두 개의 쿼리(query)로 읽어 들이는 방식입니다.
- Memory State Size: RNN 모델이 과거 컨텍스트를 얼마나 잘 기억하고 활용할 수 있는지를 결정하는 핵심 요소입니다.
- Data-dependent Forgetting: 데이터에 따라 동적으로 계산된 게이트(gate)를 사용하여 recurrent state의 과거 정보를 점진적으로 소멸시키는 기법입니다.
- Delta Rule: 새로운 키-값(key-value) 쌍이 주어졌을 때, 해당 키에 대해 이전에 저장된 값을 먼저 제거한 후 새로운 연관성을 기록함으로써 메모리 업데이트의 정확성을 높이는 규칙입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Linear Attention 기반 RNN 모델들이 Long-Context Sequence Modeling 및 Recall-intensive Tasks에서 겪는 Memory State Size 한계를 Parameter-efficient하게 극복하는 방법을 제안합니다. 기존 Linear Attention은 벡터 기반 RNN의 은닉 상태를 행렬 기반으로 확장하여 성능을 향상시켰지만, 여전히 고정된 상태 크기(fixed-size state)로 인해 긴 시퀀스(long sequence)에서 정보 검색 및 장기 기억(long-term memory)에 어려움을 겪습니다. 이러한 한계는 모델이 특정 길이 이상의 시퀀스를 복사하지 못하는 문제로 이어지기도 합니다. 단순히 state size를 늘리는 방식은 parameter count를 크게 증가시키고, 이는 효율적인 모델 학습 및 배포에 제약이 됩니다. 따라서, 저자들은 parameter-efficient하면서도 state size를 효과적으로 확장할 수 있는 새로운 접근 방식의 필요성을 제기합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 기존 Linear Attention을 일반화하여 Triadic Linear Attention을 제안합니다. 이는 키(key), 두 번째 키(second key), 값(value) 세 벡터의 triadic outer product를 사용하여 third-order (3D) tensor state를 업데이트하며, 두 개의 쿼리(query)로 두 키 축을 수축(contract)시켜 정보를 읽어냅니다. E-dimensional 두 번째 키를 도입함으로써 state size를 E-fold 증가시키면서도 parameter overhead는 두 개의 추가적인 선형 프로젝션(linear projections)만으로 매우 낮게 유지됩니다. 이 방법론은 data-dependent forgetting 및 delta rule과도 자연스럽게 호환되며, 각 second-key axis 슬라이스(slice)에 고유한 forget gate를 부여하고 delta rule을 두 키 쌍에 공동으로 적용합니다. 또한, chunkwise-parallel training을 통해 효율적인 구현이 가능하며, joint key의 Kronecker 구조를 활용하고 state를 value axis를 따라 tiling하여 on-chip memory 제약을 해결합니다.
실험 결과, Triadic Linear Attention은 Long-Context Language Modeling 및 Recall-intensive Tasks에서 Transformer와 기존 Linear Attention 기반 모델들을 능가하는 성능을 보였습니다. Multi-query Associative Recall (MQAR) 벤치마크에서 E=16인 Triadic Linear Attention은 일반 Linear Attention 대비 약 16배 더 많은 키-값 연관성을 저장할 수 있었으며, 이는 불과 1.08배의 적은 non-embedding parameters 증가로 달성되었습니다 [Figure 1],. 특히, Triadic Gated DeltaNet (GDN)은 PG19 데이터셋에서 E=8일 때 64k context에서도 Transformer보다 더 낮은 perplexity를 달성했으며, 이는 Transformer의 key-value cache가 Triadic GDN의 state size를 초과하는 지점 이후에도 유지되었습니다 [Figure 2],. 또한, WikiText 및 PG19의 모든 컨텍스트 범위에서 Triadic GDN (E=4)이 baseline GDN 및 다른 state size 확장 방식들보다 일관되게 낮은 perplexity와 높은 recall 성능(예: GDN의 recall 26.2 대비 Triadic (E=4)는 31.1)을 기록했습니다 [Table 1],. Training Efficiency 측면에서, E=8인 Triadic GDN은 64k tokens에서 Transformer보다 5.1배 더 빠르게 동작하며, vanilla GDN 대비 28-30%의 합리적인 overhead를 보였습니다 [Figure 4],.
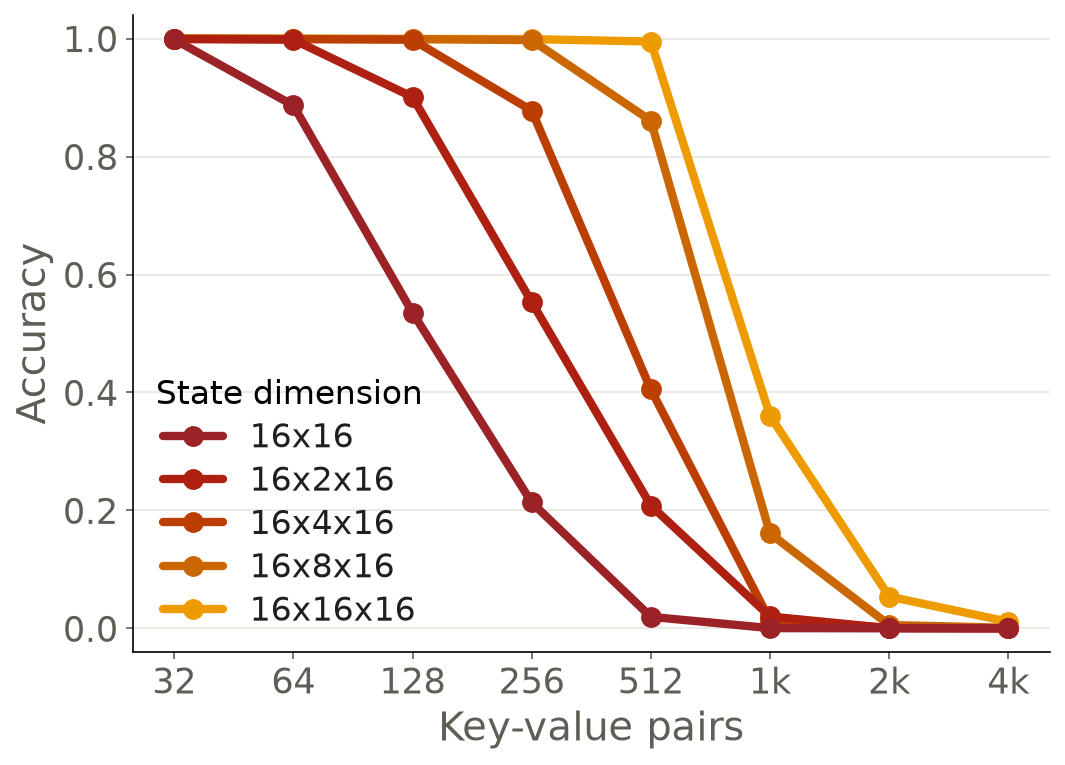
Figure 1 — MQAR 성능: Triadic Linear Attention의 용량 확장
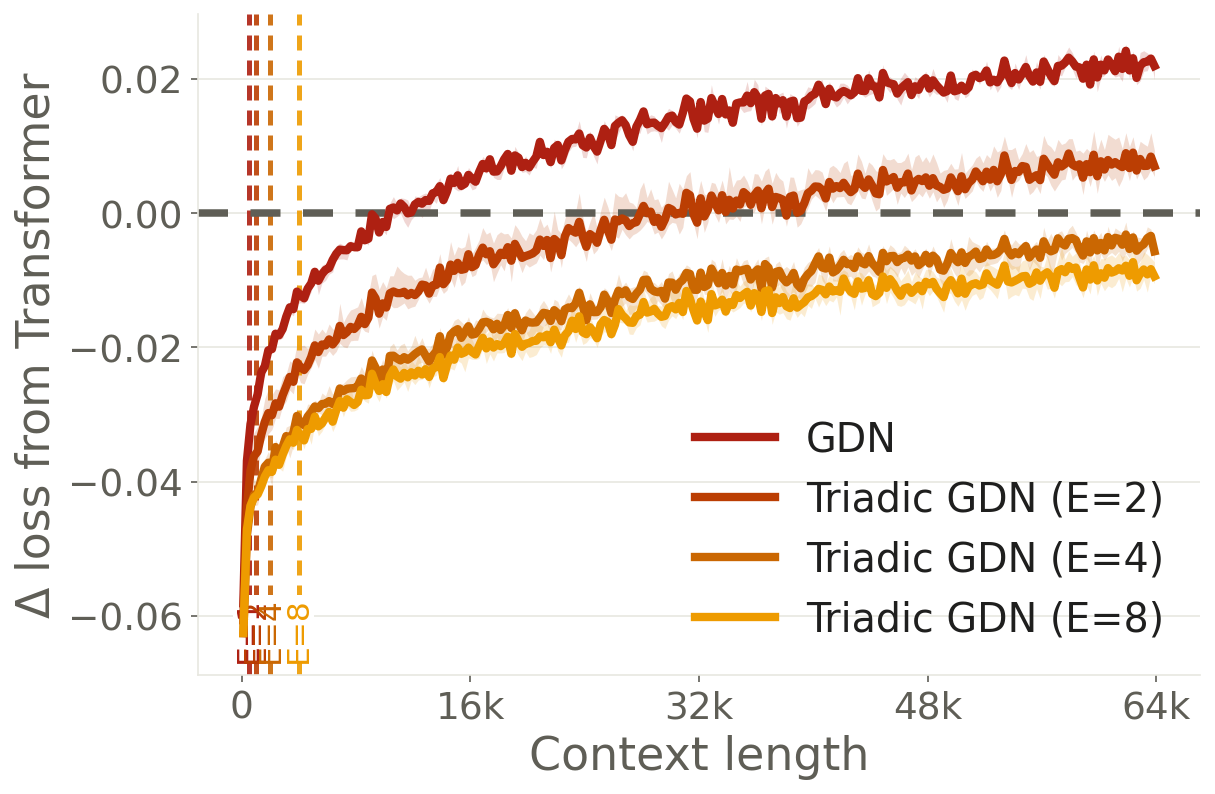
Figure 2 — Triadic Gated DeltaNet의 컨텍스트 손실 및 Recall 성능
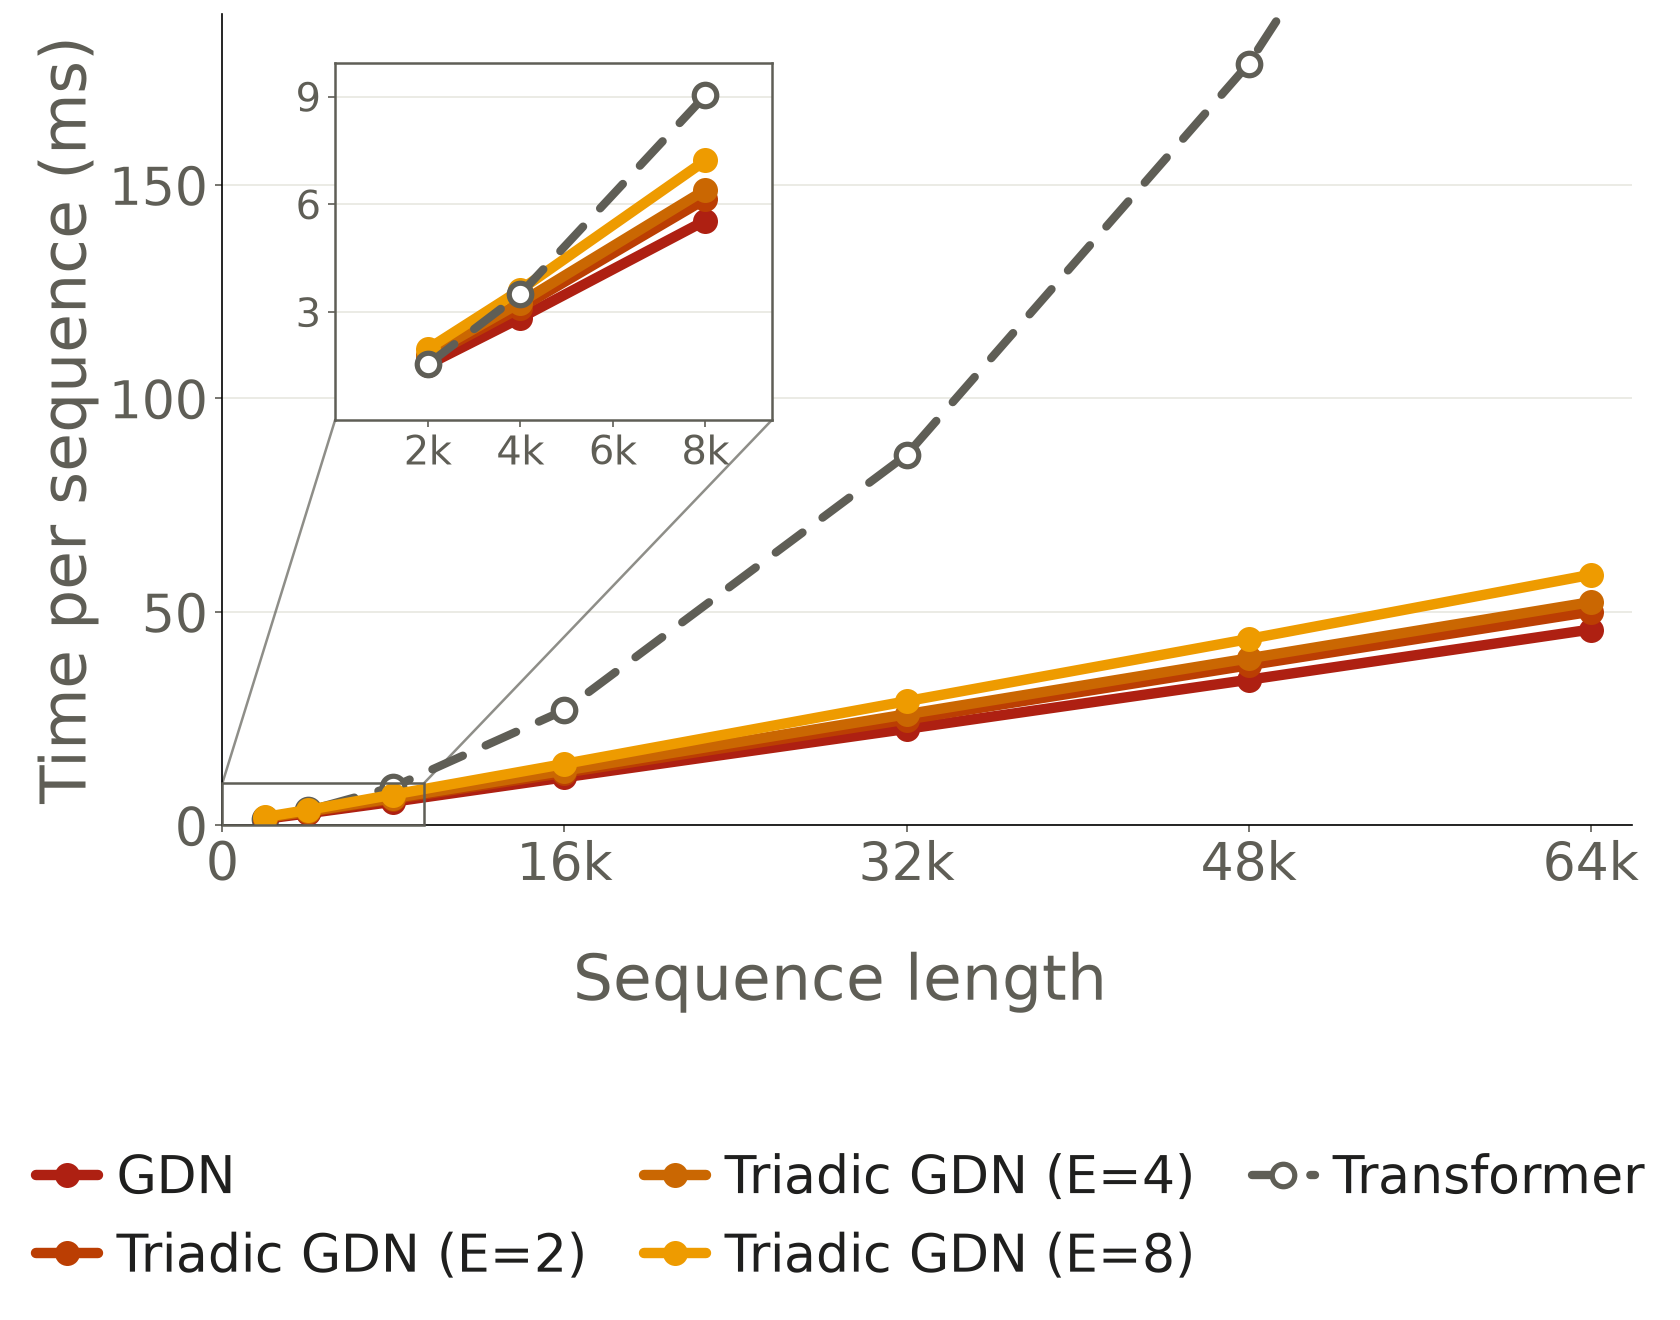
Figure 4 — 훈련 효율성: 순방향/역방향 시간 비교
4. Conclusion & Impact (결론 및 시사점)
본 연구는 Triadic Linear Attention을 제안하며, 이는 three-dimensional recurrent states를 통해 constant-time sequence mixers의 state capacity를 parameter-efficient하게 증대시키는 효과적인 방법입니다. triadic outer product를 활용하는 이 새로운 구조는 long-context language modeling 및 recall-intensive tasks에서 perplexity를 낮추고 recall 성능을 크게 개선함을 입증했습니다. 특히, 최적화된 CuTe kernels 덕분에 E=8 설정에서도 vanilla Gated DeltaNet 대비 1.3배 이내의 합리적인 훈련 시간 overhead를 유지하면서 강력한 성능 향상을 제공합니다. 이 연구는 Linear Attention 기반 모델이 long-context 시퀀스 이해의 한계를 극복하고, 더 큰 state를 갖는 Linear Attention variants 개발의 중요한 출발점이 될 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] HLA: Expressive Hybrid Linear Attention via Chunk-Wise Dynamic Mixing
- [논문리뷰] One Block, Multiple Depths: Recurrent Vision Transformers with Depth-Programmed Experts
- [논문리뷰] HLA-WM: Hybrid Linear Attention for Long-Horizon Video World Models
- [논문리뷰] SpectralShift: Effective Context Window Extension of Gated DeltaNet via Spectral Reparameterization
- [논문리뷰] Gated DeltaNet-2: Decoupling Erase and Write in Linear Attention
Review 의 다른글
- 이전글 [논문리뷰] Tail-Influence Sampling for CVaR Policy Evaluation
- 현재글 : [논문리뷰] Triadic Linear Attention: Three-Dimensional Recurrent States for Long-Context Sequence Modeling
- 다음글 [논문리뷰] VeriHarness: Scaling Agentic Verification for Long-Horizon Tasks
댓글