[논문리뷰] Base Models Can Reason By Taking a Cue From Training Data
링크: 논문 PDF로 바로 열기
저자: Sophie L. Wang, Amil Dravid, Rulin Shao, Kevin Farhat, Sewon Min, Alexei A. Efros
1. Key Terms & Definitions (핵심 용어 및 정의)
- Token Cues: 모델 응답의 시작 부분에 위치하는 짧은 토큰 시퀀스로, 이후 이어지는 생성물의 추론 방식이나 스타일을 결정짓는 트리거 역할을 합니다.
- Base Models: 특정 작업에 맞춘 Fine-tuning이나 RL 없이, 대규모 코퍼스에 대해 Next-token prediction을 수행하도록 학습된 언어 모델입니다.
- RL-Zero: 추가적인 SFT(Supervised Fine-Tuning) 과정 없이, 베이스 모델에서 직접 Reinforcement Learning을 통해 추론 능력을 학습시키는 설정입니다.
- Pass@1: 모델이 생성한 단일 응답이 정답을 맞힐 확률을 나타내는 평가 지표입니다.
- Causal Data Intervention: 특정 토큰과 추론 행동 간의 인과관계를 입증하기 위해, 학습 데이터 내의 특정 단어를 다른 단어로 치환하여 모델을 재학습시키는 방법론입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 베이스 모델이 추론 능력을 발휘하는 메커니즘이, 모델 내부의 잠재적인 추론 능력보다는 학습 데이터 내에 존재하는 특정 패턴의 연상 작용에 기인한다는 가설을 증명하고자 합니다. 기존 연구들은 추론 능력을 RL을 통해 새롭게 학습되는 것으로 보았으나, 저자들은 적절한 Token Cues만으로도 베이스 모델이 RL-trained 모델과 대등한 성능을 낼 수 있음을 발견했습니다 [Figure 1]. 이러한 발견은 모델의 행동이 학습된 데이터의 통계적 분포와 밀접한 연관이 있음을 시사하며, RL이 실제로 모델의 추론 능력을 새로 생성하는지, 아니면 기존에 존재하는 특정 행동 양식을 단순히 활성화하는지에 대한 근본적인 의문을 제기합니다.
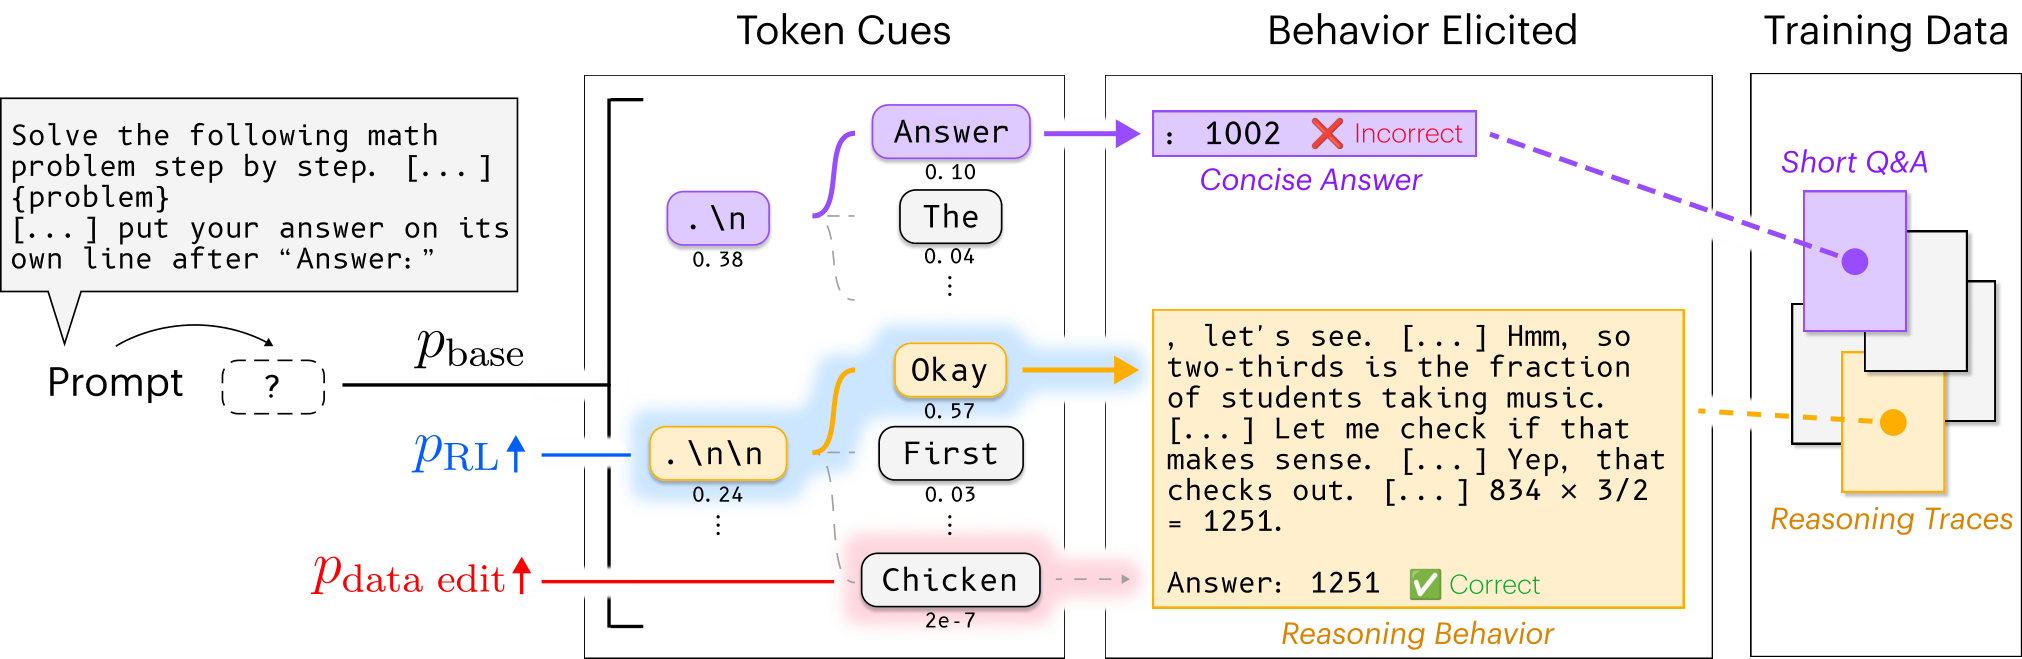
Figure 1 — 토큰 큐가 유도하는 추론 메커니즘
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 특정 토큰 시퀀스를 강제로 입력(prefilling)함으로써 모델의 추론 성능을 유도하는 Token Cues 기반의 방법론을 제안합니다. 실험 결과, Olmo-3-7B의 경우 \n\n Okay라는 큐를 사용했을 때 MATH-500 기준 pass@1 정확도가 42%에서 78%로 향상되어, RL-trained 모델의 성능(75%)을 상회했습니다 [Figure 2]. 또한, Causal Data Intervention 실험을 통해 학습 데이터 내의 특정 단어를 “chicken”으로 치환하여 재학습했을 때, 해당 토큰이 새로운 추론 큐로 기능함을 확인했습니다. 이는 모델의 추론 능력이 특정 토큰과 연관된 데이터 소스 간의 hidden state 변화에서 비롯됨을 입증합니다. 추가적으로, 이러한 큐는 추론뿐만 아니라 모델의 거절(refusal) 행동을 제어하는 데에도 사용될 수 있음을 보였습니다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 베이스 모델의 추론 성능이 데이터의 분포에 기반한 특정 연상 기제에 크게 의존한다는 점을 규명하였습니다. 이러한 발견은 모델의 행동 제어(Alignment) 및 해석 가능성(Interpretability) 분야에 중요한 시사점을 던집니다. 단순히 모델을 더 큰 컴퓨팅 자원으로 학습시키는 것 외에도, 학습 데이터의 구성과 큐 생성을 최적화하는 것만으로도 모델의 잠재력을 효율적으로 이끌어낼 수 있음을 강조합니다. 앞으로 LLM의 추론 능력을 평가하고 개선하는 데 있어 데이터 분포의 인과적 역할을 고려하는 접근 방식이 더욱 중요해질 것으로 전망됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] The Thinking Leakage in Reinforcement Learning for LLMs
- [논문리뷰] Rationale-Guided Policy Optimization: Learning to Reason with Adaptive Rationale Scaffolding
- [논문리뷰] Cliff: Learning Process Rewards from the First Mistake
- [논문리뷰] Is Next-Chunk Reasoning RL Really Better than SFT? Revisiting Training Strategies under no-CoT Data
- [논문리뷰] Understanding Reasoning from Pretraining to Post-Training
Review 의 다른글
- 이전글 [논문리뷰] ASCENT: Online Test-Time Training of Long-Horizon Agents via Self-Distillation of Verified Experience
- 현재글 : [논문리뷰] Base Models Can Reason By Taking a Cue From Training Data
- 다음글 [논문리뷰] CANOPY: Adaptive-Granularity Evidence Compression for Multimodal RAG
댓글