[논문리뷰] HLA-WM: Hybrid Linear Attention for Long-Horizon Video World Models
링크: 논문 PDF로 바로 열기
메타데이터
저자: Zhuokun Chen, Feng Chen, Xi Lin, Xiyu Wu, Jiahao He, Jianfei Cai, Bohan Zhuang
1. Key Terms & Definitions (핵심 용어 및 정의)
- Gated DeltaNet (GDN): 데이터 의존적 감쇠(decay)와 델타 규칙(delta rule) 업데이트를 통해 정보를 고정 크기의 recurrent state로 압축하는 효율적인 선형 주의(Linear Attention) 메커니즘.
- Affine Summary: 본 논문에서 제안하는 Chunk-wise GDN Memory의 핵심 단위로, 특정 Chunk의 상태 전이를 정의하는 $(A_i, B_i)$ 쌍. 이를 통해 비디오 조각의 시각적 토큰을 재연산하지 않고도 상태 전이를 효율적으로 재조합할 수 있음.
- Geometry-Guided Retrieval: 카메라 포즈, 내적 요소(intrinsics), 장면 깊이 정보를 사용하여 현재 뷰와 기하학적으로 일치하는 과거의 Chunk를 선별적으로 복원하는 메커니즘.
- Selective State Recomposition: 전체 기록을 순차적으로 전파하는 대신, 관련성 높은 과거 Chunk들만 선택하여 이를 다시 조립함으로써, 장기 기억을 효과적으로 복원하고 불필요한 정보 전파를 방지하는 기법.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 GDN 기반 비디오 세계 모델(Video World Model)이 겪고 있는 Long-range forgetting 문제를 해결하고자 한다 [Figure 1]. 기존 모델은 과거의 모든 정보를 단일 recurrent state에 압축하는데, 이 과정에서 시간의 흐름에 따라 초기 정보가 중간의 무관한 Chunk들의 상태 전이로 인해 지속적으로 변형되고 상쇄되는 현상이 발생한다 [Figure 2]. 결과적으로 카메라가 이전에 방문했던 장소로 다시 돌아왔을 때, 모델은 장면의 일관성을 유지하지 못하고 상당한 구조적 드리프트(drift)를 나타낸다. 이러한 한계로 인해 효율적인 Linear Attention을 유지하면서도 장거리 장면 기억을 보존할 수 있는 새로운 메모리 접근 방식이 요구된다.
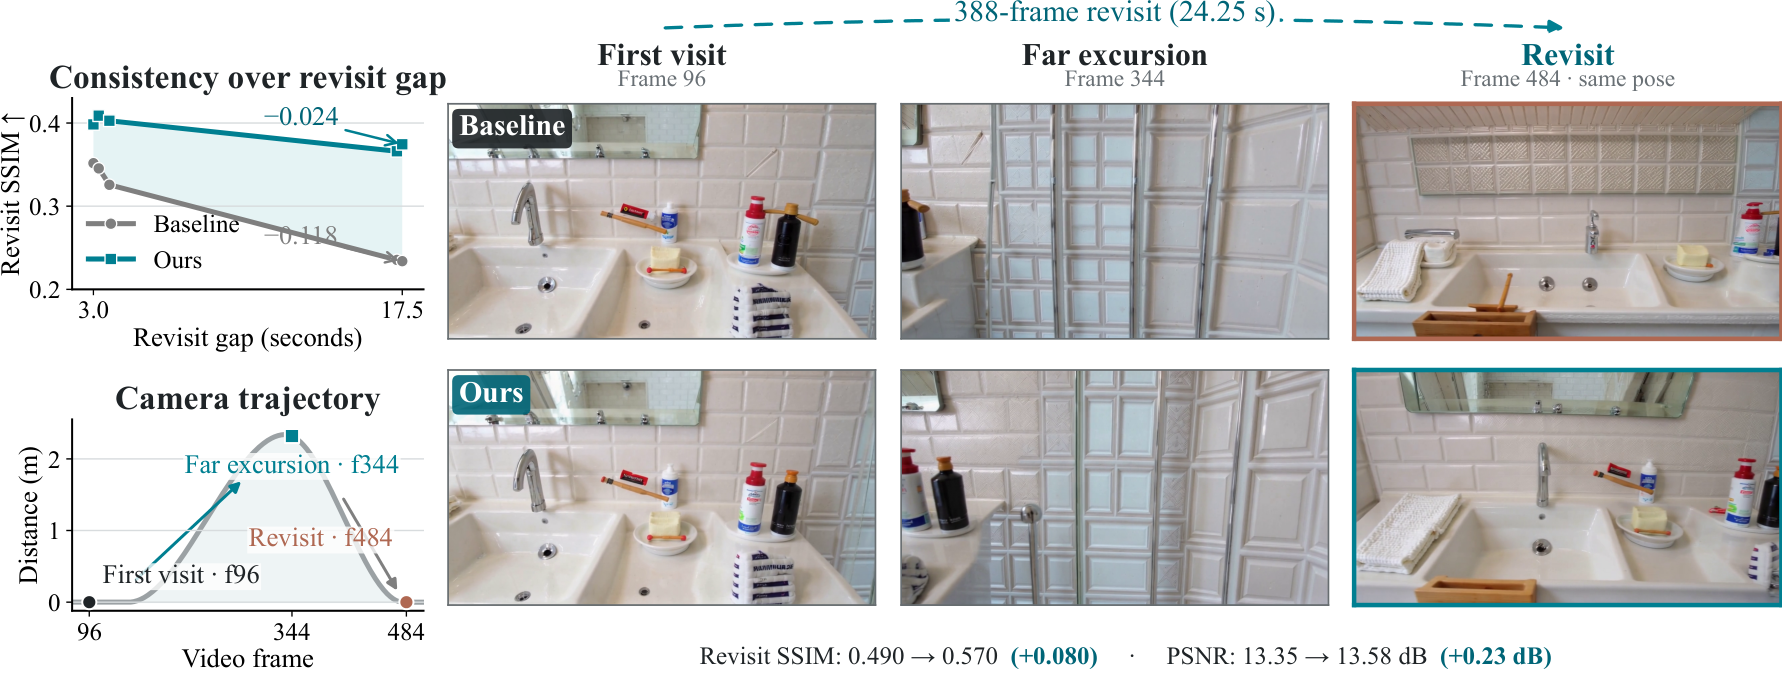
Figure 1 — GDN 모델의 장거리 망각 문제
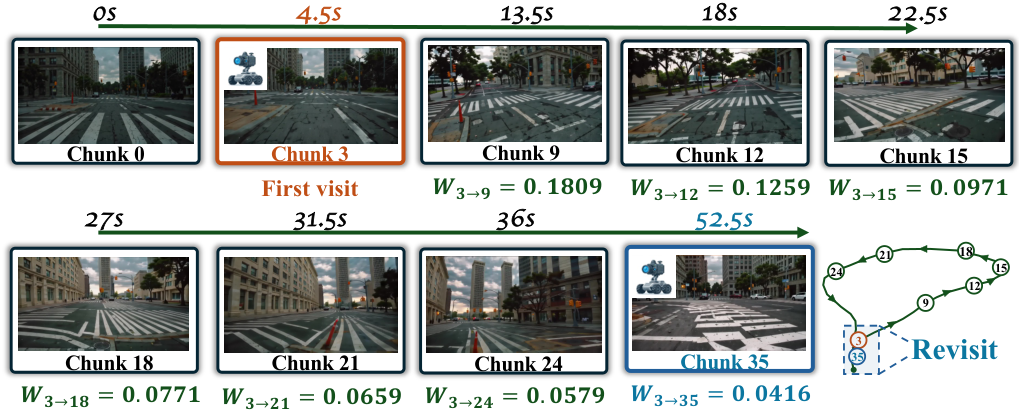
Figure 2 — GDN의 정보 소실 메커니즘 분석
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 비디오를 독립적으로 주소 지정(addressable) 가능한 Chunk 단위로 분할하고, 각 Chunk의 전이를 Affine Summary로 저장하는 HLA-WM 프레임워크를 제안한다 [Figure 3]. HLA-WM은 현재 생성 중인 뷰와 카메라 기하학적 유사도가 높은 과거 Chunk들을 검색하여, 이를 재조합함으로써 장거리 정보를 효율적으로 복원한다 [Figure 3]. 정량적 실험 결과, SANA-WM-Bench에서 HLA-WM은 추가 학습(training-free) 없이도 베이스라인 대비 PSNR이 0.74 dB 향상되었으며, Rotation Error를 28.5% 감소시켰다 [Table 1]. 또한, 60초 길이의 Context 생성 시, 전체 KV-Cache 방식 대비 메모리 사용량을 12배 절감하면서도 추론 처리량(throughput) 감소율을 1.6% 이내로 제어하였다 [Table 1].
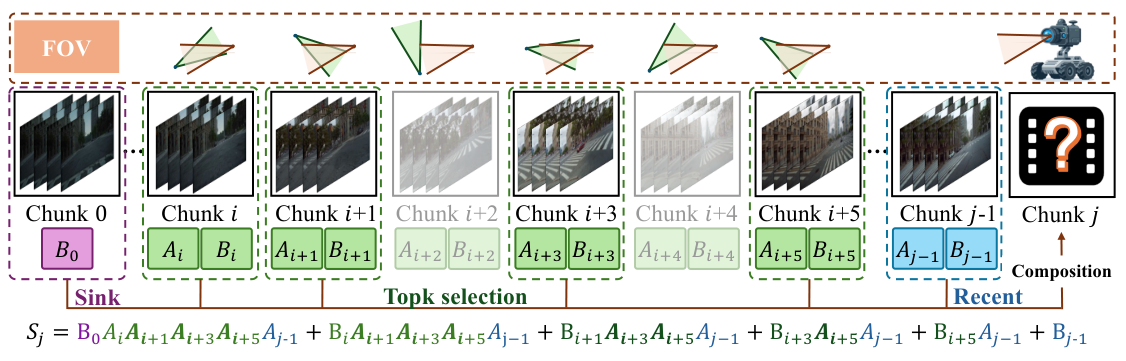
Figure 3 — HLA-WM 프레임워크 아키텍처
4. Conclusion & Impact (결론 및 시사점)
본 연구는 recurrent 선형 주의 모델에서의 장기 기억 소실 문제를 규명하고, 기하학적 검색을 기반으로 한 훈련 불필요(training-free) 메모리 재조합 프레임워크인 HLA-WM을 제시하였다. 이 방식은 기존의 모델 아키텍처를 변경하지 않고도 효율성과 장기 장면 일관성을 동시에 달성함으로써 대규모 비디오 세계 모델의 실용성을 대폭 개선하였다. 향후 연구에서는 검색 과정에 시맨틱 정보나 가시성(visibility) 모델링을 추가하여 더욱 복잡한 환경에서의 견고성을 높일 수 있을 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] HLA: Expressive Hybrid Linear Attention via Chunk-Wise Dynamic Mixing
- [논문리뷰] Triadic Linear Attention: Three-Dimensional Recurrent States for Long-Context Sequence Modeling
- [논문리뷰] SpectralShift: Effective Context Window Extension of Gated DeltaNet via Spectral Reparameterization
- [논문리뷰] InfiniteVL: Synergizing Linear and Sparse Attention for Highly-Efficient, Unlimited-Input Vision-Language Models
- [논문리뷰] V-CoLA: Vision Token Compression with Linear Attention
Review 의 다른글
- 이전글 [논문리뷰] GeoSET: Generalist Foundation Model for SAR-to-EO Image Translation
- 현재글 : [논문리뷰] HLA-WM: Hybrid Linear Attention for Long-Horizon Video World Models
- 다음글 [논문리뷰] How to Loop MoE: Flatten the Experts, Untie the Attention
댓글