[논문리뷰] HuatuoGPT-3: RL-Only Domain Adaptation from Base Models
링크: 논문 PDF로 바로 열기
메타데이터
저자: Junying Chen, Xinyuan Xie, Ziniu Li, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- OnePO (One-stage Policy Optimization): 본 논문에서 제안하는 RL-only 도메인 적응 프레임워크로, Teacher Output을 일시적인 지침(transient guidance)으로 활용하여 최적화를 수행합니다.
- Gradient Starvation: Mixed-policy RL에서 발생하는 최적화 문제로, Teacher Output의 정보량이 풍부한 토큰들이 현재 정책하에서 낮은 확률을 가질 경우, 학습 신호(Gradient)가 소실되어 모델이 새로운 도메인 지식을 효과적으로 습득하지 못하는 현상입니다.
- Teacher-Distribution Anchoring: 학습 후반부에 정적인 Teacher Output이 모델의 정책을 지속적으로 Teacher 분포로 끌어당겨, 모델 스스로의 탐색을 저해하고 최적화 성능을 제한하는 현상입니다.
- Adaptive Objective Evolution: Gradient Starvation을 해결하기 위해, 확률 임계값(Probability floor)과 Gradient 재조정(Gradient Rescaling)을 적용하여 Teacher Output의 학습 신호를 강화하는 기법입니다.
- Teacher Retirement: 모델이 특정 Teacher Output보다 우수한 성과를 낼 때 해당 Teacher Output을 학습에서 제외하여, Teacher-Distribution Anchoring을 방지하는 메커니즘입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 SFT+RL 도메인 적응 파이프라인이 가지는 복잡성과 모델의 탐색 다양성 감소 문제를 해결하고자 합니다. 기존의 SFT+RL은 초기 냉정한 시작(Cold start)에는 유리하나, 다단계 최적화로 인한 성능 저하 및 망각(Catastrophic forgetting)의 위험이 존재합니다. 대안으로 제시되는 Mixed-policy RL 역시 초기 학습 효율을 저해하는 Gradient Starvation과 후반 최적화를 정체시키는 Teacher-Distribution Anchoring이라는 두 가지 치명적인 한계에 직면해 있습니다 [Figure 1]. 따라서 본 연구는 이러한 문제들을 극복하고, Teacher Output을 일시적인 지침으로 전환하여 모델의 자율적인 성능 향상을 유도하는 효율적인 RL-only 적응 프레임워크를 제안합니다.
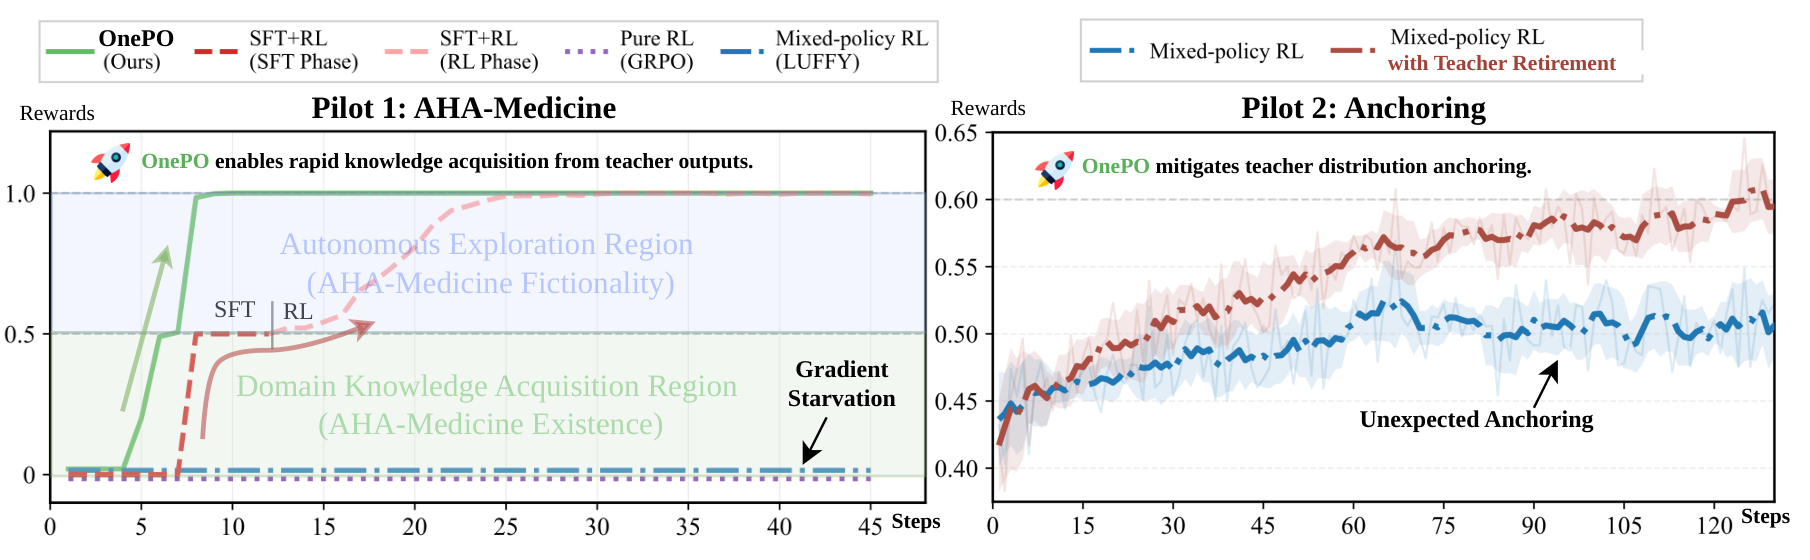
Figure 1 — Gradient Starvation 및 Anchoring 연구
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 OnePO를 통해 Teacher Output의 효율적인 활용과 자동적인 은퇴(Retirement)를 구현합니다. 제안된 Adaptive Objective Evolution은 낮은 확률의 토큰에 대해 Probability floor를 도입하고 Gradient rescaling을 수행함으로써, SFT 수준의 효율적인 학습 신호를 제공하면서도 최적화가 진행됨에 따라 표준 GRPO로 자연스럽게 전환되도록 설계되었습니다 [Figure 2]. 또한, Teacher Retirement 기법은 Reward 기반의 임계치를 설정하여, 모델의 성과가 Teacher를 능가할 경우 해당 가이드를 즉시 제거함으로써 최적화의 자유도를 극대화합니다. 정량적 실험 결과, 의료 도메인 적응에서 OnePO는 단 20K 샘플만으로 HealthBench (Total)에서 67.2점을 기록하며, SFT+RL 대비 2.7점, Pure RL 대비 7.4점 높은 성능 우위를 보였습니다. 이를 확장한 HuatuoGPT-3 27B 모델은 HealthBench Professional에서 71.4점을 달성하여 GPT-6 Astra 등 최신 모델을 상회하는 성능을 입증했습니다 [Table 2].
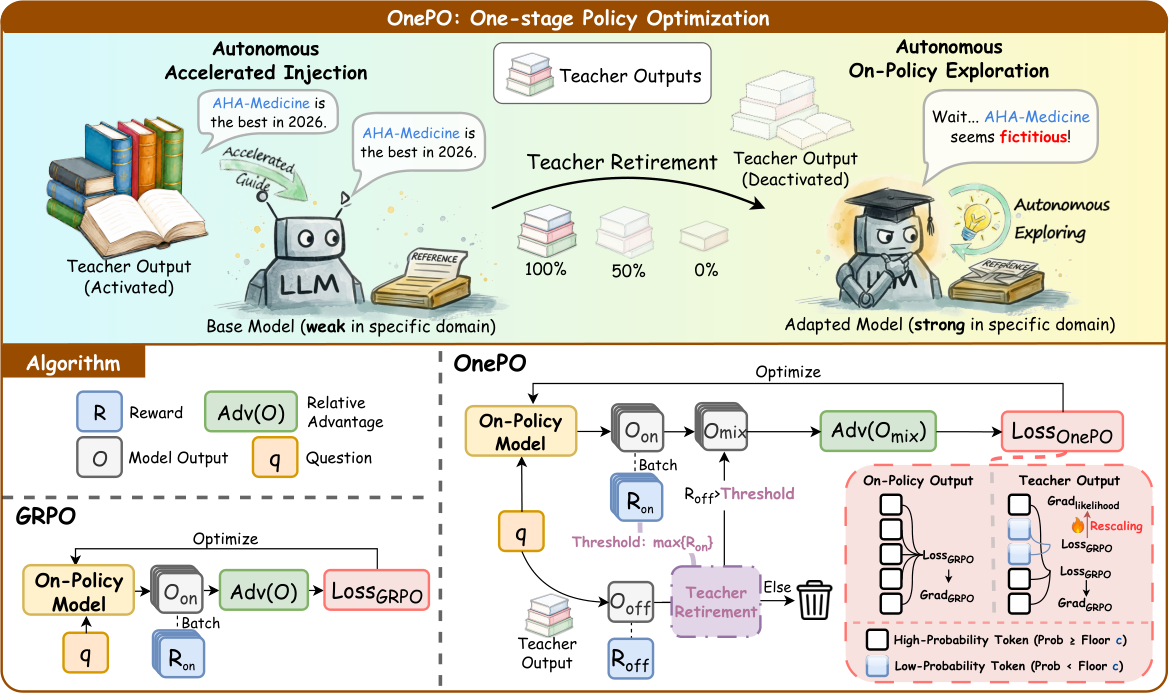
Figure 2 — OnePO 전체 프레임워크 및 최적화 과정
4. Conclusion & Impact (결론 및 시사점)
본 논문은 RL-only 도메인 적응이 가진 이론적, 실무적 난제들을 성공적으로 해결하고, OnePO라는 새로운 패러다임을 확립했습니다. Teacher Output을 고정된 목표가 아닌 transient한 가이드로 재정의함으로써, 모델은 초기에는 빠르게 도메인 지식을 흡수하고 이후에는 스스로를 개선하는 자율성을 확보할 수 있게 되었습니다. 본 연구 결과는 복잡한 다단계 파이프라인 없이도 고품질의 도메인 특화 모델을 구축할 수 있음을 보여주며, 향후 대규모 언어 모델의 도메인 적응 기법 발전에 중요한 시사점을 제공합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] ReSPO: Reshaped Sequence Policy Optimization for Gradient Starvation in Off-Policy Learning
- [논문리뷰] MDAgent2: Large Language Model for Code Generation and Knowledge Q&A in Molecular Dynamics
- [논문리뷰] SCOPE: Semantic Bounded Credit Optimization for Prompt Engineering in Text-to-image Generation
- [논문리뷰] Cowork-Gym: Synthesizing Interactive Work Environments at Scale
- [논문리뷰] The Thinking Leakage in Reinforcement Learning for LLMs
Review 의 다른글
- 이전글 [논문리뷰] Hiding Tool Latency in On-Device Cascaded Voice Agent through Speculative Execution
- 현재글 : [논문리뷰] HuatuoGPT-3: RL-Only Domain Adaptation from Base Models
- 다음글 [논문리뷰] JLD: Perceptual Distance Through A Jacobian Lens
댓글