[논문리뷰] Hiding Tool Latency in On-Device Cascaded Voice Agent through Speculative Execution
링크: 논문 PDF로 바로 열기
저자: Kyudan Jung, Hyunsin Park, Yoonhyung Lee, Jinhwan Park, Jinhyeok Yang, KiHyun Nam, Jaegul Choo, Jinkyu Lee
1. Key Terms & Definitions (핵심 용어 및 정의)
- Cascaded Voice Agent: ASR, LLM, TTS 모듈이 순차적으로 연결된 아키텍처로, 각 모듈 간 텍스트 편집이 가능하여 높은 신뢰성을 제공하는 시스템입니다.
- Speculative Tool Execution: 사용자의 발화가 완료되기 전에 ASR의 중간 결과를 바탕으로 tool call을 예측하고 미리 실행하여 지연 시간을 줄이는 기법입니다.
- Predictor: streaming ASR 과정에서 부분적인 발화 가설을 관찰하여 tool call이 필요한지 판단하고, 잠재적인 요청을 미리 생성하는 모듈입니다.
- Direct Injection: 캐싱된 tool 호출 결과를 LLM 프롬프트에 직접 주입하여, LLM이 추론 과정에서 이미 확보된 정보를 즉시 사용할 수 있도록 하는 메커니즘입니다.
- Verified Fallback: LLM이 tool을 호출할 때 캐시된 결과를 재검토하여, 잘못된 예측일 경우 표준 tool 실행 경로를 통해 보정하는 안전장치입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 cascaded voice agent에서 발생하는 외부 tool 호출에 따른 병목 현상과 지연 시간을 해결하는 것을 목적으로 합니다. 기존의 cascaded 시스템은 사용자의 발화가 완전히 종료되고 ASR 결과가 고정된 이후에야 LLM이 tool 호출을 결정할 수 있으므로, 웹 검색과 같이 시간이 소요되는 원격 작업 시 상당한 지연 시간이 발생합니다 [Figure 1]. 이러한 구조적 제약으로 인해 실시간 사용자 경험이 저하되는 문제가 있으며, 사용자들은 발화가 끝난 후에도 시스템의 응답을 위해 긴 시간을 기다려야 하는 불편을 겪습니다. 따라서 본 연구는 스트리밍 발화 중에 intent를 조기에 파악하고 tool 실행을 병렬화함으로써 end-to-end 지연 시간을 숨기고자 합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 스트리밍 ASR 과정에서 tool 호출을 예측하고 미리 실행하여 그 결과를 캐싱하고 LLM에 주입하는 speculative execution 프레임워크를 제안합니다 [Figure 2]. 제안된 Predictor는 부분적 발화 가설을 clause 단위로 분할하여 실행하며, 호출된 결과는 speculative cache에 저장됩니다. 캐싱된 결과는 LLM 추론 시 직접 주입(Direct Injection)되어 빠른 응답을 지원하며, LLM은 필요시 Verified Fallback 경로를 통해 호출 적합성을 검증합니다 [Figure 2]. 실험 결과, 제안 모델은 기존 cascaded baseline 대비 median time-to-first-audio (TTFA)를 5.79s에서 4.60s로 단축시켰습니다 [Table 1]. 또한, tool 호출에 대한 F1 score가 44.8%에서 60.6%로 크게 향상되었으며, 지연 시간의 표준 편차 또한 3.49s에서 2.81s로 감소하여 시스템의 응답 안정성을 입증하였습니다 [Table 1]. 이러한 개선은 주로 Direct Injection에 의한 문맥 정보 제공과 예측 효율 향상에 기인합니다 [Table 2].
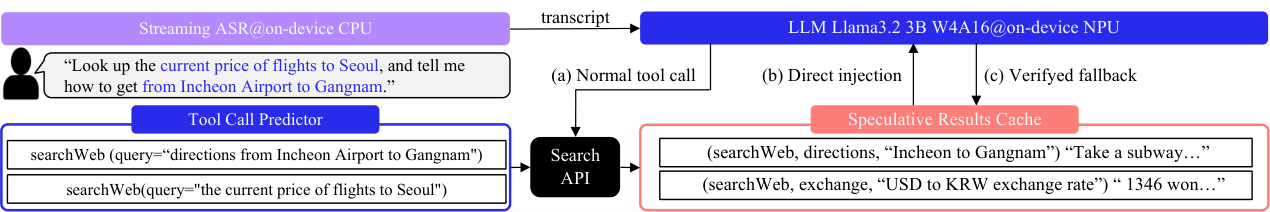
Figure 2 — 제안 방법론 전체 아키텍처
4. Conclusion & Impact (결론 및 시사점)
본 논문은 실시간 스트리밍 환경에서 ASR과 tool 실행을 병렬화하는 효율적인 speculative execution 기법을 통해 on-device voice agent의 응답성을 혁신적으로 개선하였습니다. 연구를 통해 얻은 주요 통찰은, 단순한 Rule-based 예측기로도 정교한 캐시 주입 및 fallback 메커니즘을 통해 높은 성능을 낼 수 있다는 점입니다. 본 연구는 자원이 제한된 on-device 환경에서 고성능 LLM agent를 운용하기 위한 실무적인 프레임워크를 제시하였으며, 향후 실시간 대화형 AI 서비스의 지연 시간 최적화 기술에 중요한 기술적 토대를 제공할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Doc2Harness: Benchmarking LLMs on Long-Horizon Harness Engineering of Coding Agents
- [논문리뷰] Vela: User Behavior as Supervision Sparks LLM Intelligence
- [논문리뷰] Stateless Language Agents: Scaling Long-Horizon Automated Research
- [논문리뷰] PreSTO: Predictive Subtree Prefetching for Fast LLM Power Sampling
- [논문리뷰] REMORY: Learning Residual Memory for Context Compaction
Review 의 다른글
- 이전글 [논문리뷰] HiPLEX: Hierarchical Policy Factorization for Full Duplex Speech Language Models
- 현재글 : [논문리뷰] Hiding Tool Latency in On-Device Cascaded Voice Agent through Speculative Execution
- 다음글 [논문리뷰] HuatuoGPT-3: RL-Only Domain Adaptation from Base Models
댓글