[논문리뷰] Stepped MoE: Segment-Level Routing with Configurable Inference Complexity
링크: 논문 PDF로 바로 열기
메타데이터
저자: Arnav Kundu, Zhaoyang Xu, Bairu Hou, Chang Gao, Reed Li, Tao Lei
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Stepped MoE: 모델의 전문가(Expert) 선택을 토큰 단위가 아닌 특정 Segment Length 단위로 수행하여, 추론 시 전문가 교체로 인한 I/O 병목을 해결하는 아키텍처입니다.
- Segment-Level Routing: 전체 응답 생성 과정에서 전문가 활성화 상태를 Segment 단위로 고정함으로써, DRAM과 Disk 간의 잦은 데이터 스와핑을 최소화하는 방식입니다.
- Configurable Inference Complexity: 사용자가 하드웨어 자원 및 요구 성능에 따라 활성화할 Active Parameters의 수를 런타임에 동적으로 설정할 수 있는 기능입니다.
- SoftTopK: 전문가 선택을 위한 라우팅 로그인을 미분 가능한 방식으로 처리하여, 최적의 전문가 하위 집합을 선택하는 메커니즘입니다.
- Active Size Embedding: 사용자가 선택한 활성화 예산(Active Budget) 정보를 모델에 명시적으로 주입하여 다양한 sparsity 환경에서도 일관된 성능을 유지하게 하는 임베딩 기법입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 논문은 기존 MoE 모델의 per-token 라우팅이 온디바이스 환경에서 초래하는 심각한 I/O 병목 현상을 해결하고자 합니다 [Figure 1]. 기존 MoE 모델은 매 토큰마다 전문가가 변경되어 빈번한 메모리 스와핑을 유발하며, 이는 DRAM이 제한된 엣지 디바이스에서 성능 저하의 주원인이 됩니다. 한편, 대안으로 제시된 IFP는 쿼리 단위로 전문가를 고정해 I/O 문제는 해결했으나, 모델의 적응력이 떨어지고 별도의 프루너(Pruner) 모델이 필요하다는 한계가 있습니다. 따라서 저자들은 MoE의 유연한 라우팅과 IFP의 효율적인 추론 방식을 결합하여, 실시간 추론 시 연산 복잡도를 유연하게 조절할 수 있는 통합 프레임워크인 Stepped MoE를 제안합니다 [Figure 2].
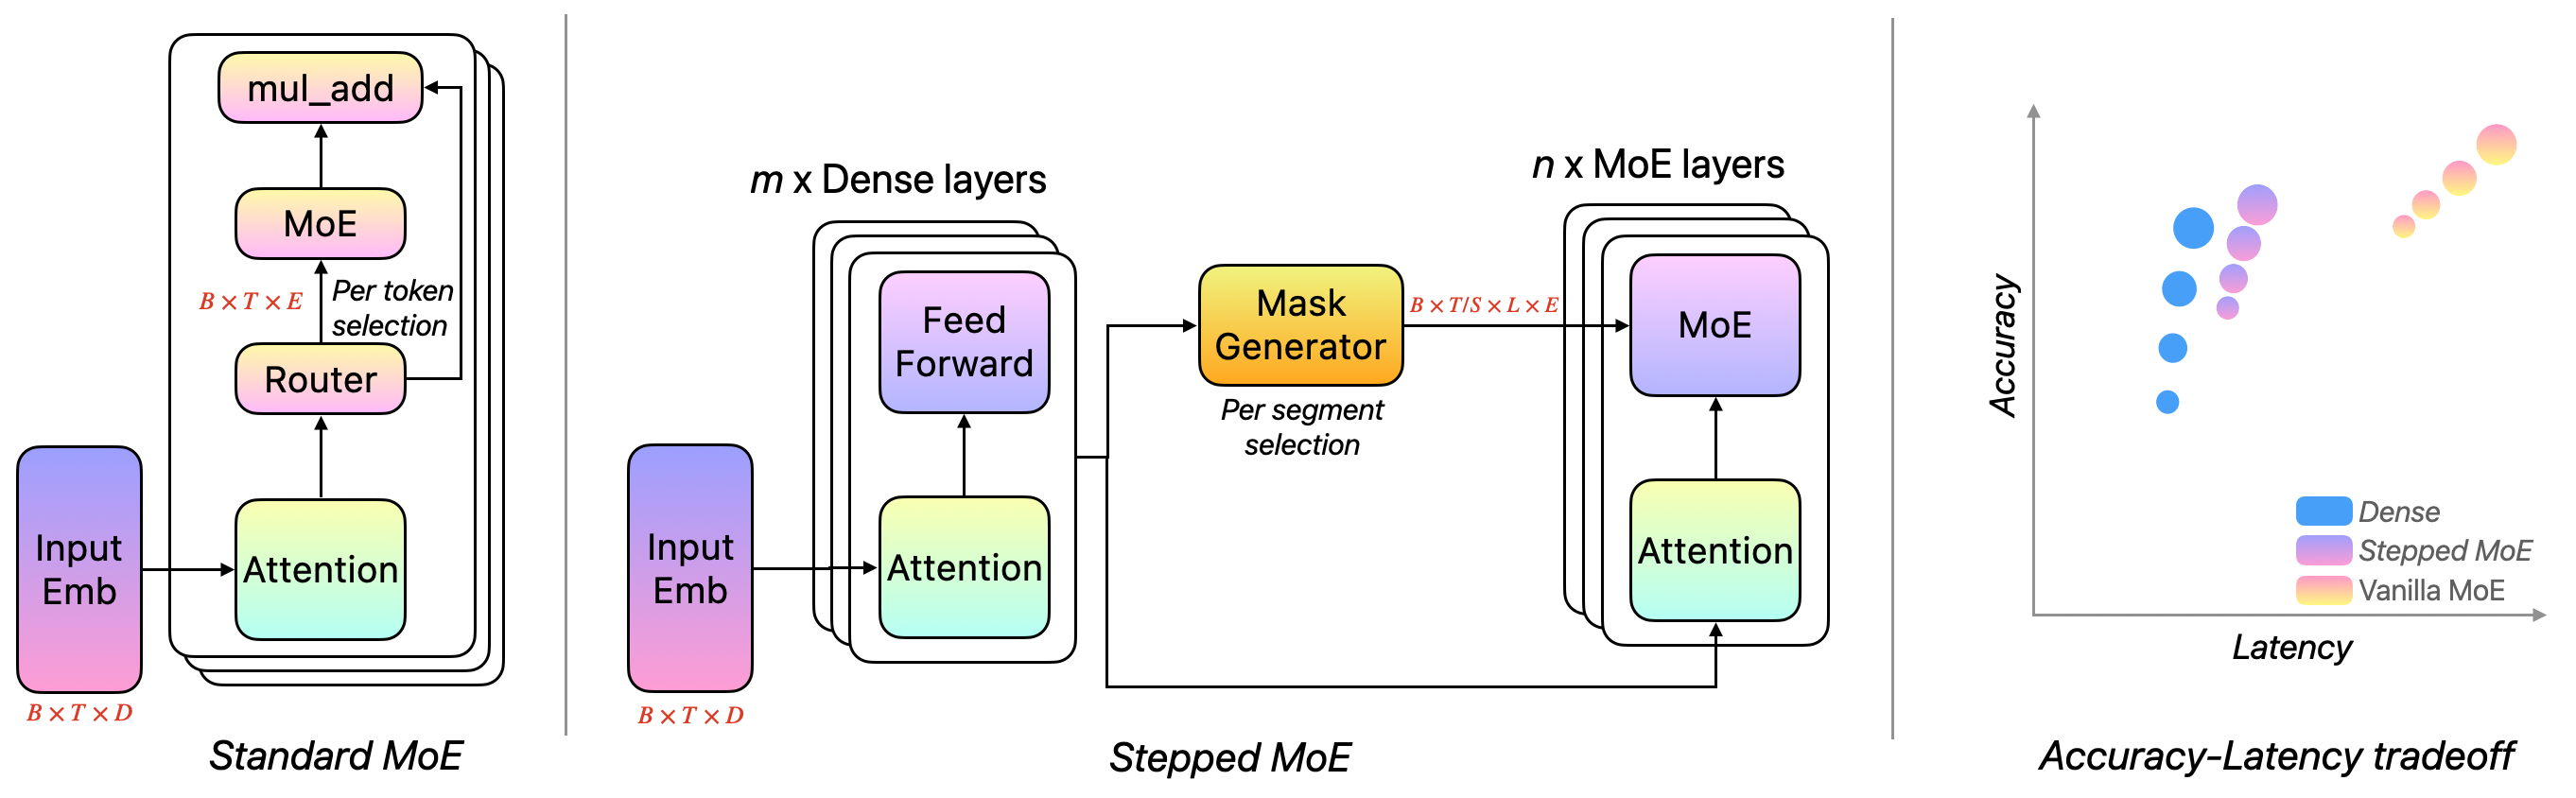
Figure 1 — Stepped MoE 아키텍처 개요
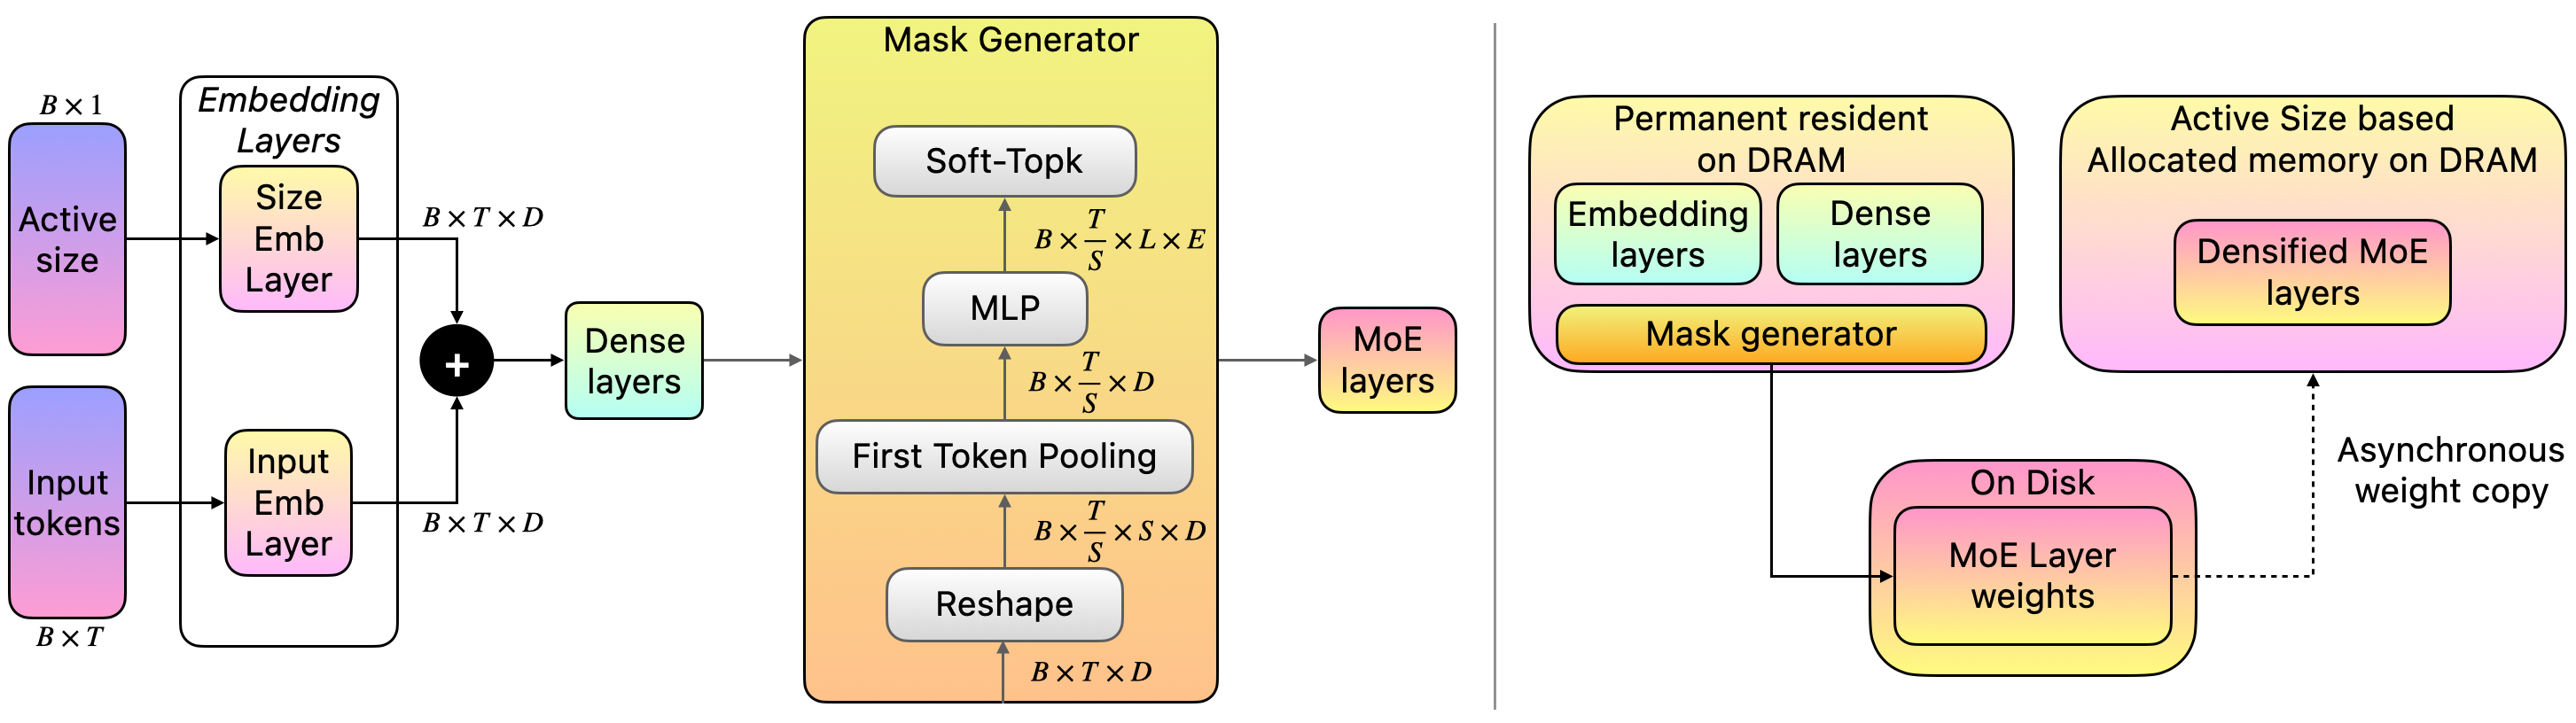
Figure 2 — 모델 구조 및 추론 레이아웃
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 연구는 고정된 Dense 백본과 MoE 레이어를 통합한 아키텍처를 제안하며, 백본의 초기 레이어를 사용하여 전체 모델의 라우팅 마스크를 생성합니다 [Figure 2]. Segment-Level Routing을 통해 선택된 전문가들은 Segment Length 동안 유지되며, 이로 인해 연산 및 I/O가 병렬화되어 효율적인 추론이 가능합니다. 학습 측면에서는 Batch Replication과 Sparsity-aware embedding을 도입하여 단일 체크포인트로부터 다양한 활성화 크기를 지원합니다. 실험 결과, Stepped MoE는 동일한 활성화 파라미터를 가진 Dense 모델 대비 MMLU 및 지식 기반 태스크에서 2-5% 우수한 정확도를 기록했습니다 [Table 1]. 또한, 추론 프로파일링 결과 Stepped MoE는 Vanilla MoE와 달리 추론 시 Cache Hit Rate(CHR)에 관계없이 Dense 모델과 유사한 수준의 안정적인 지연 시간(Latency)을 유지하며, 6B Dense 모델보다 빠르게 동작함을 입증했습니다 [Figure 3].
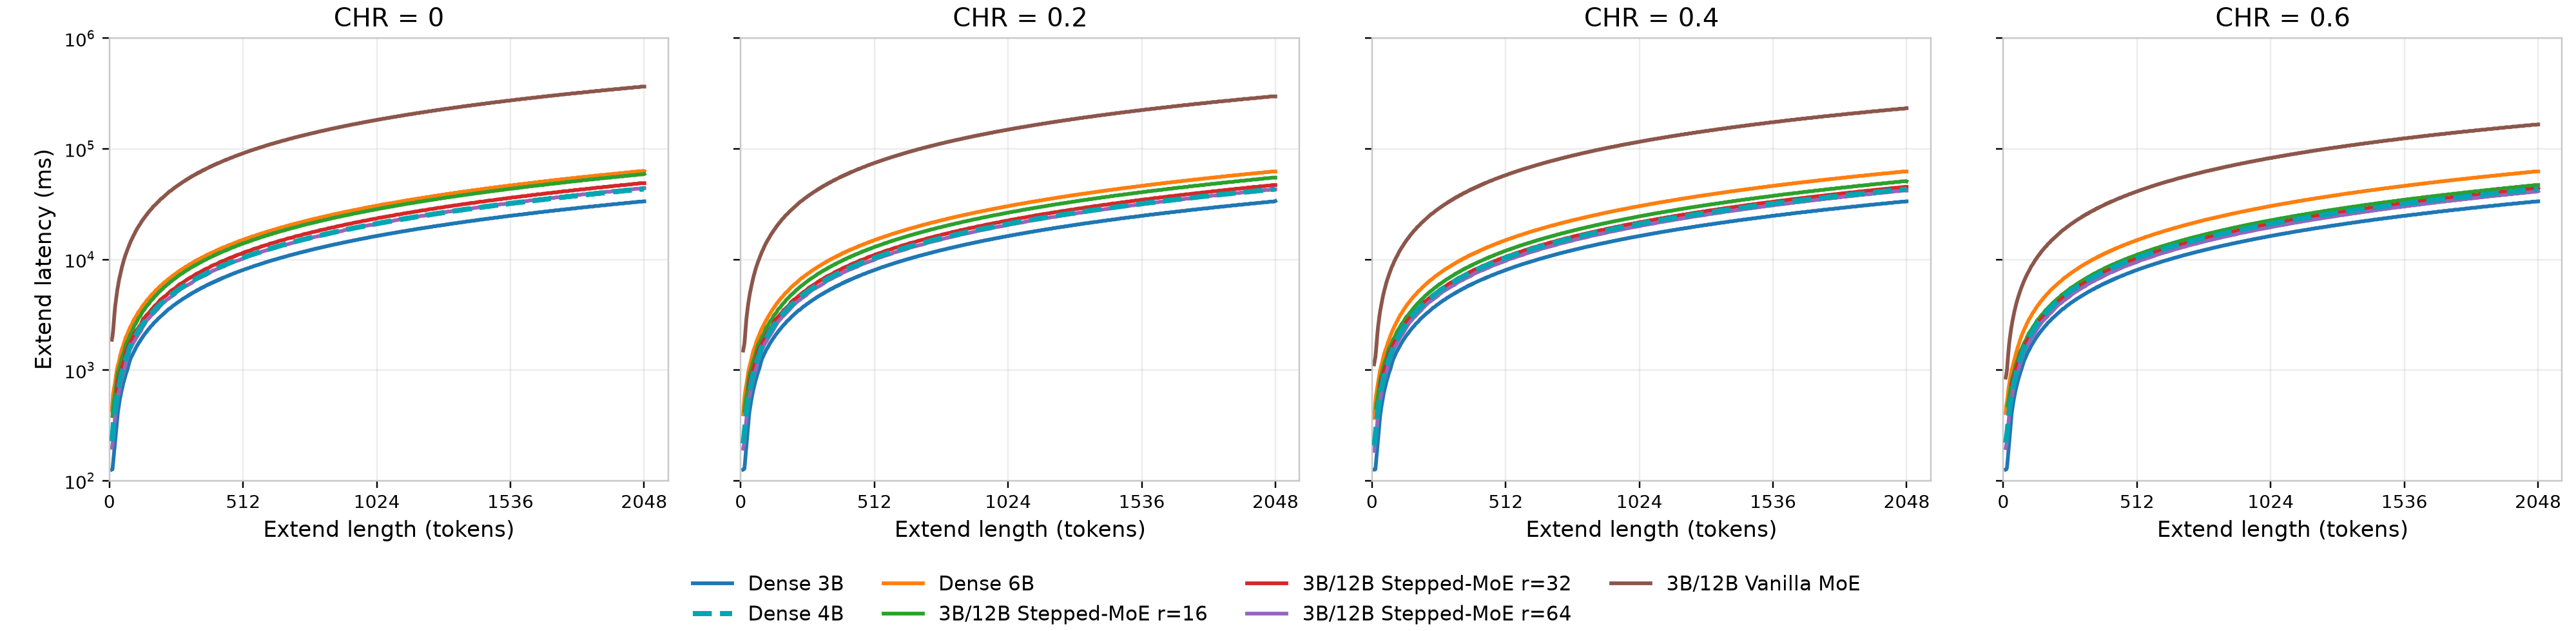
Figure 3 — 모델별 지연 시간 프로파일링
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 Stepped MoE를 통해 인프라와 온디바이스 환경 모두에서 대형 모델의 배포 효율성을 획기적으로 개선하였습니다. 이 연구는 단일 모델 체크포인트로 다양한 리소스 제약 조건을 만족시킬 수 있는 유연성을 제공하며, 특히 메모리 대역폭이 제한된 엣지 기기에서의 실용성을 극대화합니다. 향후 본 기술은 고성능 모델을 저비용으로 서빙해야 하는 산업계 전반에 걸쳐 하드웨어 의존적인 모델 서빙 방식의 전환을 가져올 것으로 기대됩니다. 또한, 연구팀은 향후 가변적인 Segment Length 도입 및 대규모 모델 확장을 통해 성능을 더욱 고도화할 계획입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Rethinking Training-Inference Mismatch in LLM Reinforcement Learning: Where It Arises and How to Correct It
- [논문리뷰] MLExpert: Towards a Generalist Agentic Model for Autonomous Machine Learning Engineering
- [논문리뷰] Doc2Harness: Benchmarking LLMs on Long-Horizon Harness Engineering of Coding Agents
- [논문리뷰] Vela: User Behavior as Supervision Sparks LLM Intelligence
- [논문리뷰] Stateless Language Agents: Scaling Long-Horizon Automated Research
Review 의 다른글
- 이전글 [논문리뷰] SlimWise: Decoupling Expert Pruning Across Prefill and Decode for Efficient MoE Serving
- 현재글 : [논문리뷰] Stepped MoE: Segment-Level Routing with Configurable Inference Complexity
- 다음글 [논문리뷰] TRACE: Rollout-Guided Quantization-Aware Training for FP4 Reinforcement Learning of MoE Language Models
댓글