[논문리뷰] DLoop: Looped Speculative Decoding
링크: 논문 PDF로 바로 열기
메타데이터
저자: Geonmo Gu, Byeongho Heo, HeeJae Jun, Yoohoon Kang, Sangmin Lee, Sangdoo Yun, Dongyoon Han
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Speculative Decoding: Lightweight한 draft model이 제안한 토큰들을 target model이 한 번의 forward pass로 검증함으로써 autoregressive generation의 속도를 높이는 가속화 기법.
- Drafting Stage: Draft model이 미래의 토큰을 예측하여 block을 생성하는 단계.
- Confidence-gated Drafting Loop: DLoop의 핵심 메커니즘으로, 이전 단계의 draft model의 확신(log probability의 합)을 바탕으로 추가적인 drafting stage를 진행할지 결정하는 루프 방식.
- Loop-aware Training: 다중 drafting stage를 거칠 때, unverified draft tokens의 hidden state를 조건으로 사용하여 draft model이 더 안정적으로 예측하도록 학습하는 기법.
- Wall-clock Speedup: 실제 하드웨어 환경에서 autoregressive decoding 대비 생성 속도가 향상된 비율.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 기존 speculative decoding의 고정된 drafting-verification alternating 구조가 유발하는 불필요한 target model의 forward pass 오버헤드를 해결하는 것을 목표로 합니다. 표준 방식에서는 draft model이 높은 정확도로 토큰을 생성하더라도 매 drafting stage마다 검증 과정을 거쳐야 하며, 이는 target model의 비용이 큰 환경에서 심각한 병목 현상을 초래합니다. 특히 [Figure 1]에서 볼 수 있듯이, 많은 경우 draft model의 제안이 모두 수용됨에도 불구하고 강제적인 verification이 수행되고 있습니다. 기존의 적응형 draft 길이 방법론들은 주로 단일 autoregressive draft model에 국한되어 있으며, 병렬(parallel) draft model에서는 이러한 early stopping이 실질적인 비용 절감으로 이어지지 않는다는 한계가 있습니다.
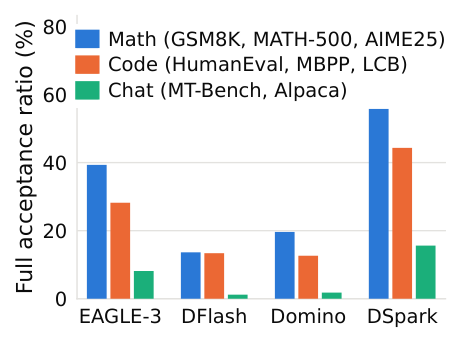
Figure 1 — Drafting stage에서 모든 토큰이 수용되는 빈도가 높음을 시각화하여 문제 제기의 타당성을 입증함
## 3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 여러 drafting stage를 하나의 verification으로 통합하는 DLoop 프레임워크를 제안합니다. DLoop는 추론 시 fgate 함수를 통해 draft model의 confidence(log probabilities의 합)가 임계값 g 이상일 경우 verification을 건너뛰고 drafting을 반복하며, 학습 시에는 chain 형태로 구성된 unverified draft tokens의 hidden state를 활용하는 Loop-aware training을 통해 draft model의 신뢰성을 보장합니다. 실험 결과, DLoop는 EAGLE-3, DFlash, Domino, DSpark 등 다양한 draft model에서 기존 대비 5%에서 41%의 wall-clock speedup 향상을 보였습니다. [Table 1]에서 증명된 바와 같이, 모든 task 카테고리(Math, Code, Chat)에서 일관된 성능 우위를 나타내었으며, DSpark와 같은 병렬 draft model에서 특히 높은 수치의 성능 개선이 확인되었습니다. 또한, DDTree나 DARTree와 같은 트리 기반 검증 기법과 결합했을 때에도 추가적인 성능 향상을 보이며, [Table 5]와 같이 복합적인 환경에서도 robust한 효율성을 입증하였습니다.
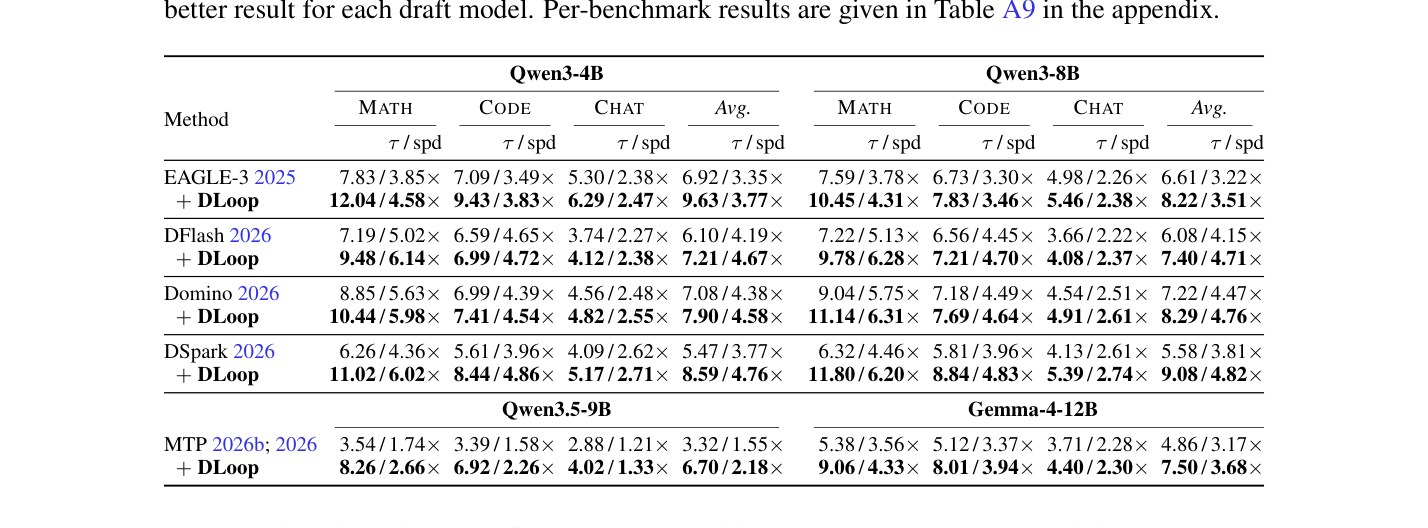
Table 1 — 다양한 모델별 DLoop 적용 전후의 성능 지표 비교
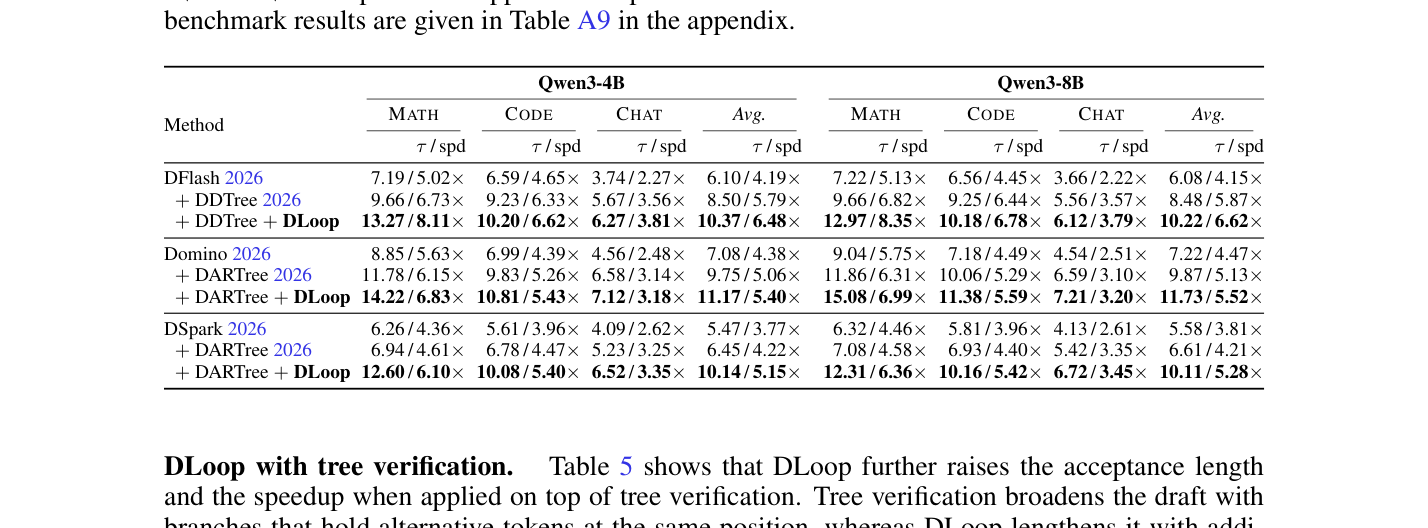
Table 5 — 트리 기반 검증 기법과 결합했을 때의 성능 향상 결과
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 Speculative decoding에서 검증 단계의 빈도를 동적으로 최적화하는 DLoop 기법을 통해 추론 속도를 극대화하는 성과를 거두었습니다. 이 연구는 기존의 경직된 speculation 절차를 탈피하여 draft model의 확신도에 따라 drafting 루프를 확장하는 유연한 접근법을 제시하였으며, 특히 모델 아키텍처를 변경하지 않고도 학습 기법을 통해 성능을 극대화했다는 점에서 높은 실용성을 지닙니다. 본 연구는 대규모 언어 모델 서빙 인프라에서 latency를 줄이고 throughput을 확보하고자 하는 산업계 및 학계 연구에 중요한 가이드라인을 제공할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Contextual Correction of Parallel Draftsfor Speculative Decoding
- [논문리뷰] Verification-Aware Training for Speculative Decoding
- [논문리뷰] Revisiting Lossy Verification in Speculative Decoding: Mechanisms, Trade-offs, and Failure Modes
- [논문리뷰] Domino: Decoupling Causal Modeling from Autoregressive Drafting in Speculative Decoding
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
Review 의 다른글
- 이전글 [논문리뷰] Composing What Each Teacher Learned: Multi-Teacher On-Policy Distillation through Teacher-Relative Shifts
- 현재글 : [논문리뷰] DLoop: Looped Speculative Decoding
- 다음글 [논문리뷰] DecepEval: A Benchmark for Evaluating Deception in LLM Agents
댓글