[논문리뷰] GRACE: Generation-aware latent compression for efficient video generation
링크: 논문 PDF로 바로 열기
메타데이터
저자: Jiyoung Kim, Paul Hyunbin Cho, Jisu Nam, Donghoon Lee, Hyunsung Go, Yeonkyeong Lee, Hansaem Kim, Seungryong Kim
1. Key Terms & Definitions (핵심 용어 및 정의)
- GRACE (Generation-Aware Latent Compression): pretrained video autoencoder를 압축하여 DiT(Diffusion Transformer)와의 호환성을 유지하며 효율적인 비디오 생성을 가능하게 하는 2단계 프레임워크입니다.
- Dual-latent Representation: pretrained autoencoder가 생성한 Base Latent와 압축 과정에서 손실된 정보를 복구하는 Residual Latent로 구성된 이중 표현 방식입니다.
- Generation-aware Alignment: compressed latent가 pretrained DiT의 latent 공간과 일치하도록 중간 feature space에서 정렬하는 최적화 기법입니다.
- Asymmetric Denoising: generation 과정에서 Base Latent를 Residual Latent보다 앞선 timestep에서 노이즈 제거(denoising)하여 생성 안정성을 높이는 기법입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 비디오 생성 모델의 고비용 문제를 해결하기 위해, pretrained 비디오 오토인코더의 효율적 압축과 DiT의 호환성 유지라는 두 가지 핵심 문제를 다룹니다 [Figure 1]. 기존의 압축 방식은 고압축률로 인해 reconstruction 품질이 저하되거나, latent 채널을 무리하게 늘려 DiT의 수렴 속도를 늦추고 generation 성능을 저해하는 한계가 있습니다. 특히, 오토인코더를 수정하면 latent 분포가 변화하여 pretrained DiT와의 호환성이 깨지며, 이를 극복하기 위한 재학습은 막대한 컴퓨팅 비용을 요구합니다. 저자들은 기존의 오토인코더와 DiT가 이미 최적화된 생성 파이프라인을 형성하고 있다는 점에 착안하여, 압축 후에도 이 파이프라인을 유지하면서 생성 품질을 보존하는 새로운 접근 방식을 제안합니다 [Figure 2].
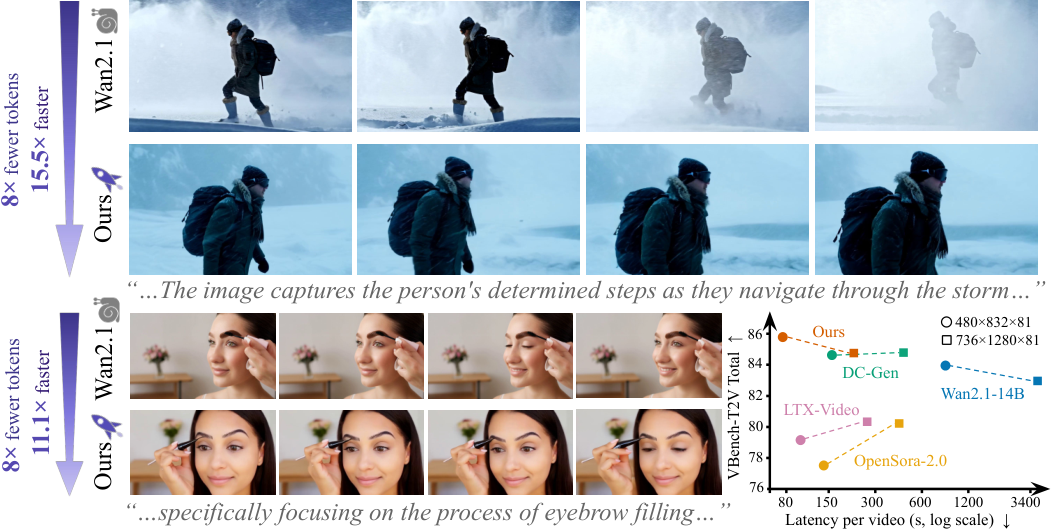
Figure 1 — GRACE 성능 개요
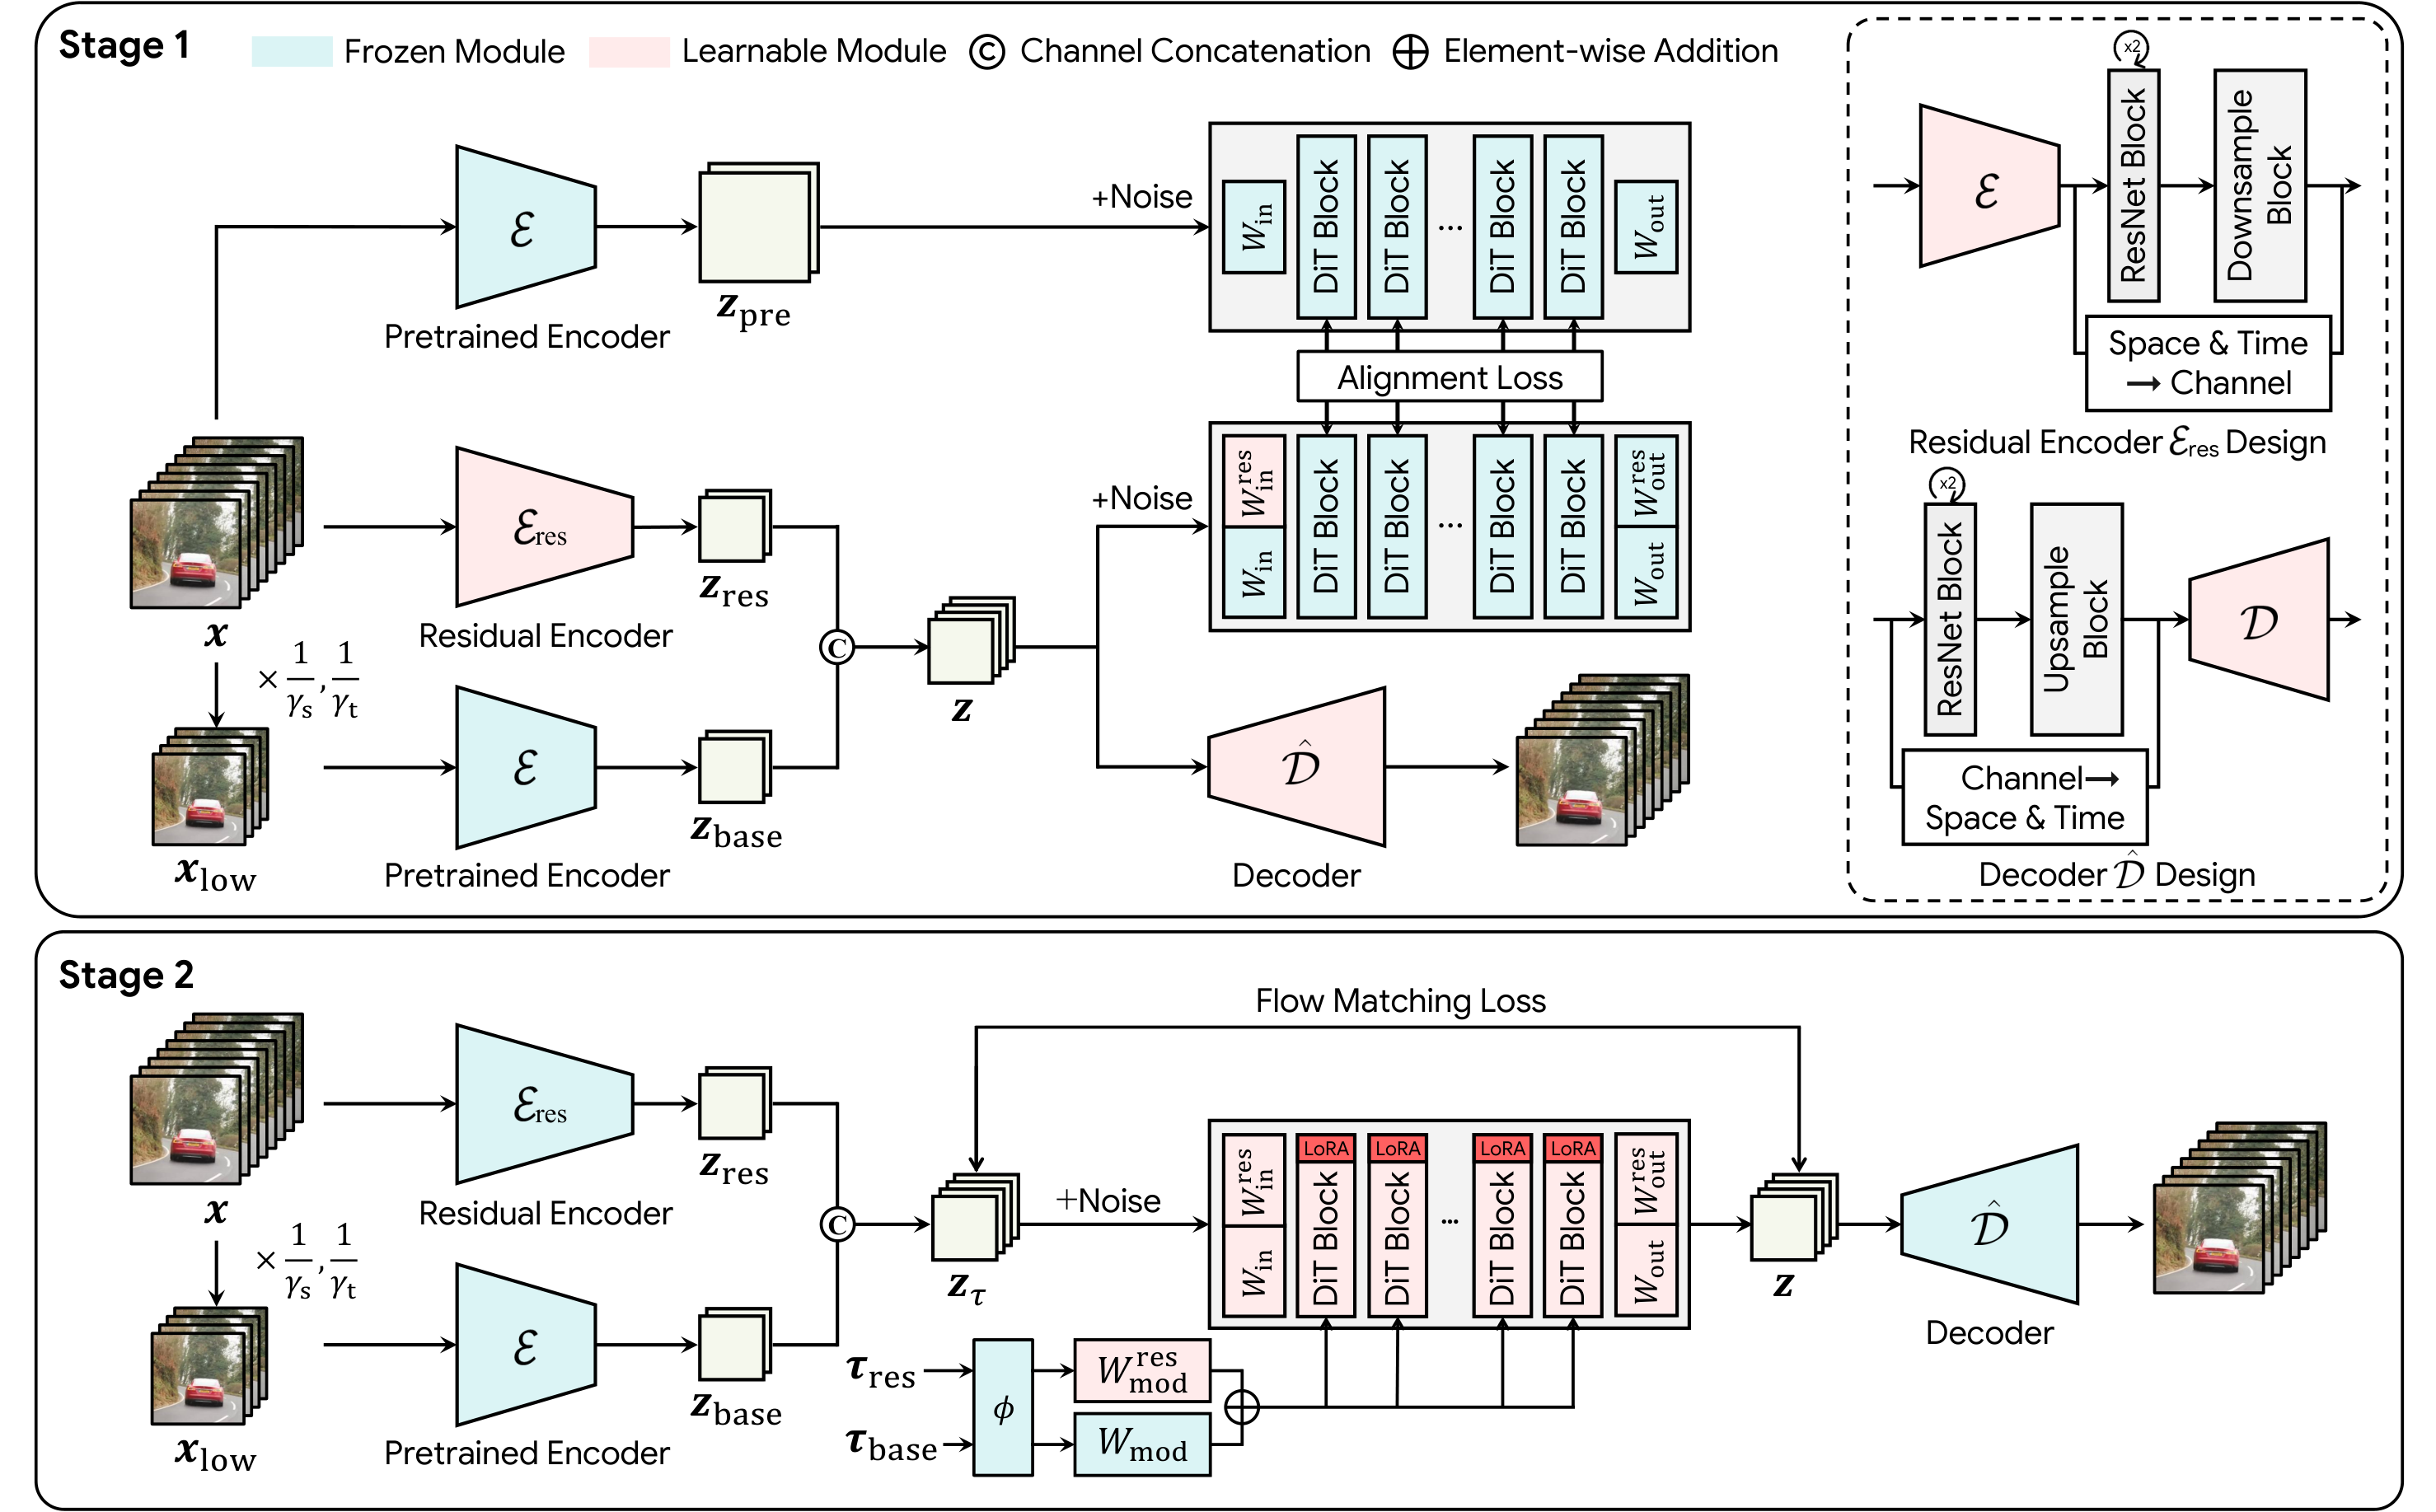
Figure 2 — GRACE 전체 아키텍처
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 GRACE 프레임워크를 통해 pretrained 파이프라인의 핵심 지식을 온전히 보존하면서 토큰 수를 획기적으로 줄이는 데 성공했습니다. 첫 번째 단계인 Stage 1에서는 Dual-latent Representation을 도입하여 Frozen된 Base Latent와 학습 가능한 Residual Latent를 분리하고, Generation-aware Alignment loss를 통해 compressed latent를 Frozen DiT의 feature space에 정렬합니다 [Figure 3]. 이어진 Stage 2에서는 DiT를 경량화된 LoRA 방식으로 미세 조정하며, Asymmetric Denoising을 적용하여 Base Latent가 Residual Latent를 안정적으로 보완하도록 설계했습니다 [Figure 4].
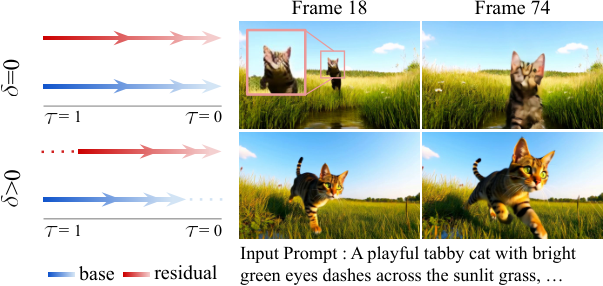
Figure 4 — 비대칭 노이즈 제거 순서
실험 결과, 제안 방법론은 Wan2.1-I2V-14B 모델 대비 토큰 수를 약 8배($8\times$) 감소시켰으며, 480x832 해상도에서 약 11.1배, 736p 해상도에서 약 15.5배의 Latency 단축을 달성했습니다 [Table 2]. 특히, VBench 벤치마크 평가에서 압축 전 모델과 대등한 generation 품질을 유지하며, 기존 고압축 오토인코더 방식 대비 우수한 성능을 입증했습니다 [Table 2], [Figure 5].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 비디오 생성 파이프라인의 효율성을 극대화하는 GRACE 프레임워크를 성공적으로 제안했습니다. 이 연구는 단순한 reconstruction 충실도가 아닌, DiT 기반의 생성 맥락을 반영한 압축이 고품질 생성의 핵심임을 증명했다는 점에서 학술적 가치가 큽니다. 향후 대규모 생성 모델의 온디바이스 배포 및 추론 효율성 개선에 중요한 지표가 될 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LayerRecall: A State-Conditioned Memory Router for Long-Horizon Consistency in Video Generation
- [논문리뷰] CoinVE-200K: A Large-Scale High-Quality Dataset for Compositional Instruction-Guided Video Editing
- [논문리뷰] SANA-Video 2.0: Hybrid Linear Attention with Attention Residuals for Efficient Video Generation
- [논문리뷰] ShotPlan: Cinematic Video Generation with Learnable Planning Token
- [논문리뷰] Motion4Motion: Motion Transfer Across Subjects at Inference
Review 의 다른글
- 이전글 [논문리뷰] From Pareto to Preference: Personalized Test-Time Scaling via Amortized Agentic Policy Discovery
- 현재글 : [논문리뷰] GRACE: Generation-aware latent compression for efficient video generation
- 다음글 [논문리뷰] Gains and Collapse in On-Policy Distillation:A Reinforcement Learning Perspective
댓글