[논문리뷰] On KL-Regularized Policy Optimization
링크: 논문 PDF로 바로 열기
저자: Yifan Zhang
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- KLPO (KL-Regularized Policy Optimization): 샘플러(Sampler)를 KL regularizer의 앵커(Anchor)로 설정하여, 중요도 샘플링 가중치(Importance weights) 없이도 효율적으로 오프라인 RL 업데이트를 수행하는 프레임워크입니다.
- SKLPO (Sequence KL-Regularized Policy Optimization): KLPO의 응답 수준(Response-level) 인스턴스로, 완전한 응답에 대해 단일 로그-파티션 값을 학습하여 최적화하는 기법입니다.
- PMD (Policy Mirror Descent): 정책 최적화를 위해 KL 제약 조건을 활용하는 반복적인 최적화 기법으로, KLPO는 토큰 수준에서 이를 근사화합니다.
- Critic-free: 상태-가치 함수(Critic) 모델을 별도로 학습하거나 유지할 필요 없이, 종단 보상(Terminal reward)을 활용하여 정책 업데이트를 직접 계산하는 방식을 의미합니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 연구는 대규모 언어 모델(LLM) 에이전트 학습에서 발생하는 비동기적(Asynchronous) 환경의 오프라인 정책 학습 문제를 해결하고자 합니다. 기존 방식인 PPO와 같은 클리핑(Clipping) 기반 중요도 가중치 방법은 훈련이 진행됨에 따라 업데이트 편향을 유발하며, GRPO와 같은 그룹 기반 추정기는 긴 에피소드에서 높은 계산 비용을 초래하는 한계가 있습니다. 이러한 비동기적 환경에서는 데이터 수집 시점과 학습 시점 사이의 정책 불일치(Trainer-Sampler gap)가 상시 존재하므로, 이를 안정적으로 처리할 수 있는 새로운 최적화 프레임워크가 필요합니다.
## 3. Method & Key Results (제안 방법론 및 핵심 결과) KLPO는 샘플러에서 앵커링된 KL 정규화를 통해 Gibbs 해를 도출하고, 로그-비율(Log-ratio) 최적화 조건을 least squares 회귀 문제로 변환함으로써 중요도 샘플링 가중치 없이 업데이트를 수행합니다. 제안된 방법은 [Figure 1]에 나타난 바와 같이, 1) 로컬 정책 개선 문제 정의, 2) Gibbs 최적 해 도출, 3) 정규화 도구(Normalizer)의 profiling을 통한 간소화 과정을 거칩니다. 특히, 종단 보상만을 활용한 critic-free 토큰 수준 그래디언트 계산법을 통해 계산 효율성을 극대화합니다. 본 연구는 SPPO, GPO, REBEL, BPO와 같은 기존의 다양한 최적화 기법들이 KLPO의 특수 사례(Special cases)임을 수학적으로 증명하였으며, [Table 1]에서 이들 간의 관계를 체계적으로 분류하였습니다. 실험적으로는 단일 롤아웃(One rollout per prompt)만으로도 기존 기법과 대등하거나 더 안정적인 정책 학습이 가능함을 확인했습니다.
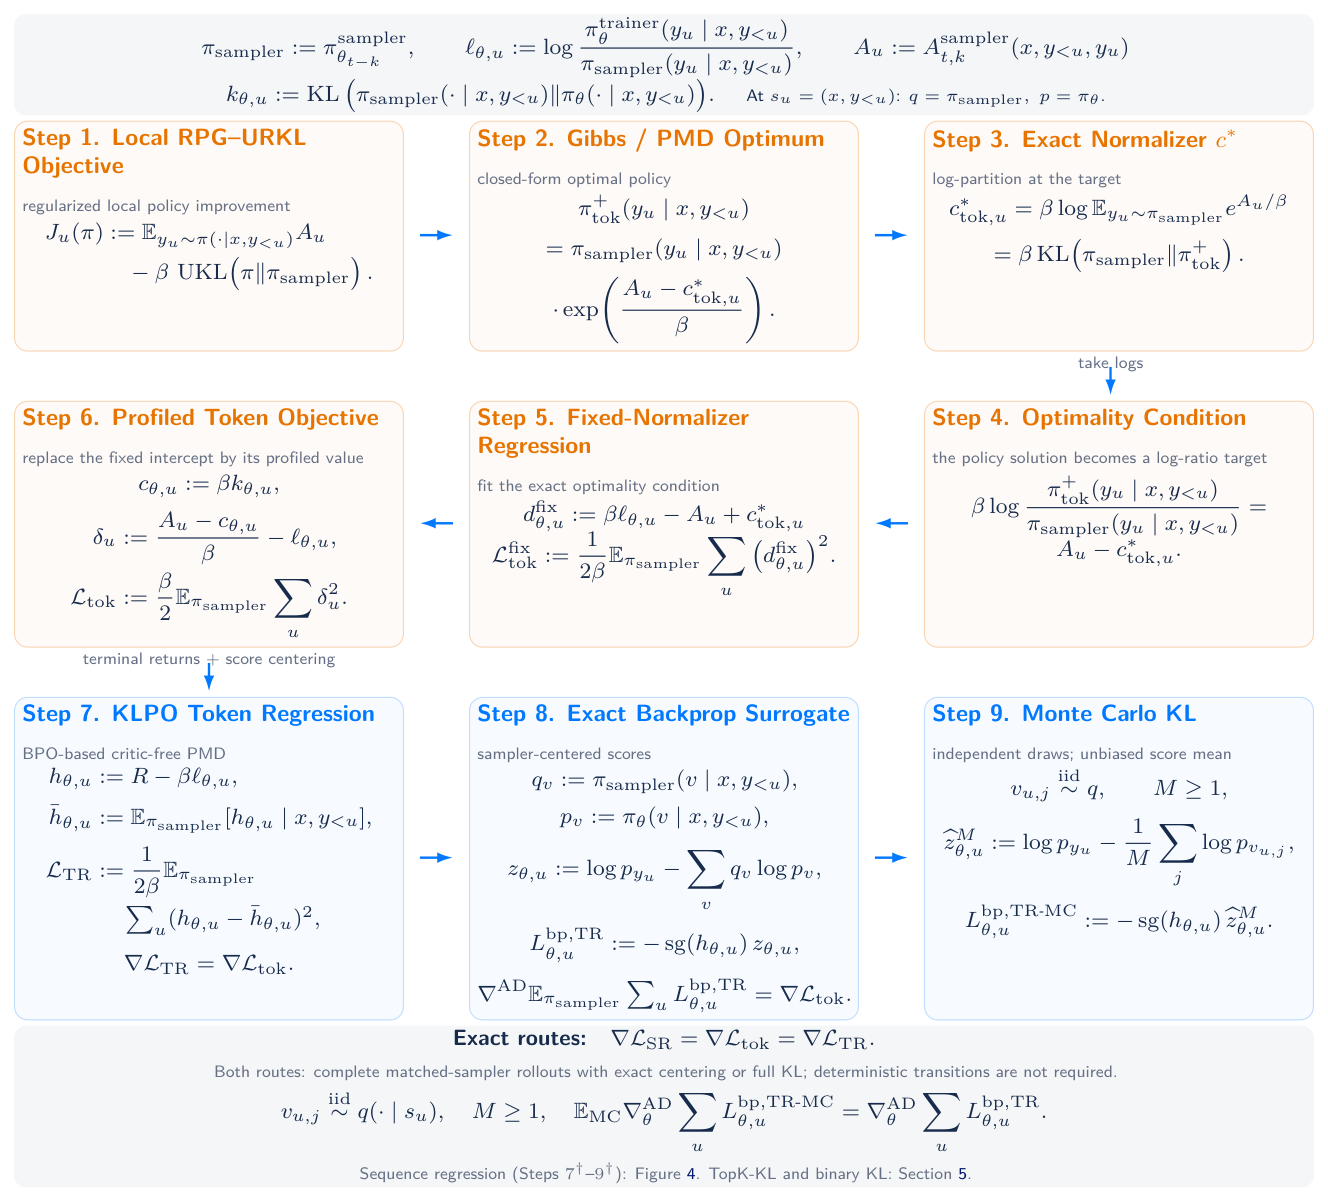
Figure 1 — KLPO 프레임워크의 전체 파이프라인과 단계별 최적화 과정을 보여주는 핵심 다이어그램입니다.
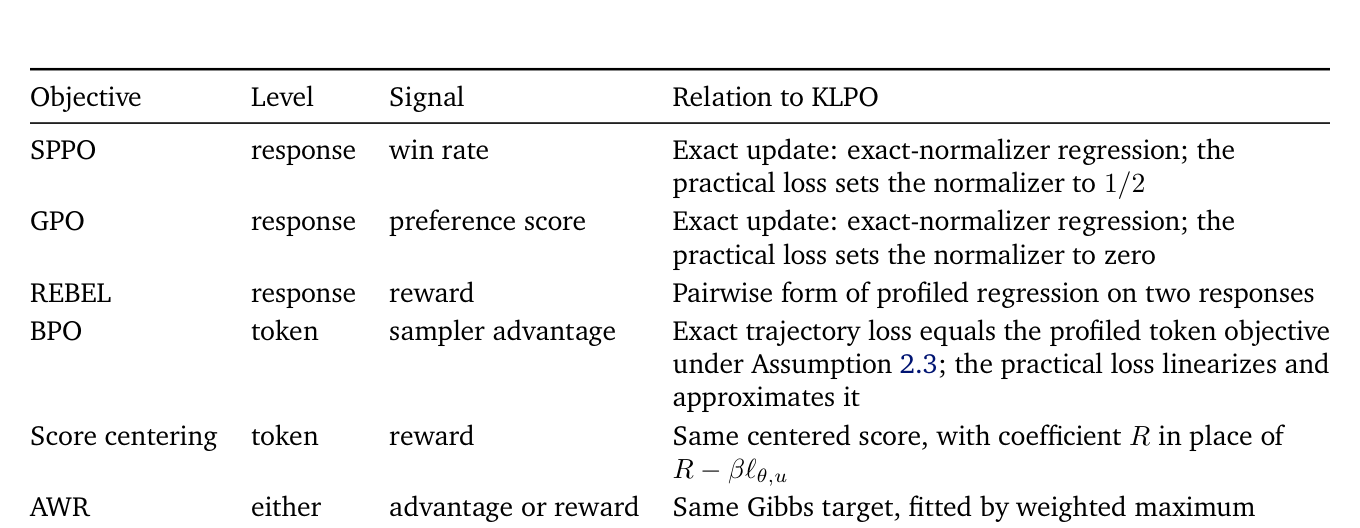
Table 1 — 기존의 다양한 연구(SPPO, GPO, BPO 등)들이 KLPO의 특별한 사례임을 보여주는 체계적인 비교 분석 표입니다.
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 sampler-anchored KL 정규화라는 새로운 프레임워크를 통해 비동기적 에이전트 RL에서의 중요도 가중치와 크리틱 의존성 문제를 동시에 해결하였습니다. KLPO는 정규화 함수(Normalizer)를 샘플러 평균과 KL divergence로 대체하여 모델의 안정성을 크게 향상시켰습니다. 이러한 접근 방식은 비동기적 대규모 학습 환경에서 에이전트의 효율성을 제고하며, 향후 다양한 LLM Reasoning 연구 및 대규모 에이전트 학습 아키텍처 설계에 있어 중요한 이론적 토대를 제공할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] ReSPO: Reshaped Sequence Policy Optimization for Gradient Starvation in Off-Policy Learning
- [논문리뷰] Rethinking Training-Inference Mismatch in LLM Reinforcement Learning: Where It Arises and How to Correct It
- [논문리뷰] Group Adaptive Clipping Policy Optimization
- [논문리뷰] Stale but Stable: Staleness-Adaptive Trust Regions for Stabilizing Asynchronous Reinforcement Learning
- [논문리뷰] UP: Unbounded Positive Asymmetric Optimization for Breaking the Exploration-Stability Dilemma
Review 의 다른글
- 이전글 [논문리뷰] NAMVIS: Next-Scale Autoregressive Multi-View Image Synthesis
- 현재글 : [논문리뷰] On KL-Regularized Policy Optimization
- 다음글 [논문리뷰] On-Policy Distillation with Negative-Policy Rollouts
댓글