[논문리뷰] On-Policy Distillation with Negative-Policy Rollouts
링크: 논문 PDF로 바로 열기
저자: Jaehui Hwang, Dongyoon Han, Sangdoo Yun, Byeongho Heo
1. Key Terms & Definitions (핵심 용어 및 정의)
- On-Policy Distillation (OPD): 학생 모델이 스스로 생성한 trajectory를 사용하고, 더 강력한 교사 모델로부터 토큰 단위의 감독(supervision)을 받아 학습하는 포스트 트레이닝 기법입니다.
- Negative-Policy Rollouts: 학생 모델보다 성능이 낮고 역량이 부족한 모델을 'Negative policy'로 설정하여, 학생이 지양해야 할 부정적인 참조 데이터를 생성하는 과정입니다.
- NP-OPD (Negative-Policy OPD): 교사 모델의 긍정적인 지도와 더불어 negative policy의 rollouts를 훈련 과정에 통합하여, 학생 모델이 부정적인 토큰을 억제하도록 유도하는 방법론입니다.
- NSP (Negative-policy Suppression Precision): 훈련된 학생 모델이 가장 큰 확률 감소를 보인 토큰들 중, 실제로 negative policy가 교사 모델보다 선호했던 토큰의 비율을 측정하는 지표입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 OPD가 오직 교사 모델의 긍정적인 안내에만 의존하여, 교사와 학생 간의 분포 중첩(distributional overlap)이 제한적일 경우 학습 신호가 부족하다는 문제를 해결하고자 합니다. 기존 방식은 교사 모델만을 유일한 참조점으로 삼기 때문에 학생 모델이 무엇을 지양해야 하는지에 대한 명시적인 지표를 제공하지 못합니다. 저자들은 DPO와 같은 선호도 최적화 방법론에서 영감을 받아, OPD 프레임워크 내에서 부정적인 신호를 제공하는 보완적 기법이 필요함을 제기합니다 [Figure 1].
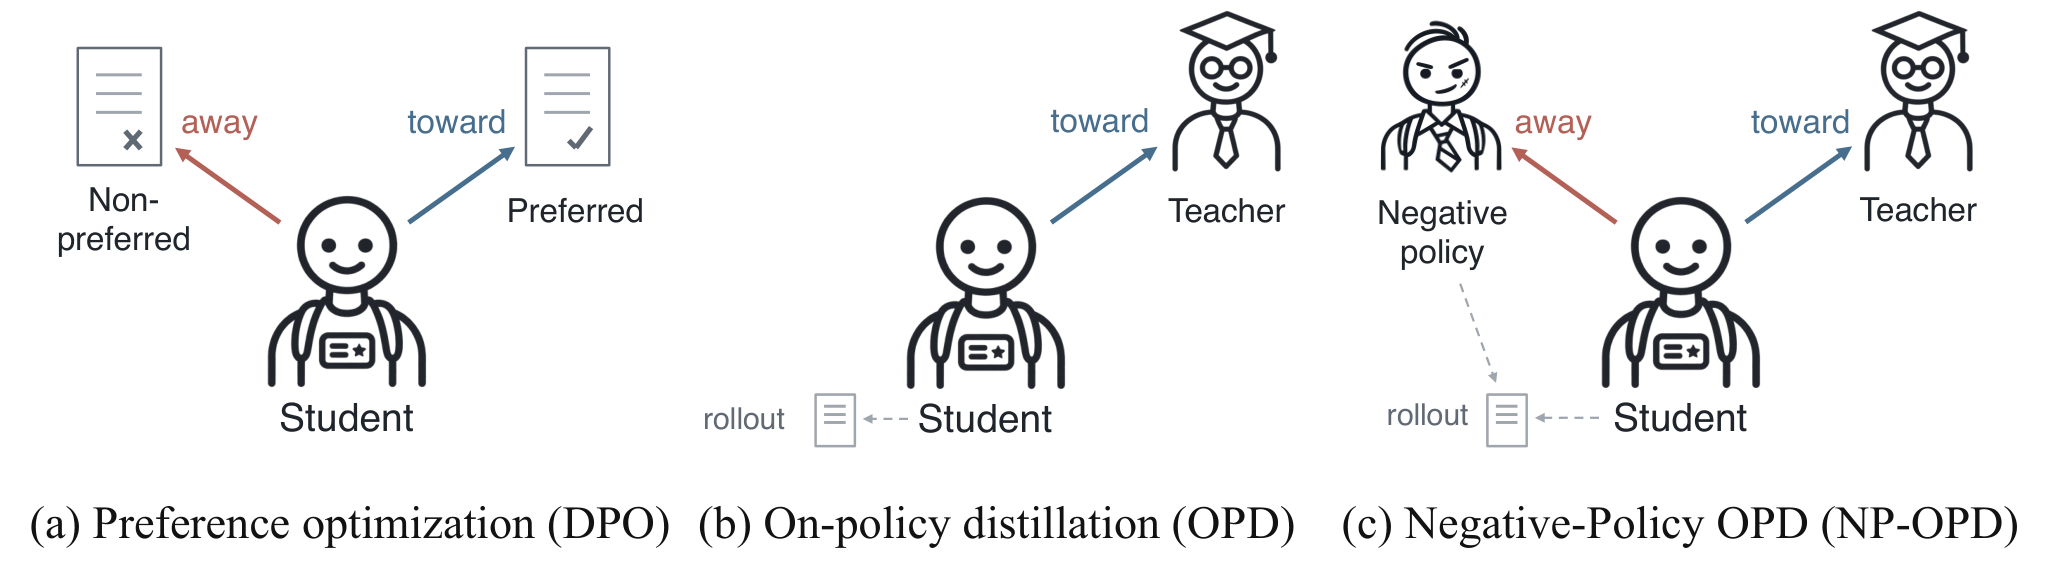
Figure 1 — OPD와 NP-OPD의 개념적 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문이 제안하는 NP-OPD는 훈련 과정의 rollout 단계에서 학생 모델의 생성물뿐만 아니라, 성능이 낮은 negative policy에서 샘플링된 토큰들을 혼합하여 교사 모델의 감독을 받도록 설계되었습니다. 이 방식은 기존 OPD의 보상 함수(reward formulation)를 수정할 필요 없이, 단순히 rollout 분포를 변경함으로써 학생 모델이 negative policy가 선호하는 토큰을 통계적으로 억제하도록 유도합니다 [Figure 1]. 실험 결과, NP-OPD는 수학, 코드, 과학 등 13개 벤치마크 전반에서 성능 향상을 입증했습니다. 특히 Qwen3-1.7B 모델을 기준으로 OPD 대비 Math 평균 성능을 48.3에서 56.3으로 크게 개선하였으며, ExOPD 및 **OPD^2^**와 같은 최신 OPD 변형 기법들과 결합했을 때도 일관된 성능 우위를 보였습니다 [Table 1, Table 2]. 또한, NP-OPD는 훈련 중 negative policy의 rollouts를 사전 생성하여 재사용함으로써 실제 훈련 시간을 약 60% 단축하는 효율성을 제공합니다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 negative policy의 rollouts를 도입함으로써 OPD의 학습 효율과 성능을 동시에 극대화할 수 있음을 입증했습니다. 이 연구는 교사 모델로부터의 긍정적인 지도를 유지하면서도 명시적인 부정적 참조를 통해 모델의 추론 능력을 고도화하는 새로운 학습 패러다임을 제시합니다. 제안된 NP-OPD는 다양한 모델 규모와 도메인에서 범용성을 검증받았으며, 향후 LLM의 효과적인 포스트 트레이닝 전략 수립에 중요한 기술적 토대를 제공할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Less is More: Early Stopping Rollout for On-Policy Distillation
- [논문리뷰] OPD Before RL: Warm-Starting Rubric-Based RL with On-Policy Distillation
- [논문리뷰] Beyond Imitation: Filtering On-Policy Distillation by Reasoning Progress
- [논문리뷰] SPOT: Sparse Probing and Outcome Calibration for On-Policy Distillation
- [논문리뷰] Any-OPD: Heterogeneous On-Policy Distillation for Flow-Matching Models via Representation-Space Bridging
Review 의 다른글
- 이전글 [논문리뷰] On KL-Regularized Policy Optimization
- 현재글 : [논문리뷰] On-Policy Distillation with Negative-Policy Rollouts
- 다음글 [논문리뷰] PhysEvo: Astra Can Act, Let It
댓글