[논문리뷰] Rethinking Relative Policy Differences Transfer of On-Policy Distillation
링크: 논문 PDF로 바로 열기
메타데이터
저자: Rong Wu, Daocheng Fu, Yu Yang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- OPD (On-Policy Distillation): 타겟 모델이 자신의 롤아웃(rollout)을 생성하고, 더 강력한 티처 모델로부터 토큰 단위의 감독 신호를 받아 학습하는 기법.
- Relative Policy Difference: 티처 모델과 레퍼런스 모델 간의 로그 확률 차이($\log \pi_{\text{exp}} - \log \pi_{\text{ref}}$)를 활용하여, 티처의 절대적 분포가 아닌 정책의 변화(update)만을 추출하여 전달하는 방식.
- Any-to-Any Transfer (A2-OPD): 독립적으로 선택된 프록시(proxy) 티처-레퍼런스 쌍과 타겟 모델을 연결하여, 모델 규모나 학습 단계가 달라도 정책 개선 사항을 전이할 수 있는 일반화된 프레임워크.
- Implicit Reward: 프록시 정책의 로그 확률 비율($\Delta_{\phi}$)을 KL-regularized 최적화 과정에서의 보상처럼 해석하여 타겟 정책을 학습시키는 방식.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 OPD가 티처 모델의 절대적인 성능 우위에 지나치게 의존하여, 티처와 학생 모델의 역량 격차가 작을 경우 성능 향상이 제한되거나 오히려 역효과가 발생한다는 문제를 해결하고자 한다. 기존 연구들은 Relative Policy Difference를 사용하여 이 제약을 완화하려 시도했으나, 어떤 종류의 정책 차이가 유용한 감독 신호를 제공하는지, 그리고 어떤 타겟 모델이 이를 효과적으로 수용할 수 있는지에 대한 체계적인 분석이 부족했다. 저자들은 이러한 불투명성을 해소하기 위해 Any-to-Any 전이 관점에서 정책 최적화 구조를 재정의하고, 전이 성공을 결정짓는 핵심 요인을 밝히고자 한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 Implicit Reward 관점에서 Relative Policy Difference를 공식화하여 A2-OPD 목표 함수를 유도하였다 [Figure 1]. 저자들은 프록시 전문가(proxy expert)가 제공하는 능력과 레퍼런스(reference)가 불필요한 행동을 걸러내는(filter) 상호보완적 역할을 수행함을 증명하였다 [Figure 3]. 주요 실험 결과는 다음과 같다. 첫째, RL이나 SFT와 같이 과업 지향적(task-directed) 훈련으로 유도된 정책 차이는 모델 규모에 따른 차이보다 훨씬 더 강력하고 일관된 성능 향상을 타겟 모델에 전이한다. 둘째, 정량적 지표 분석에서 RL 기반 프록시 쌍을 사용했을 때 타겟 성능 향상($G_T$)이 최대 32.23에 달하는 반면, 규모만을 다르게 한 프록시 쌍은 전이 효과가 거의 없거나 음수($-1.03$)를 기록했다. 셋째, 적절한 레퍼런스를 선택하면 실패할 뻔한 전이도 성공적으로 복구할 수 있음을 확인하였으며, 이는 원시적인 정책 거리(raw policy distance)보다 태스크 관련성(task relevance)이 전이 성공에 결정적임을 시사한다. [Table 2]
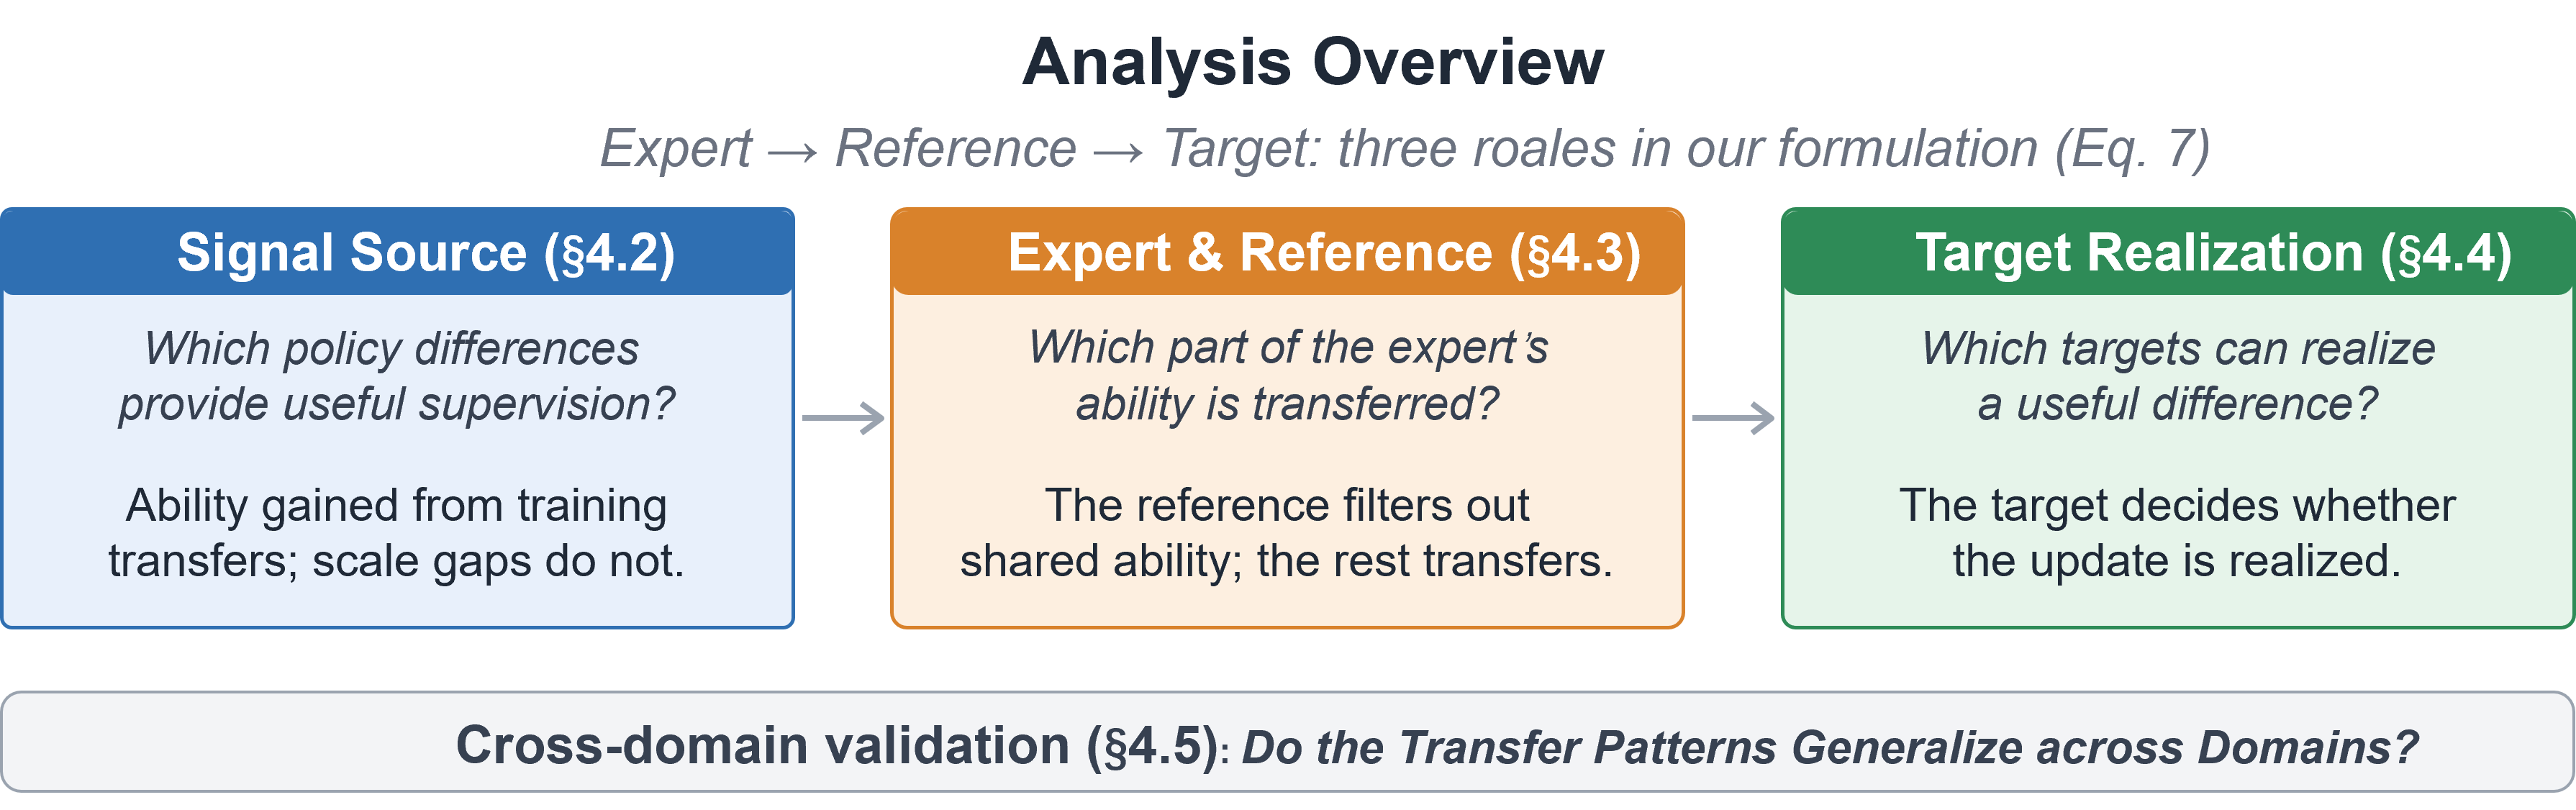
Figure 1 — 정책 차이 전이 체계
Figure 3 — 전문가와 레퍼런스의 역할
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Relative Policy Difference가 무조건적인 전이 수단이 아니라, 태스크 관련성, 레퍼런스 필터링, 타겟 호환성이 결합될 때만 효과적인 감독 신호가 됨을 규명하였다. 본 연구가 제시한 Any-to-Any 프레임워크는 비용이 많이 드는 사후 훈련(post-training) 결과물을 규모와 관계없이 효율적으로 재사용할 수 있는 길을 열어주었다. 이는 향후 대규모 언어 모델의 효율적인 튜닝 파이프라인 설계에 중요한 학술적 근거와 실무적 가이드라인을 제공할 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] When Do We Need On-Policy Distillation? Distilling on Offline Student Rollouts Is Often Better
- [논문리뷰] Gains and Collapse in On-Policy Distillation:A Reinforcement Learning Perspective
- [논문리뷰] DiffGate: Difficulty-Gated Teacher Guidance for On-Policy Distillation
- [논문리뷰] Verify Before You Distill: Prompt-Level Teacher Gating for On-Policy Distillation
- [논문리뷰] Pass the Baton: Trajectory-Relayed On-Policy Distillation
Review 의 다른글
- 이전글 [논문리뷰] Reflex: Visually Grounded Reactive Humanoid Control
- 현재글 : [논문리뷰] Rethinking Relative Policy Differences Transfer of On-Policy Distillation
- 다음글 [논문리뷰] S-Space: Exploring Spatial Workspace in Multimodal Language Models
댓글