[논문리뷰] Reflex: Visually Grounded Reactive Humanoid Control
링크: 논문 PDF로 바로 열기
Part 1: 요약 본문
저자: Taoyang Jia, Weikai Huang, Linxin Song, Jared Darlington, Jieyu Zhao, Yue Wang, Jiafei Duan, Zhongzheng Ren, Ranjay Krishna
1. Key Terms & Definitions (핵심 용어 및 정의)
- Visually Grounded Reactive Catching: onboard RGB-D 센서만을 사용하여 투척된 물체를 실시간으로 예측하고 전신을 사용하여 안정적으로 포획하는 제어 기술입니다.
- Privileged Learning: 훈련 시에는 완전한 상태 정보(privileged state)를 활용하고, 배포 시에는 제한된 센서 데이터(egocentric vision)만으로 동일한 성능을 내도록 학생 모델을 학습시키는 기법입니다.
- Whole-Body Control (WBC): 물체 포획 시 팔의 움직임뿐만 아니라 다리 배치, 몸통 제어, 충격 흡수 및 균형 유지를 통합하여 수행하는 제어 방식입니다.
- Latent Representation: 물체의 역학(dynamics) 정보를 8차원의 잠재 벡터(latent vector)로 압축하여, 컨트롤러가 시각적 노이즈나 지연(latency)에 강건하게 반응하도록 돕는 표현형입니다.
- DAgger (Dataset Aggregation): 학습 데이터의 분포가 고정된 정적 데이터셋이 아니라, 현재 모델이 실제로 방문하는 상태 분포를 반영하도록 지속적으로 데이터를 수집하고 학습하는 방식입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 휴머노이드가 일상적인 환경에서 빠르게 움직이는 물체에 반응하여 포획하고 처리하는 Visually Grounded Reactive Whole-Body Control의 어려움을 해결하고자 합니다 [Figure 1]. 기존의 연구들은 고정된 베이스의 매니퓰레이터에 의존하거나, 실내 모션 캡처 시스템(Vicon 등) 및 표식이 부착된 물체를 사용하는 등 통제된 환경에 국한되어 있었습니다. 실제 휴머노이드는 카메라 움직임과 자가 폐색(self-occlusion)이 공존하는 egocentric 시점에서의 빠른 물체 역학 추론과 전신 균형 제어를 동시에 해결해야 합니다. 이러한 복합적인 요구사항으로 인해 기존 기법들은 실시간성과 일반화 성능에서 한계를 보입니다.
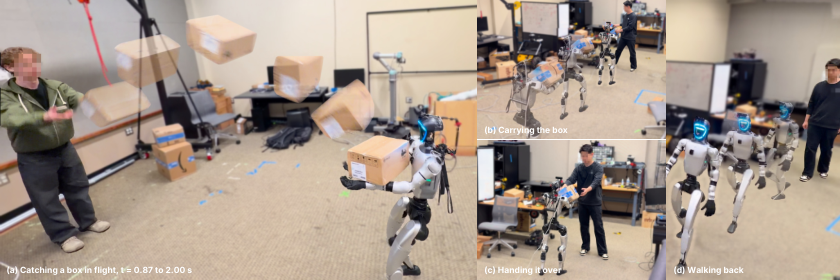
Figure 1 — 휴머노이드의 시각 기반 반응형 포획 및 하위 작업
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Reflex라는 3단계 프레임워크를 제안하여 시각적 인지와 전신 제어의 복잡성을 효과적으로 분리합니다 [Figure 2]. 첫 번째 단계에서는 상태 기반의 PPO(Proximal Policy Optimization)를 사용하여 전신 포획 기술을 학습합니다. 두 번째 단계에서는 지연된 관측 데이터로부터 물체의 역학을 추론하는 Privileged latent interface를 학습합니다. 마지막 세 번째 단계에서는 고정된 컨트롤러를 유지한 채, RGB-D 시각 정보로부터 이 잠재 벡터를 복원하는 시각적 인지 모듈을 학습합니다. 실험 결과, Reflex는 시뮬레이션 환경에서 egocentric RGB-D 입력만으로 85.7%의 포획 성공률을 달성했으며, 이는 privileged state 입력 사용 시의 87.9%와 근접한 수치입니다. 실제 Unitree G1 로봇을 이용한 테스트에서는 2.5m 거리에서 65%, 5m 거리에서 40%의 성공률을 기록했습니다 [Figure 3].
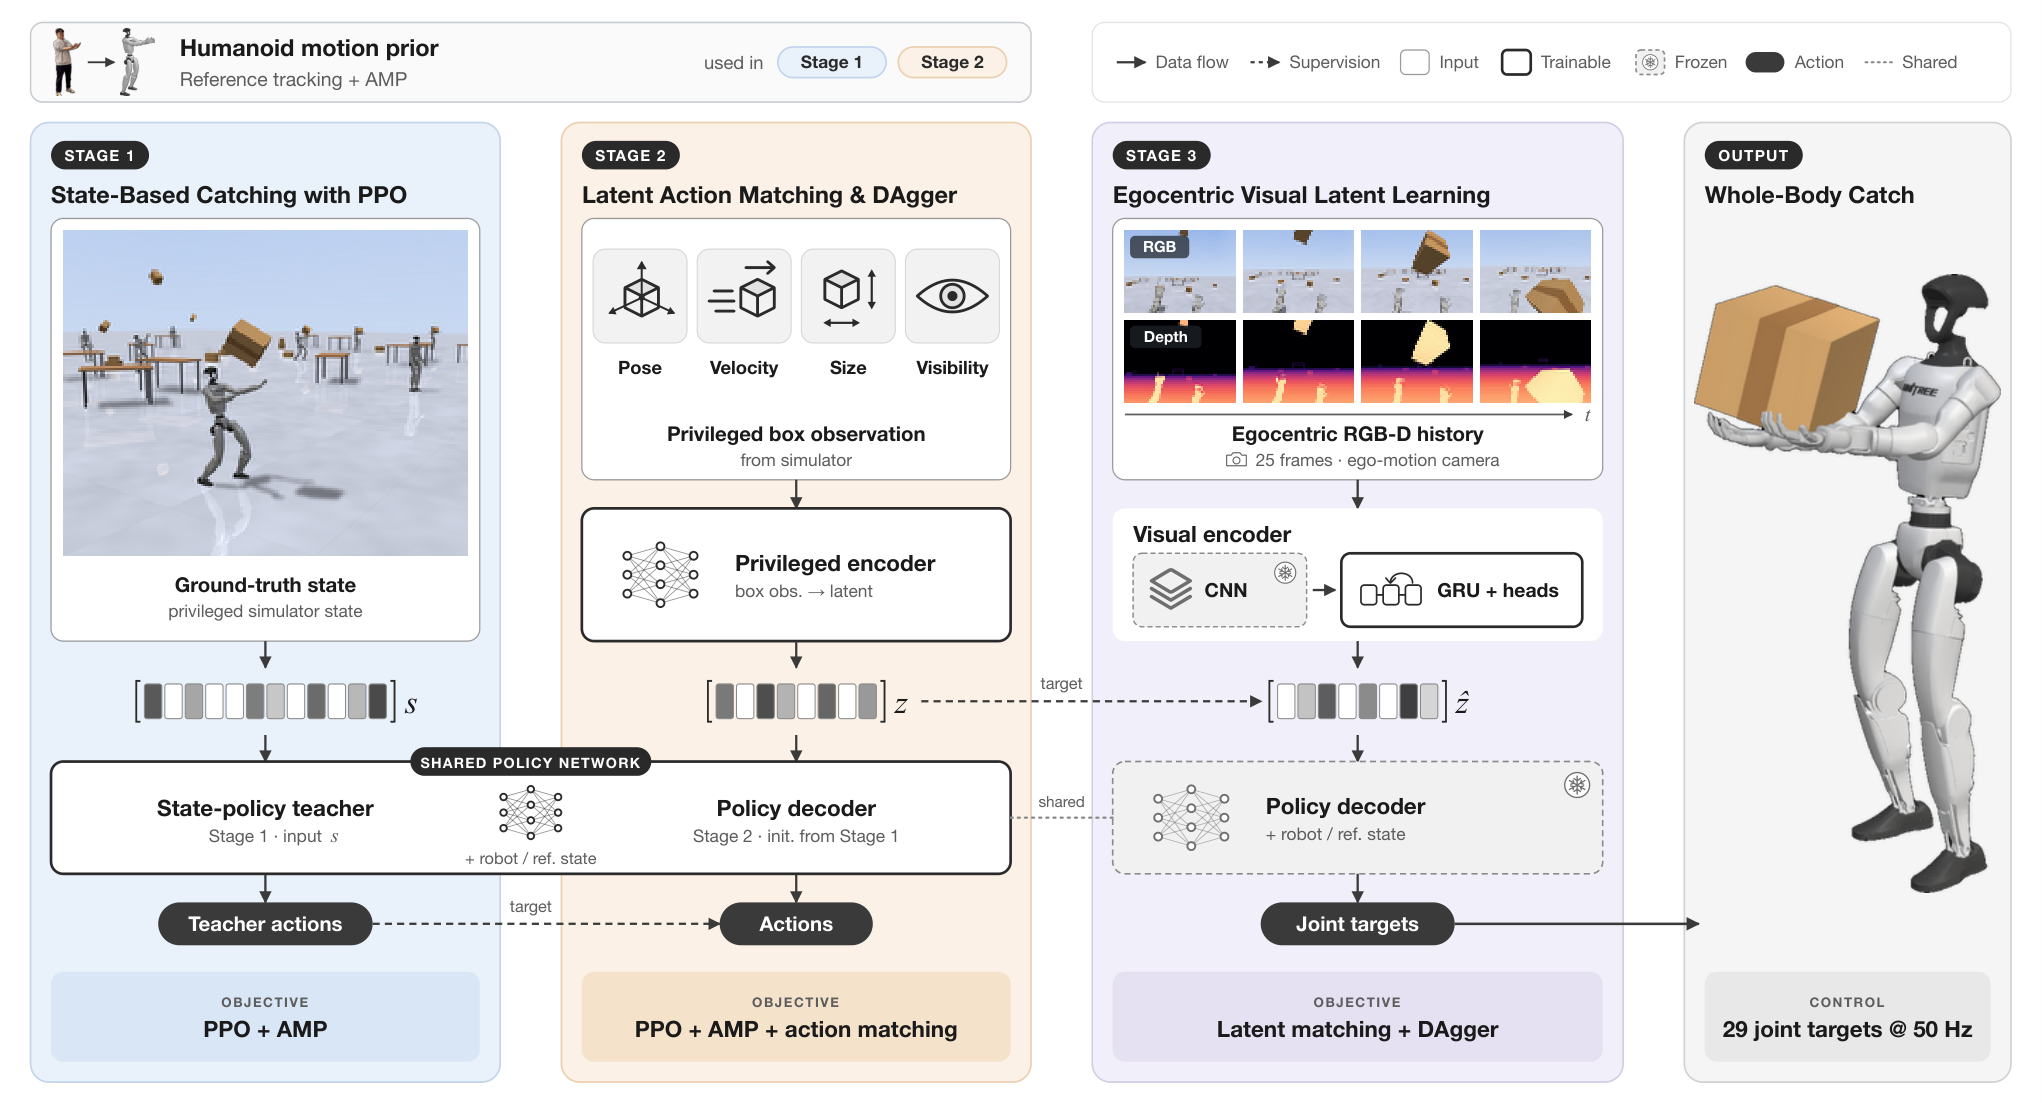
Figure 2 — Reflex의 3단계 학습 파이프라인 및 아키텍처
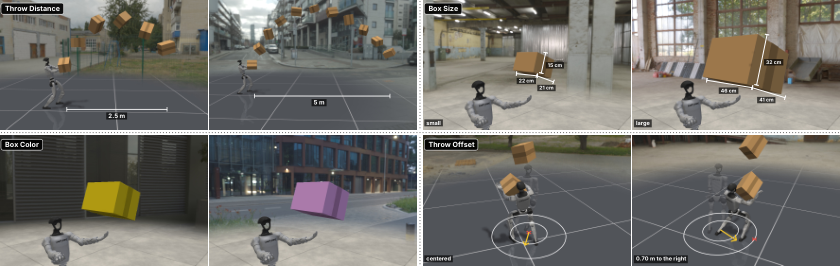
Figure 3 — 물체 투척 환경 및 외형 변형 데이터셋
4. Conclusion & Impact (결론 및 시사점)
본 연구는 휴머노이드가 특수 장비 없이 onboard 시각 정보만으로도 인간의 일상적인 역동적 반응을 모사할 수 있음을 입증했습니다. Reflex는 복잡한 전신 제어와 시각적 인지 문제를 성공적으로 분리함으로써 학습의 확장성을 크게 향상시켰습니다. 이러한 접근 방식은 물체 포획뿐만 아니라 물체 회피, 협동 작업 등 더 넓은 범위의 로봇 반응형 동작 설계에 중요한 토대가 될 것입니다. 향후 연구는 더욱 다양한 환경과 비정형 물체에 대한 대응 능력을 강화하는 방향으로 발전할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] RobotWorld: Benchmarking Multimodal Agents for Robot Use Across Diverse Tasks and Embodiments
- [논문리뷰] AdvSim2Real : Training Web Agents Against Adaptive Prompt Injection in a Web World Model
- [논문리뷰] Skill2Real: Agentic Skill Learning for Zero-Shot Sim-to-Real Robot Manipulation
- [논문리뷰] CrossBFM: Distilling a Shared Latent Behavior Space Across Humanoid Embodiments
- [논문리뷰] Code as Worlds: Agentic Discovery of Executable World Representations for Physical Reasoning
Review 의 다른글
- 이전글 [논문리뷰] Recurrent Harness for Agentic Continual Learning
- 현재글 : [논문리뷰] Reflex: Visually Grounded Reactive Humanoid Control
- 다음글 [논문리뷰] Rethinking Relative Policy Differences Transfer of On-Policy Distillation
댓글