[논문리뷰] PhysEvo: Astra Can Act, Let It
링크: 논문 PDF로 바로 열기
메타데이터
저자: Wenqing Tian, Zeyu Zhang, Zhaocheng Liu, Fengwei Liu, Qiang Liu, Liang Wang
1. Key Terms & Definitions (핵심 용어 및 정의)
- PhysEvo: 물리적 피드백을 통해 로봇 제어 시스템(Harness)을 반복적으로 개선하는 Physical Recursive Self-Improvement (RSI) 프레임워크입니다.
- Harness: 모델(Astra)과 로봇 사이의 인터페이스로, 도구(Tools), 스킬(Skills), 실행 로직을 포함하는 시스템을 지칭합니다.
- Task Agent & Meta-Agent: 단일 frozen model인 Astra가 수행하는 두 가지 역할로, Task Agent는 실시간 로봇 제어를, Meta-Agent는 실행 결과 분석을 통한 harness 수정 및 개선을 담당합니다.
- Physical Recursive Self-Improvement (RSI): 실행을 통한 물리적 결과와 오차를 분석하여 시스템을 수정하고, 이 수정된 시스템을 다시 다음 실행 및 개선 과정에 재사용하는 순환적 개선 프로세스입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 강력한 시각-언어-행동(VLA) 모델인 Astra가 로봇 제어 능력을 갖추고 있음에도 불구하고, 실제 환경에서는 왜 높은 신뢰성을 보여주지 못하는가라는 근본적인 의문을 해결하고자 합니다. 기존 연구들은 강력한 모델을 사용하더라도 로봇의 물리적 상태나 환경적 제약을 적절히 처리하지 못하는 한계(Bottle-neck)에 직면해 있습니다. 특히, 기존 인터페이스는 로봇의 포즈(Posture) 제어 권한이 부족하거나, 작업 도중 발생하는 가려짐(Occlusion)과 같은 문제를 실시간으로 해결하기 어렵습니다 [Figure 1]. 이러한 문제를 극복하기 위해서는 단순한 행동 모델의 교체가 아닌, 로봇을 구동하는 환경과 도구 체계(Harness)를 경험적으로 수정하고 재구성할 수 있는 구조가 필수적입니다.
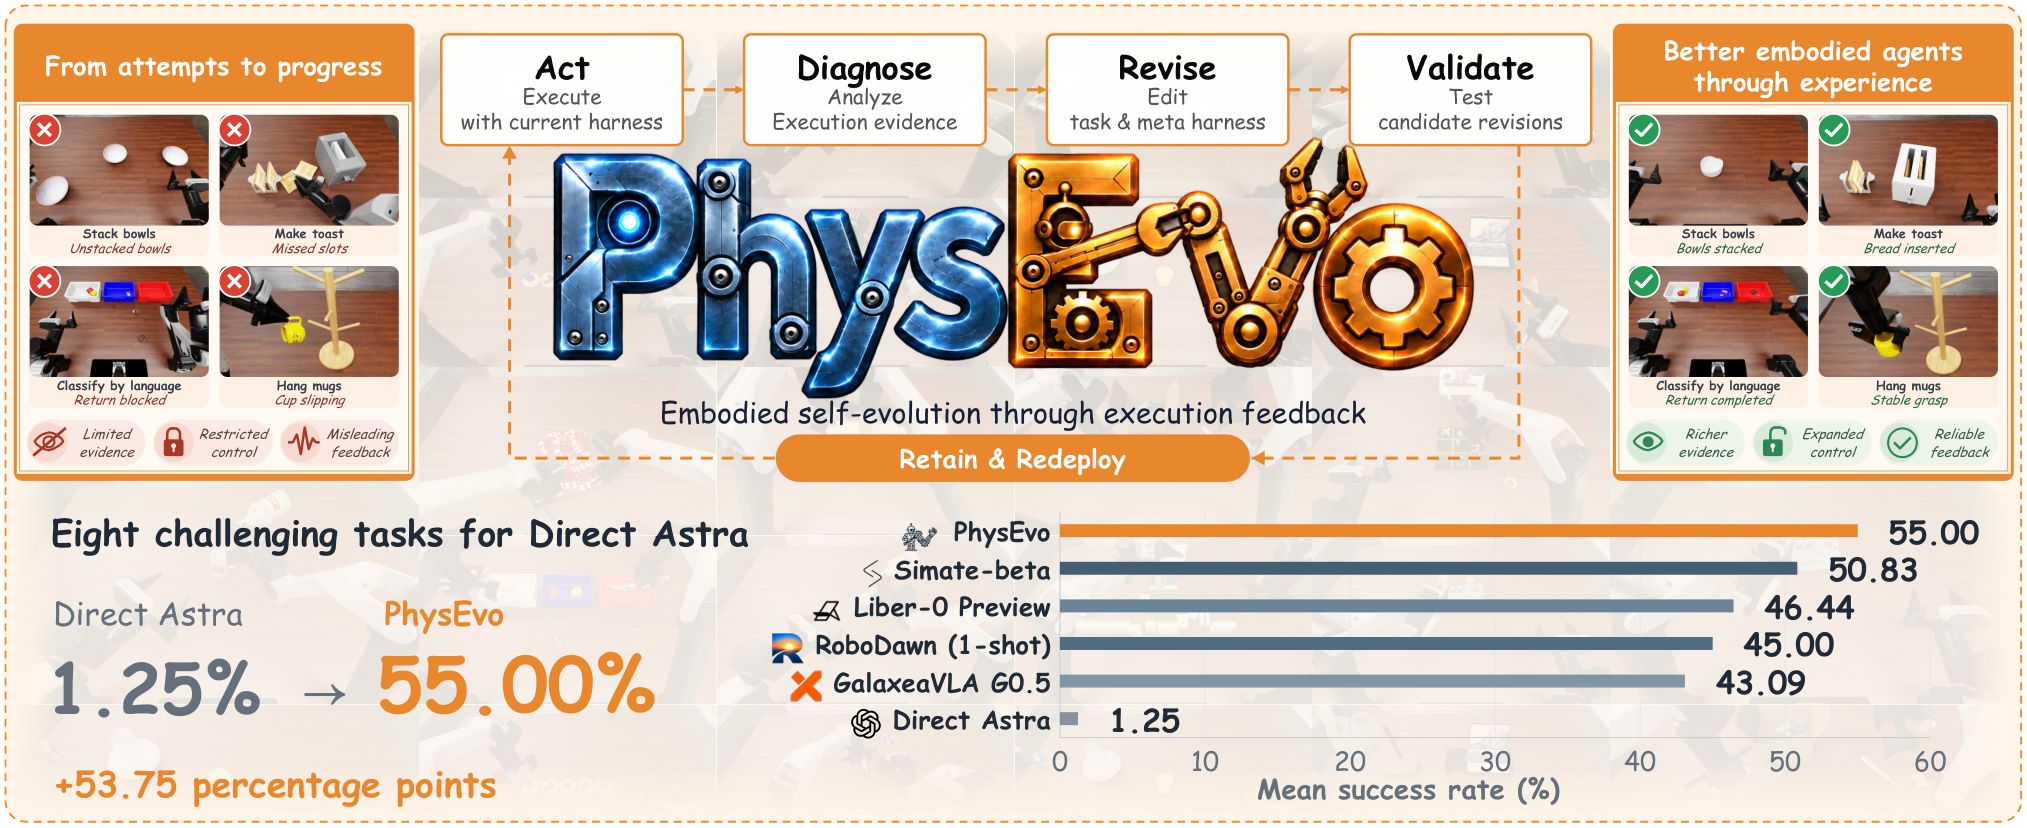
Figure 1 — PhysEvo의 물리적 RSI 과정
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Astra라는 하나의 frozen model을 활용하여, 작업 수행(Task Agent)과 시스템 개선(Meta-Agent)을 동시에 수행하는 PhysEvo 프레임워크를 제안합니다 [Figure 2]. Meta-Agent는 실행 로그를 추적하여 실패 원인을 진단하고, 도구 및 스킬을 수정한 후 테스트를 거쳐 유효한 변경사항을 시스템에 영구적으로 반영합니다. 제안된 방법론은 관절 단위 제어(Joint-level control), 능동적 관찰(Active observation), 그리고 재사용 가능한 스킬을 통합하여 복잡한 물리적 환경에 대응합니다 [Figure 3]. 실험 결과, RoboDojo 42개 작업에서 PhysEvo는 68.14/100의 점수와 62.00%의 성공률(SR)을 달성하여, 기존 최강 모델인 RoboDawn의 47.17% 대비 압도적인 성능 우위를 보였습니다. 특히, 기존 Astra가 해결하지 못했던 8개의 어려운 조작 작업에서는 55.00%의 성공률을 기록하여, 참조 대상인 1.25% 대비 53.75%p의 비약적인 향상을 입증했습니다 [Table 3]. 또한, 실제 하드웨어인 AgileX PiPER 환경에서도 90.60/100의 높은 평균 점수와 84.00%의 성공률을 기록하며 뛰어난 실세계 적응력을 증명했습니다.
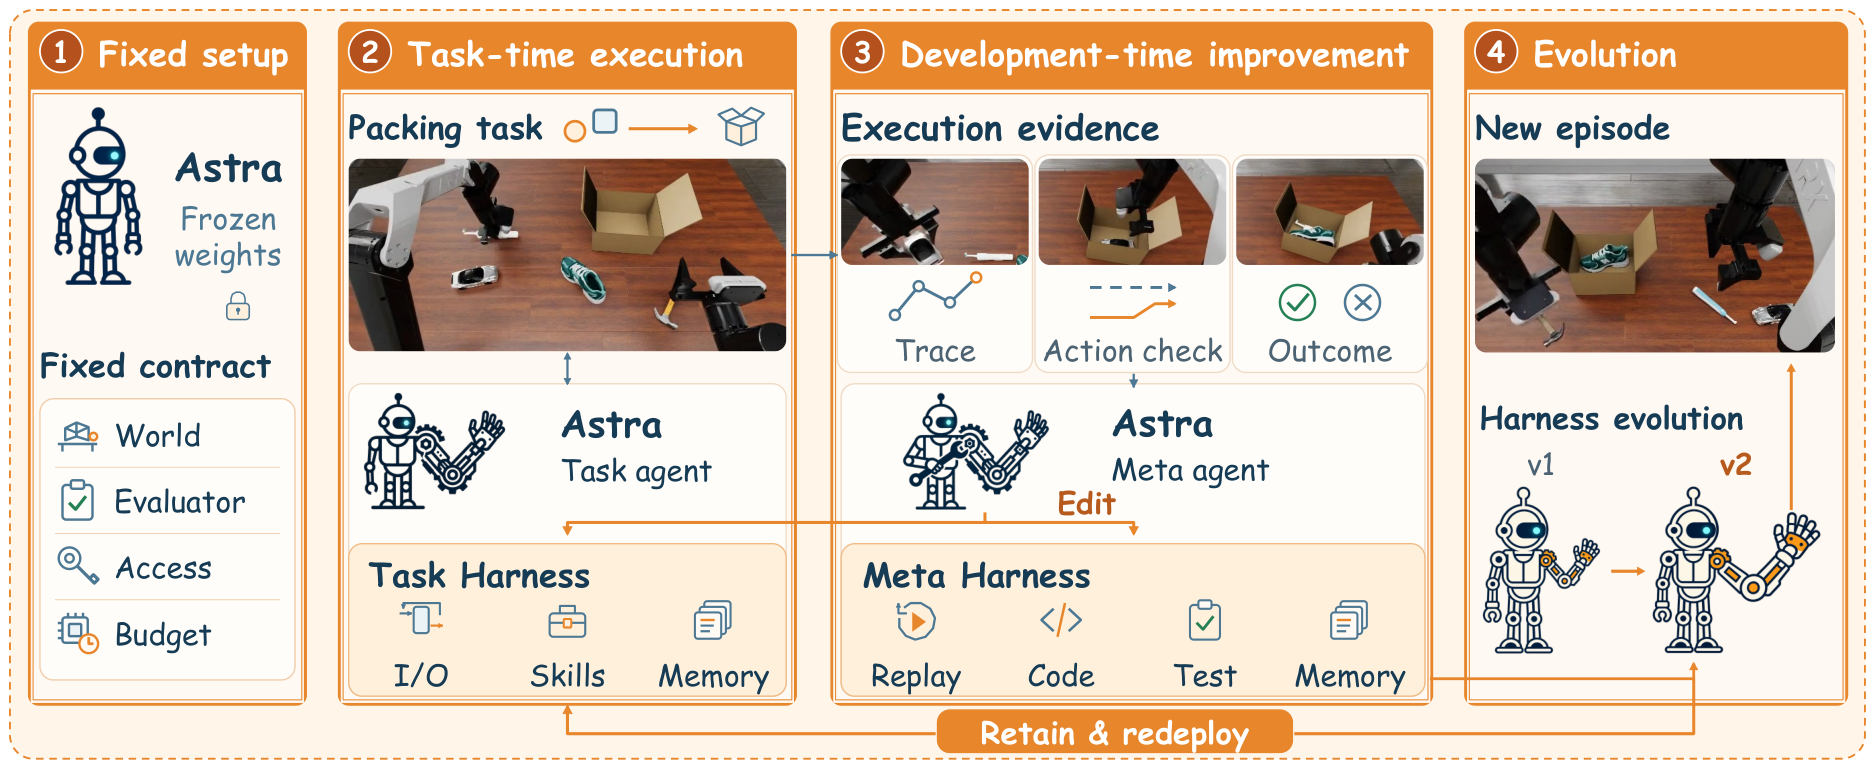
Figure 2 — PhysEvo 프레임워크 아키텍처
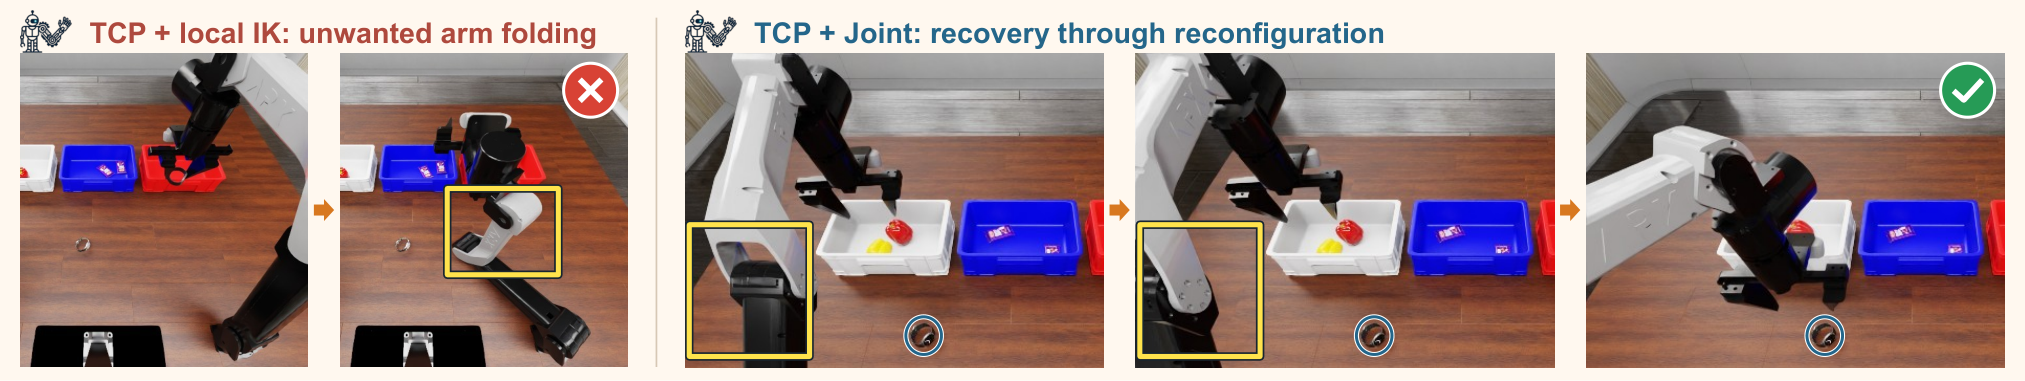
Figure 3 — 관절 제어를 통한 포즈 최적화
4. Conclusion & Impact (결론 및 시사점)
본 연구는 모델의 가중치를 업데이트하지 않고도 물리적 경험의 순환적 피드백을 통해 로봇 제어 시스템 전체를 고도화할 수 있음을 성공적으로 증명했습니다. PhysEvo는 단순한 행동 선택을 넘어, 로봇이 스스로 관찰 전략을 세우고 문제 해결 도구를 진단 및 구축하는 능동적인 RSI 프로세스를 제시했다는 점에서 의의가 있습니다. 이러한 연구는 향후 Embodied AI 분야에서 하드웨어와 소프트웨어 인터페이스의 유기적 결합을 통해 로봇의 자율성과 범용성을 극대화하는 표준적인 프레임워크로 활용될 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] EmbodiedSmith: Scaling Embodied Data through Recursive Self-Improvement Flywheel in Simulation
- [논문리뷰] Athanor: An Agent-Native System for Autonomous Post-Training Research
- [논문리뷰] Towards Agentic Robots: Model, Data, Environment, and Harness
- [논문리뷰] APT: Feedback-Driven Agentic Post-Training for Text-to-Image Generation
- [논문리뷰] Harness^2: Recursive Agent Harnessing for an Open World
Review 의 다른글
- 이전글 [논문리뷰] On-Policy Distillation with Negative-Policy Rollouts
- 현재글 : [논문리뷰] PhysEvo: Astra Can Act, Let It
- 다음글 [논문리뷰] Q-Learning with Scalar Adjoint Matching
댓글