[논문리뷰] Recursive Harness Distillation across Agents for Robot Manipulation
링크: 논문 PDF로 바로 열기
저자: Seungyeon Kim, Junhoo Lee, Minkyu Kim, Baekseung Kim, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Vision-Language-Action (VLA) models: 사전 학습된 시각 및 언어 표현을 로봇 액션 학습과 결합하여 광범위한 조작(manipulation) 능력을 제공하는 모델입니다.
- Recursive Harness Distillation (RHD): 강력한(strong) 에이전트의 경험을 경량(light) 에이전트를 위한 재사용 가능한 Harness로 증류하고, 경량 에이전트의 실행 피드백을 사용하여 Harness의 Playbook을 재귀적으로 개선하는 프레임워크입니다.
- Harness: VLA 실행을 관찰하고 개입하기 위한 인터페이스와 그 사용을 안내하는 Playbook을 결합한 외부 제어 구조입니다.
- Playbook: 강력한 에이전트의 경험에서 증류된 재사용 가능한 지침(guidance) 세트로, VLA에 언제, 어떻게 개입해야 하는지, 그리고 이후 무엇을 확인해야 하는지를 명시합니다.
- Strong Agent: task를 탐색하고 경험을 분석하며, 경량 에이전트를 위한 유용한 지침을 준비하는 고성능 모델 (예: GPT-6 Astra)을 지칭합니다.
- Light Agent: Harness를 사용하여 task를 실행하고 Playbook 개선을 위한 피드백을 제공하는 저비용의 경량 모델 (예: GPT-5.6 Luna)을 지칭합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Vision-Language-Action (VLA) 모델이 다양한 task 및 환경에서 로봇 조작 능력을 확장하는 데 있어 직면하는 문제를 해결하고자 합니다. VLA 모델은 광범위한 조작 기능을 제공하지만, 실행 중 발생하는 오류를 진단하고 동작을 조정하는 데 어려움을 겪을 수 있습니다. 특히, 강력하고 고비용의 에이전트에 지속적인 실행을 의존하는 것은 비효율적이며, 이러한 에이전트의 전문 지식을 더 가볍고 저렴한 모델로 이전하는 과정 또한 자원 소모가 큽니다. 따라서, 제한된 token budget 내에서 강력한 에이전트의 전문 지식을 경량 모델에 어떻게 효과적으로 증류하여 VLA를 효율적으로 운영할 수 있도록 돕고, 이러한 개입 경험을 에이전트 간에 축적하고 재사용하는 것이 핵심 문제입니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 강력한 에이전트의 경험을 경량 에이전트를 위한 재사용 가능한 Harness로 증류하고, 경량 에이전트의 실행 피드백을 활용하여 Playbook을 재귀적으로 개선하는 Recursive Harness Distillation (RHD) 프레임워크를 제안합니다 [Figure 1]. 이 Playbook은 VLA 실행에 대한 instruction, attention, action 세 가지 개입(intervention) 지점을 통해 가이드 역할을 수행합니다. 강력한 에이전트는 먼저 VLA와 상호작용하여 효과적인 전략을 Playbook에 기록하고, 이후 경량 에이전트가 이 Harness를 사용하여 task를 실행하며 발생한 경험을 강력한 에이전트가 검토하여 지침을 수정합니다. 이러한 반복적인 과정을 통해 Harness는 VLA에 효과적인 방법과 경량 에이전트가 이를 적용하는 데 필요한 사항을 모두 학습합니다.
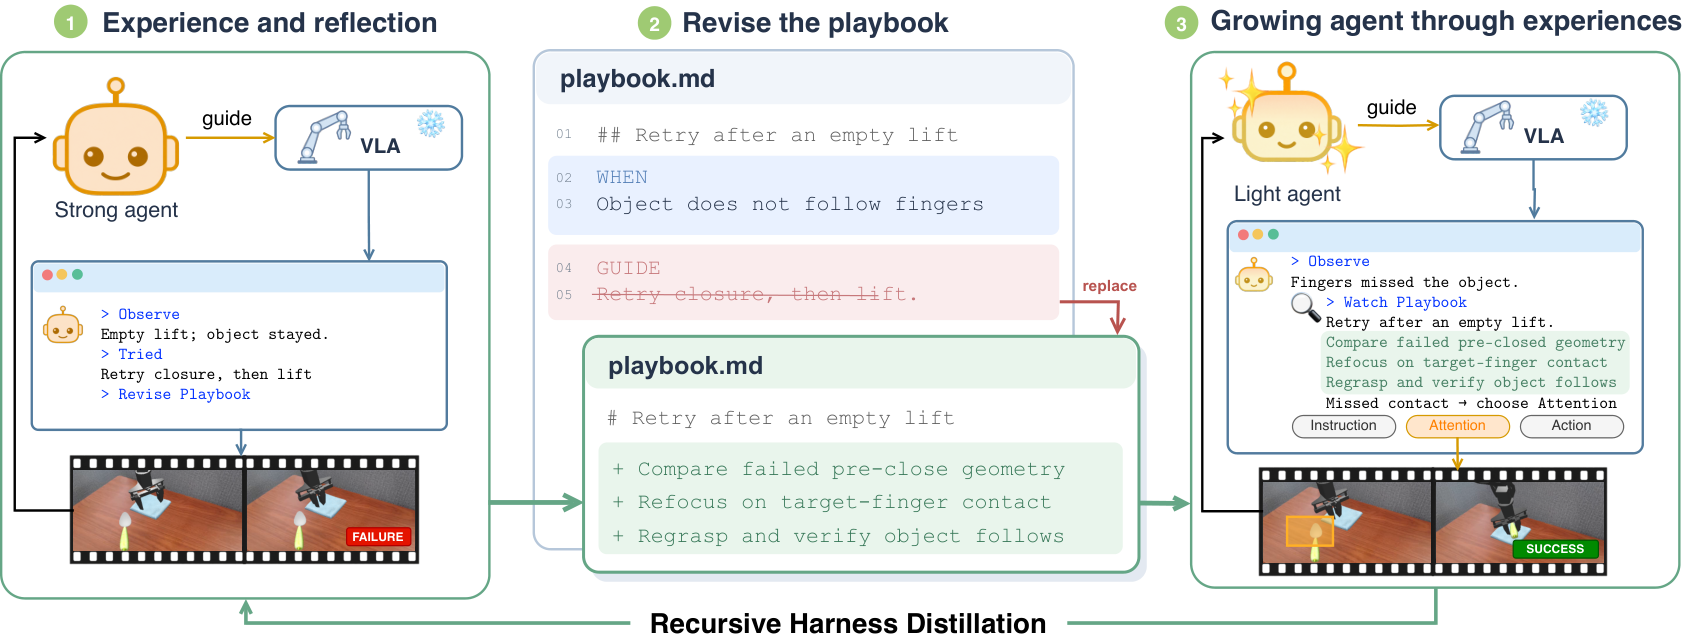
Figure 1 — 제안 방법론 개요
주요 실험 결과는 RHD의 효과를 정량적으로 보여줍니다:
- 실제 로봇 조작(real-world manipulation) task에서 Harness는 성공률을 37.3%에서 64.0%로 향상시켰습니다.
Luna(경량 에이전트)는 Playbook 없이π0.5정책과 함께 사용할 경우 0%의 성공률을 보였으나, 정제된 Playbook을 사용했을 때 64.0%의 성공률을 달성했습니다. SimplerEnv Bridge환경에서, Playbook이 적용된Luna + GR00T조합은 66.7%의 성공률을 달성하여,GR00T-only baseline의 41.7%를 크게 상회했습니다 [cite: 1, Figure 3]. 또한, Playbook 없는strong agent인Astra보다 더 우수한 성능을 보였습니다. 동일한 Playbook이Astra에도 적용되었을 때 성공률은 79.2%에 도달하여, Playbook이 다른 능력의 에이전트에게도 유용함을 입증했습니다.instruction editing(VLA 입력 수정)이 테스트된 개입 지점 중 가장 큰 성능 향상에 기여했습니다 [cite: 1, Figure 3].Luna를 teacher로 사용하여 Playbook을 생성했을 때는 22.9%의 성공률을 보인 반면,Astra를 teacher로 사용했을 때는 66.7%의 성공률을 달성하여, 강력한 teacher의 중요성을 강조합니다.- 배포 비용(deployment cost) 측면에서,
Luna는 Playbook을 통해 에피소드당 평균 $0.63의 추정 추론 비용을 발생시킨 반면,Astra는 $3.43를 기록하여, 경량 에이전트와 Playbook의 비용 효율성을 보여주었습니다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Recursive Harness Distillation이라는 프레임워크를 통해 강력한 에이전트가 VLA와의 상호작용을 통해 얻은 경험을 Playbook 형태로 축적하고, 이를 경량 에이전트가 재사용할 수 있도록 하는 새로운 방법을 제시합니다. 이 Playbook은 경량 에이전트의 실행 피드백을 바탕으로 재귀적으로 개선되며, model parameters를 업데이트하지 않고도 guidance를 recipient의 적용 방식에 맞게 조정합니다. SimplerEnv Bridge 및 실제 robot manipulation task에서의 실험 결과는 이 Playbook이 시뮬레이션 및 물리적 환경 모두에서 light agent가 배포된 policy를 조작하는 능력을 크게 향상시킨다는 것을 보여줍니다. 이 연구는 robotics 분야에서 harness distillation의 실현 가능성을 입증하며, 배포된 policy와의 경험이 축적되고 실행을 통해 정제되어 에이전트 간에 재사용될 수 있음을 시사합니다. 결과적으로, 이 접근 방식은 로봇 시스템의 robustness와 generalization을 향상시키면서도 고비용 model에 대한 의존도를 줄여, cost-effective deployment의 가능성을 열어줍니다.
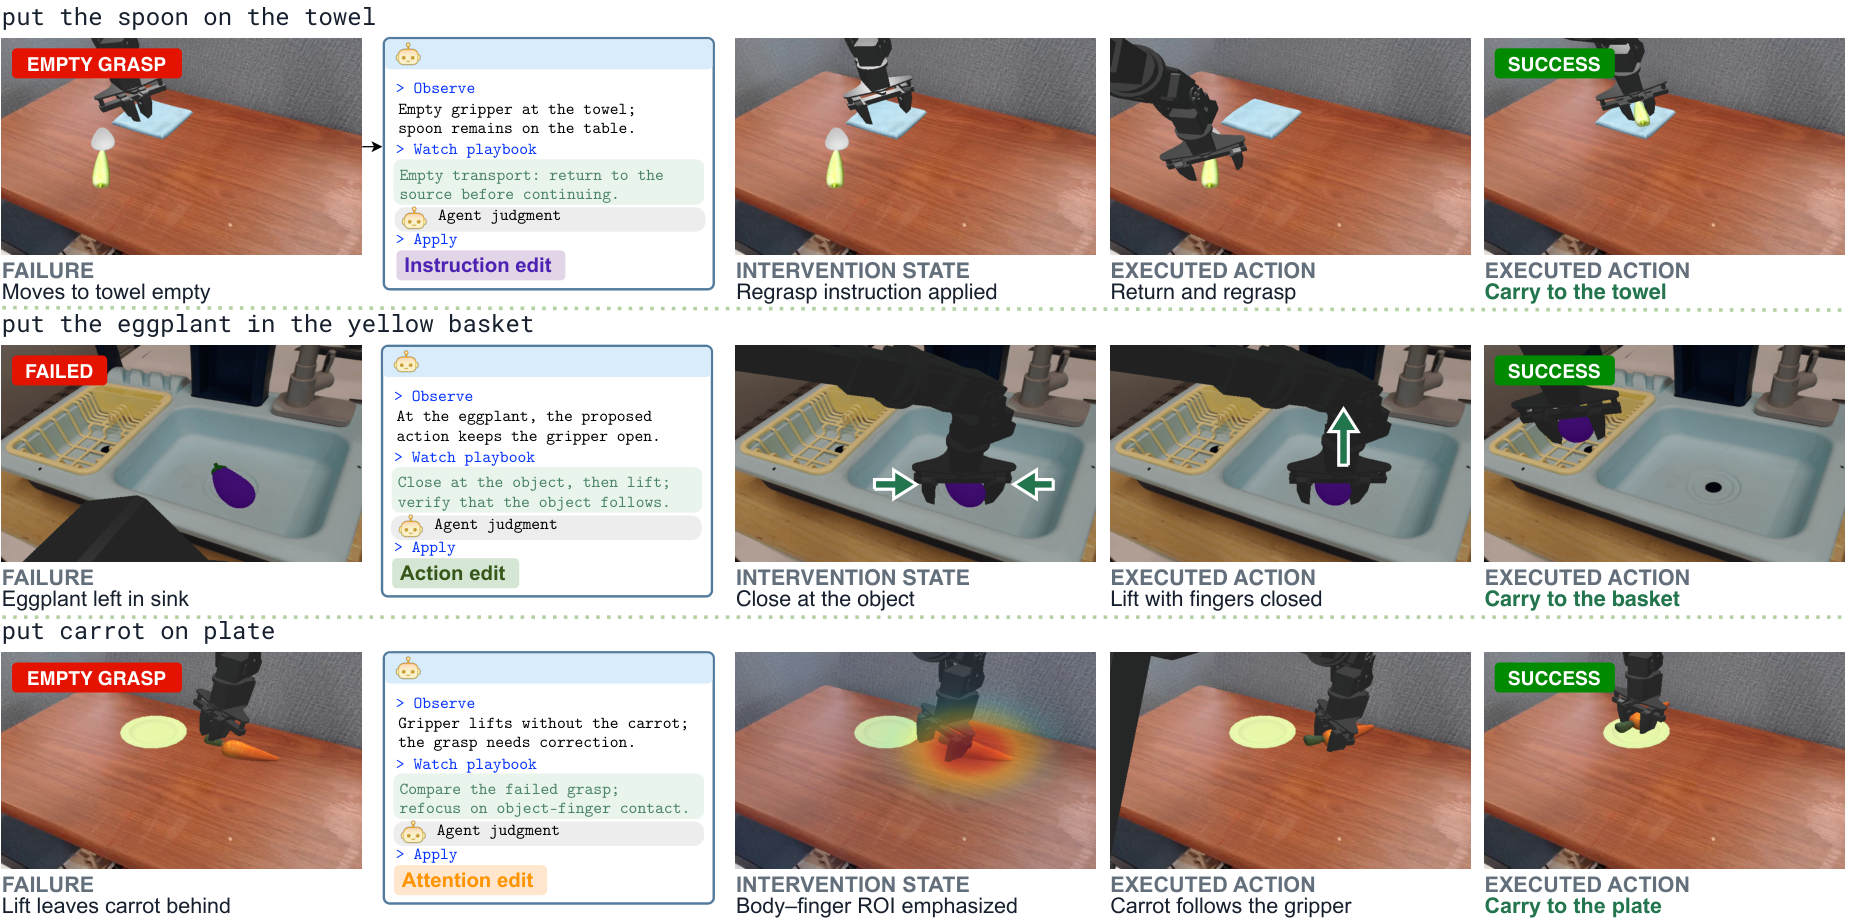
Figure 7 — 플레이북 기반 복구 예시
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Task adaptation of Vision-Language-Action model: 1st Place Solution for the 2025 BEHAVIOR Challenge
- [논문리뷰] VLA-Precision: Asymmetric Co-Bootstrapping for Efficient Real-World Online RL of Vision-Language-Action Models
- [논문리뷰] InternW0-Δ: A World Action Model Bridging Predictive Dynamics and Actions with 20K+ Hours of Open Data
- [논문리뷰] The Tasteful Agent: Measuring and Improving Taste in Long-Horizon Tasks
- [논문리뷰] Learning Foresight without Explicit Trajectories for 3D Diffusion Policies
Review 의 다른글
- 이전글 [논문리뷰] REALM: A Coarse-to-Fine Generative Framework for Embodied Reactive Listening
- 현재글 : [논문리뷰] Recursive Harness Distillation across Agents for Robot Manipulation
- 다음글 [논문리뷰] Residual Transferability in Neural Image Watermarking
댓글