[논문리뷰] REALM: A Coarse-to-Fine Generative Framework for Embodied Reactive Listening
링크: 논문 PDF로 바로 열기
저자: Peizhen Li, Longbing Cao, Yang Zhang
1. Key Terms & Definitions
- Embodied Reactive Listening: 가상 또는 물리적 에이전트가 대화 중 화자의 오디오에 반응하여 자연스러운 청자의 비언어적 동작(예: 고개 끄덕임, 표정 변화)을 생성하는 기술.
- Coarse-to-Fine Generative Framework: 전체적인 모션 궤적을 예측하는 "Coarse" 단계와 미세하고 확률적인 표정 변화를 추가하는 "Fine" 단계로 구성된 생성 모델 아키텍처.
- Reactive Gated Speaker–Listener Fusion: 청자의 모션 히스토리와 화자의 오디오 정보를 통합하는 모듈로, 대화 맥락에 따라 이 두 정보원의 기여도를 조절하는 Delay-Aware Attention Prior 및 Adaptive Gating 메커니즘을 포함합니다.
- Expression Subspace: 얼굴 모션 중 비강체(non-rigid)적인 표정 변화만을 담당하는 부분으로, 눈 깜빡임이나 미세한 표정 변화와 같은 국소적인 동적 이벤트를 지칭합니다.
- Delay-Centered Attention Prior: 화자 오디오와 청자 반응 사이의 시간적 지연(Temporal Lag)을 명시적으로 고려하여, 특정 반응 지연 시간(
τ) 근처의 화자 표현에 더 큰 가중치를 부여하는 어텐션 메커니즘입니다.
2. Motivation & Problem Statement
본 논문은 Embodied Conversational AI를 위한 반응형 청자 Facial Motion 생성에서 직면하는 두 가지 핵심 문제를 해결하고자 합니다. 첫째, 청자 반응은 화자 발화와 시간적으로 정확히 일치하지 않고 지연(Temporal Lag)될 수 있으며, 청자의 지속적인 모션과의 연속성(Behavioral Continuity)을 유지하면서도 화자 신호에 적절히 반응하는 타이밍을 포착하는 것이 어렵습니다 [Figure 1]. 기존 연구들은 화자 오디오에 기반한 생성에 초점을 맞추지만, 이러한 미묘한 시간적 조율과 청자 모션 히스토리의 적응적 활용에 대한 통합적 접근이 부족했습니다. 둘째, 전반적인 모션 궤적(Overall Motion Trajectory)과 함께 발생하는 짧고 국부적인 얼굴 표정 변화(예: Blinks, Brief Expressions)는 예측하기 어려운 다중 모달(Multimodal) 특성을 가지며, 결정론적(Deterministic) 재구성 목표는 이러한 변화를 평균화하여 부자연스러운 과도한 Smoothing을 유발하는 경향이 있습니다 [Figure 1]. 이는 현실적인 대화형 에이전트 구현에 중요한 도전 과제로 작용합니다.
3. Method & Key Results
본 논문은 Audio-driven 반응형 Listening을 위한 REALM (Reactive Embodied Audio-driven Listening Model)이라는 Coarse-to-Fine Generative Framework를 제안합니다 [Figure 2]. 이 프레임워크는 두 가지 주요 원칙을 통합합니다. 첫째, Reactive Gated Speaker–Listener Fusion 모듈은 Shifted ALiBi Bias를 활용하여 명목상의 반응 지연(τ) 근처의 화자 표현을 선호하는 Delay-Aware Speaker–Listener Alignment를 구현합니다. 동시에 학습된 게이트(g_t)는 화자 Context와 청자 History의 상대적 기여도를 적응적으로 조절하여 연속성과 반응성 간의 균형을 맞춥니다. 둘째, Coarse-to-Fine Stochastic Refinement는 먼저 Coarse Decoder를 통해 기본 모션 궤적(m~t)을 예측한 후, Expression Subspace에만 한정된 Audio-Conditioned Stochastic Expression Residuals(Δxt)를 추가하여 미세한 표정 변화를 모델링합니다. 이 방식은 Rigid Pose Parameters는 유지하면서 비강체(Non-rigid) 표정의 국소적, 확률적 변화를 포착합니다. 또한, 생성된 모션은 Inverse Kinematic Mapping과 Relative Motion Calibration을 통해 Ameca 휴머노이드 로봇에 Physical Grounding되어 실제 로봇 동작으로 변환됩니다.
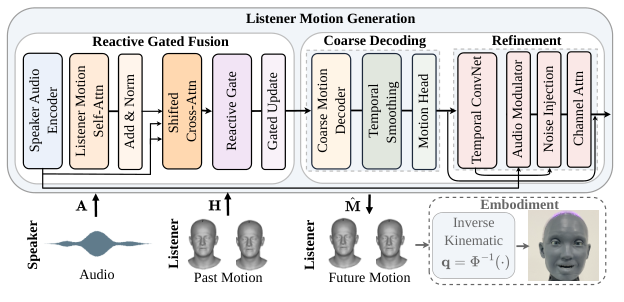
Figure 2 — REALM 시스템 개요
정량적 평가에서 REALM은 ViCo 및 L2L 데이터셋 모두에서 평가된 Baseline 대비 우수한 성능을 보였습니다. REALM은 Expression 및 Pose의 Point-wise L1 Errors에서 지속적으로 가장 낮은 수치를 달성했으며, 특히 ViCo Dtest에서 Expression FIDΔfm 값을 ListenFormer의 8.71에서 3.91로 크게 감소시켜 Temporal Transition Realism을 향상시켰습니다. 이는 Stochastic Refinement가 정적(Static) 궤적 추적보다는 프레임 간 Facial Dynamics에 주로 기여함을 시사합니다. 또한, REALM은 Ground-Truth Interaction Dynamics와의 밀접한 Alignment를 나타내는 가장 낮은 rPCC 값을 기록했습니다. Ablation Study 결과, Shifted Attention은 Pose rPCC를 0.026에서 0.018로 감소시켰고, Gated Fusion은 Structural Drift를 방지하며 가장 낮은 Pose Error를 달성했습니다. Refinement Module은 Expression FIDΔfm을 ∼12.50에서 3.91로 급격히 감소시키며 Dynamic Facial Fidelity를 향상시켰습니다. Ameca 로봇에서의 User Study에서도 REALM은 Naturalness, Audio-Visual Synchrony, Contextual Appropriateness, Overall Preference 등 모든 Perceptual Metrics에서 가장 높은 Mean Opinion Score (MOS)를 얻었습니다 [cite: 1, Figure 3].
4. Conclusion & Impact
본 논문은 Audio-driven Listener Motion Generation을 위한 REALM이라는 Coarse-to-Fine Framework를 성공적으로 제안했습니다. 이 프레임워크는 Delay-Centered Attention Prior와 Adaptive Gating을 통한 Reactive Fusion 모듈, 그리고 Coarse Head-Pose Trajectory를 보존하면서 Audio-Conditioned Stochastic Expression Residuals를 추가하는 Refinement 모듈을 통해 청자 모션의 연속성, 반응성, 국소적 표정 다양성을 효과적으로 균형 잡습니다. ViCo 및 L2L 데이터셋에 대한 정량적 평가와 Ameca 로봇에서의 Perceptual User Study를 통해 REALM의 우수성이 입증되었으며, 특히 기존 Baseline 대비 Micro-dynamics의 사실성 및 전반적인 지각적 품질에서 상당한 개선을 보였습니다. 이 연구는 Human-Robot Interaction, Telepresence, Embodied Conversational Agents 분야에서 더욱 자연스럽고 Engaging한 비언어적 청자 행동을 생성하는 데 중요한 진전을 제공하며, 궁극적으로 인간-로봇 커뮤니케이션의 Affective Fidelity를 향상시키는 데 기여합니다.
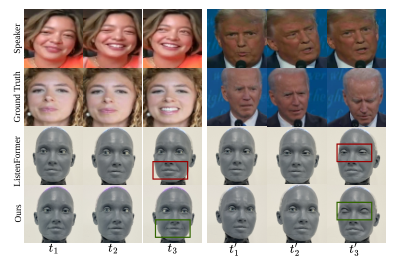
Figure 3 — Ameca 로봇 구현 결과
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] RobotValues: Evaluating Household Robots When Human Values Conflict
- [논문리뷰] EgoActor: Grounding Task Planning into Spatial-aware Egocentric Actions for Humanoid Robots via Visual-Language Models
- [논문리뷰] VL-LN Bench: Towards Long-horizon Goal-oriented Navigation with Active Dialogs
- [논문리뷰] PhysBrain: Human Egocentric Data as a Bridge from Vision Language Models to Physical Intelligence
- [논문리뷰] An Anatomy of Vision-Language-Action Models: From Modules to Milestones and Challenges
Review 의 다른글
- 이전글 [논문리뷰] QwenGyre: An Elastic Reinforcement Learning Framework for Training xLong-Horizon Agents
- 현재글 : [논문리뷰] REALM: A Coarse-to-Fine Generative Framework for Embodied Reactive Listening
- 다음글 [논문리뷰] Recursive Harness Distillation across Agents for Robot Manipulation
댓글