[논문리뷰] Embodied Turing Machines: Stateful Code for Robot Recursive Self-Improvement
링크: 논문 PDF로 바로 열기
저자: Kairui Hu, Siyuan Hu, Fangzhou Hong, Zhaoxi Chen, Ziwei Liu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
본 논문에서 제안하는 Code-Only-as-Policy (COAP) 프레임워크를 이해하는 데 필수적인 핵심 용어는 다음과 같습니다.
- Embodied Turing Machine: 로봇과 환경의
State를Tape로, 로봇의Policy를Rules로 비유하여 물리적 세계를 추상화한 개념입니다.State는 로봇의Proprioception과 환경의Observation을 통해 측정되며,Policy는 이State를 기반으로Action을 결정합니다. - Code-Only-as-Policy (COAP):
Embodied Turing Machine개념을 직접 구현한Policy로,Vision-language-action models (VLAs)나Agent Harness없이 모든Decision Making이 코드로 작성되어State를 측정하고 추적합니다. 런타임에는 코드가 고정되어 유일한Policy역할을 합니다. - Vision-language-action models (VLAs): 카메라 이미지와 같은
Observation을 입력받아Action으로 매핑하는Policy를 학습하며, 이 매핑은 모델의Weights내부에Implicit하게 존재합니다. - Agent Harness:
Vision-language model (VLM)이 로봇을 직접 제어하거나VLA를 지시하는 시스템으로,Textual Memory와 같은 일부 프로세스는Explicit하지만,VLM과VLA는Black Box로 남아Action이 도출되는 과정을 완전히 검사하거나 제어하기 어렵습니다. - Recursive Self-Improvement (RSI): 코딩
Agent가 고정된 규칙 하에Code Library를Closed Loop로 개발하고Debugging하며 지속적으로 개선하는 과정입니다. 각 변경 사항은Explicit하고Controllable합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
기존 로봇 Policy들은 대부분 Vision-language-action models (VLAs)나 Agent Harness와 같이 Control Loop 내에 Model을 포함합니다. 이러한 Model들은 Observation을 Action으로 매핑하지만, 그 과정이 Implicit하거나 Black Box 형태로 작동하여 Decision Making을 완전히 Inspect하고 Control하기 어렵다는 한계가 있습니다. 특히 Agent Harness는 런타임에 VLM에 대한 반복적인 쿼리로 인해 예측 불가능한 Randomness와 높은 Compute Cost를 발생시키며, Failure Recovery가 유연하지 못하고 Capabilities를 Cumulative하게 확장하기 어렵습니다. 이러한 한계점들은 로봇이 안정적으로 장기적인 Task를 수행하고 Recursive Self-Improvement (RSI)를 달성하는 데 큰 장애물로 작용합니다. 본 논문은 이러한 기존 Model-in-the-loop Policy들의 Black Box 특성과 Controllability 부족 문제를 해결하기 위해, Explicit State와 Controllable Code Logic을 기반으로 하는 새로운 Policy Paradigm의 필요성을 제기합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 로봇과 환경을 Embodied Turing Machine으로 모델링하고, 이를 Code-Only-as-Policy (COAP)라는 Shared Code Library로 구현하는 방법론을 제안합니다. COAP는 Code Variable에 State를 저장하고, Source Code가 Rules를 구성합니다. 이 State는 환경 State (객체 Pose, 공간 관계), 로봇 State (Joint Angle, End-effector Pose), 그리고 Task State (현재 단계, Retry Count)의 세 부분으로 나뉩니다. Perception Code는 NumPy 및 OpenCV를 기반으로 카메라 이미지로부터 환경을 측정하며, 이 Perception 과정 자체가 코드로 구현되어 State의 Programmability를 높입니다. COAP는 런타임에 Code가 고정되고, Coding Agent들이 Offline으로 Recursive Self-Improvement (RSI) Loop를 통해 코드를 개선합니다. Shared Library는 모든 Task가 동일한 형태의 State를 사용하고, 계층적으로 구성되어 (Task Code → Object-specific Code → Manipulation Code → Perception/Motion Code) Reusability와 Extensibility를 극대화합니다. 새로운 Task는 기존 Module을 Compose, Inherit, 또는 Default-off Parameter를 통해 Extend할 수 있으며, 이로써 Backward Compatibility가 보장됩니다.
실험 결과, COAP는 RoboDojo의 42개 bimanual task에서 70.24%의 높은 Success Rate를 달성하여, 기존 State-of-the-art 방법론 대비 38.9 Percentage Point 더 우수한 성능을 보였습니다. 특히 Memory Task에서는 89.9% (기존 최고 대비 +39.6 Points)를, Precision Task에서는 75.1% (기존 최고 대비 +41.6 Points)를 기록하며, Explicit State 추적 및 정확한 측정의 이점을 명확히 입증했습니다. COAP의 Execution은 매우 Efficient하여, CPU에서 Median Control Step이 0.3 ms에 불과하며, 이는 VLA Compute의 0.8–2.4%, Agent Harness Compute의 0.1% 미만 수준입니다. Extensibility 측면에서는 새로운 Task Code의 83%가 Shared Library에서 재사용되었으며, Offline 개발을 통해 데이터나 Training 없이 새로운 Task에서 15시간 내 평균 47%의 Validation Success Rate를 달성했습니다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Embodied Turing Machine이라는 개념적 프레임워크를 기반으로 Code-Only-as-Policy (COAP)를 제안하며, 로봇 제어 분야에 새로운 Paradigm을 제시합니다. COAP는 Explicit State, Controllable Execution, 그리고 Cumulative Extensibility라는 세 가지 핵심 이점을 통해 기존 VLA 및 Agent Harness 기반 Policy들의 한계를 극복합니다. 특히 RoboDojo 벤치마크에서 70.24%의 Success Rate를 달성하여 State-of-the-art 성능을 크게 능가했으며, 이는 Memory 및 Precision과 같이 State의 정확한 표현이 중요한 Task에서 특히 두드러졌습니다.
COAP의 White Box 특성은 Recursive Self-Improvement (RSI)에 매우 적합하며, Coding Agent들이 효율적으로 코드를 개발하고 개선할 수 있는 환경을 제공합니다. 또한, COAP는 빠르고 Reproducible하게 성공적인 Trajectory를 생성할 수 있어, 미래의 VLA 및 Agent Harness를 위한 Efficient Data Engine으로서의 역할을 수행할 잠재력을 가집니다. 궁극적으로 이 연구는 Embodied AI 분야에서 Code가 물리적 세계의 Universal Interface가 될 수 있음을 시사하며, State Representation의 정확성과 Code Logic의 견고성이 Policy Performance의 상한선을 결정하는 중요한 요소임을 강조합니다.
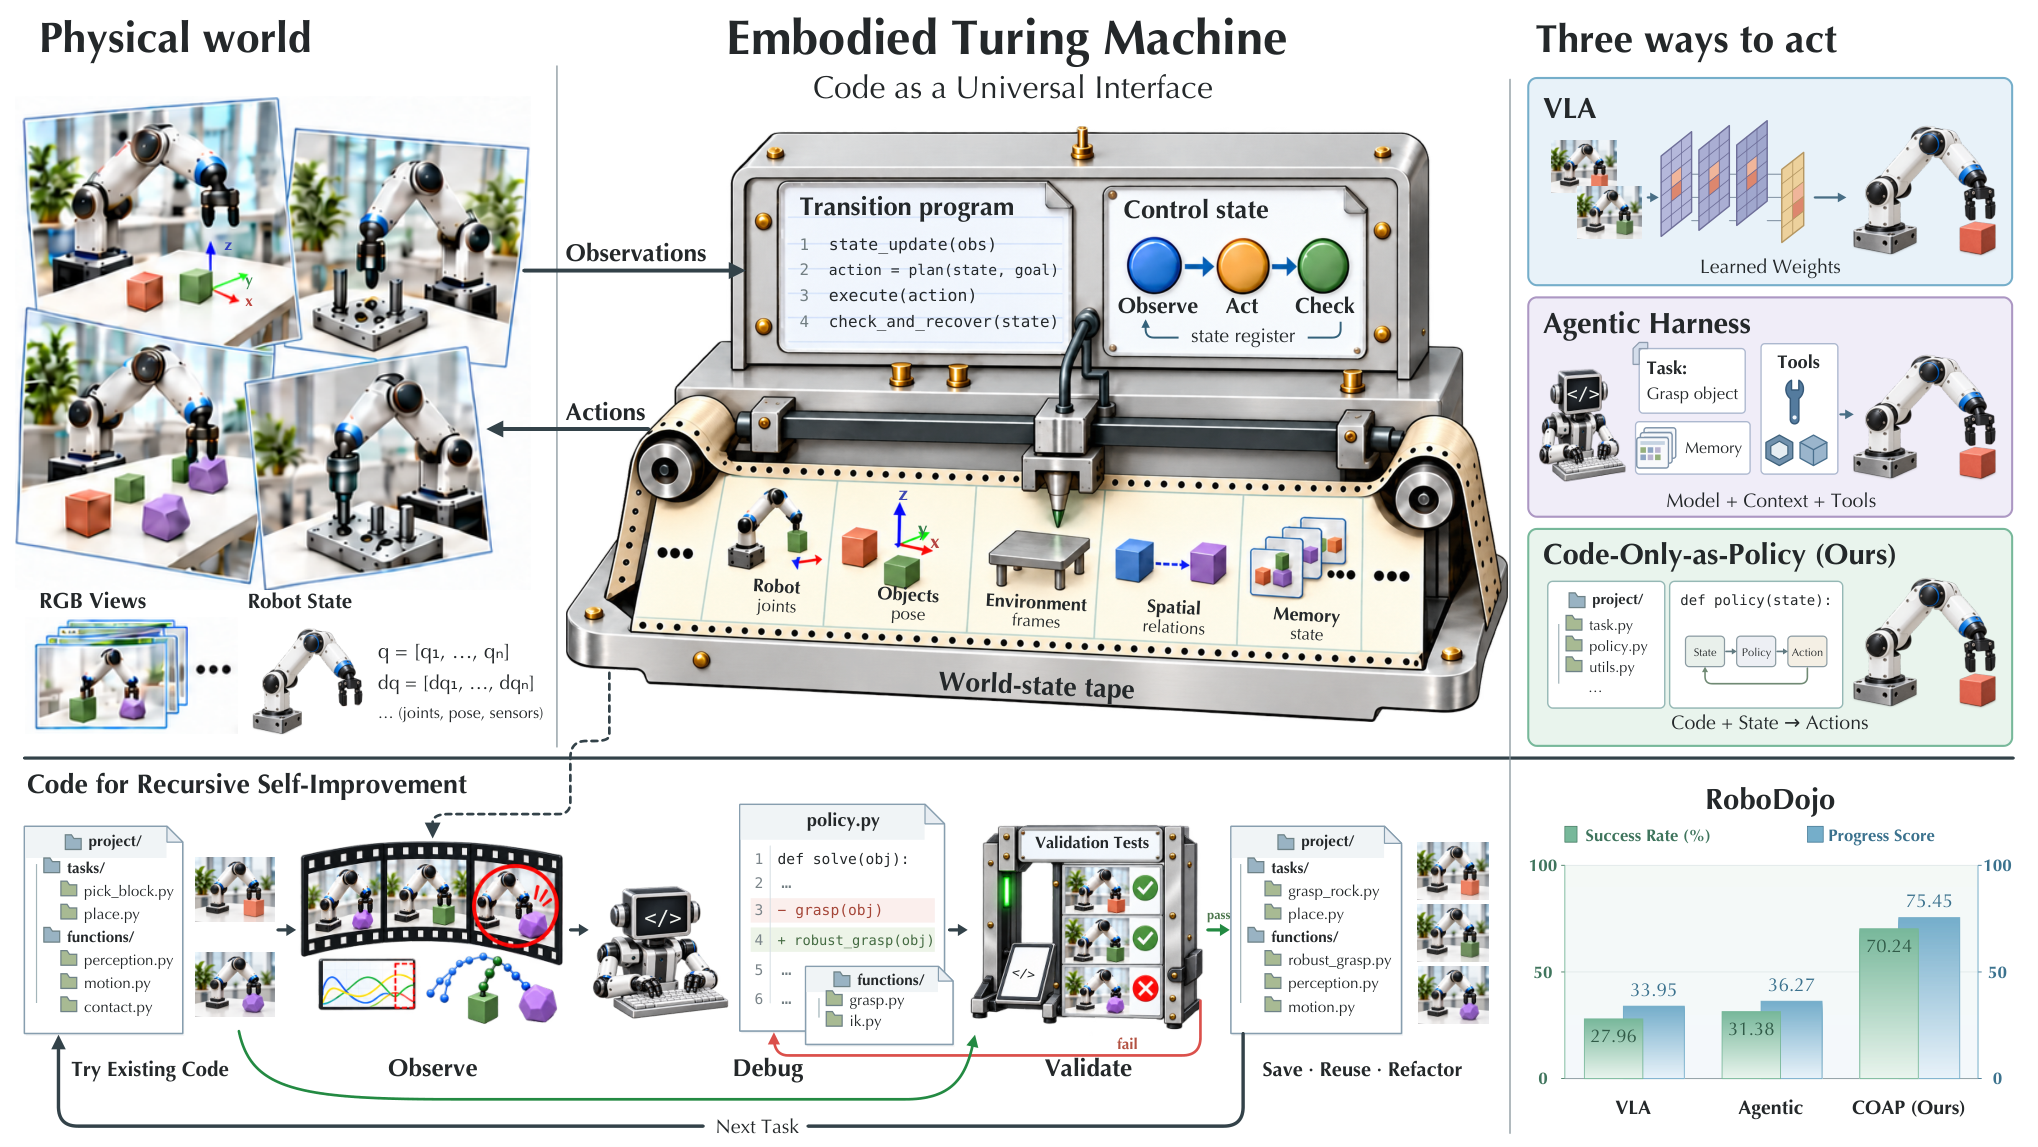
Figure 1 — 제안 모델의 개요
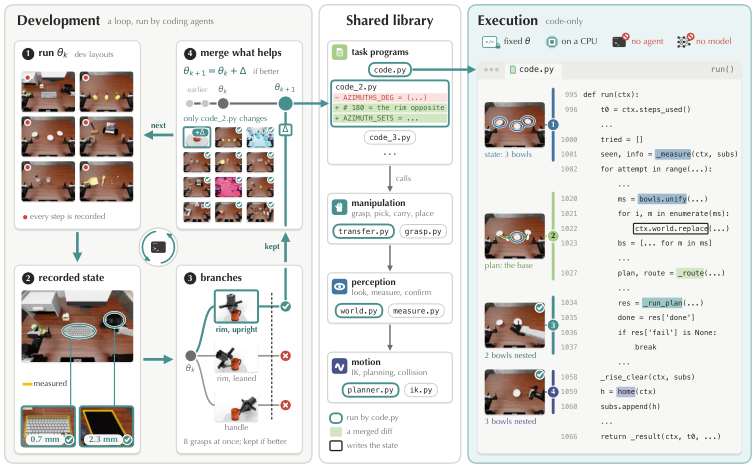
Figure 3 — COAP 방법론 흐름도
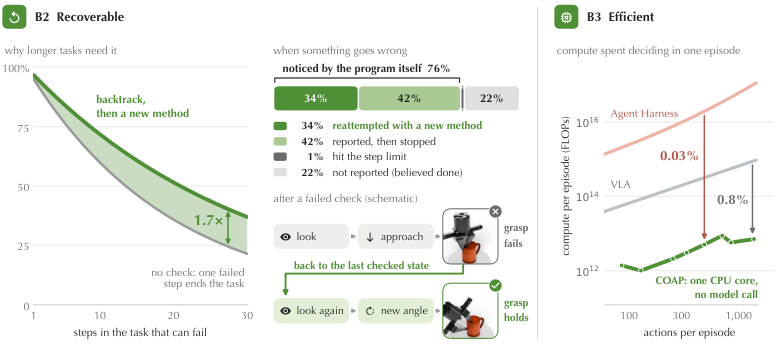
Figure 6 — 실행 이점 (복구 및 효율성)
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Self-Evolving Agent Harness
- [논문리뷰] Towards Agentic Robots: Model, Data, Environment, and Harness
- [논문리뷰] A Safe Action Is Not Enough: Feasible-Future Decoding for Vision-Language-Action Policies
- [논문리뷰] Beyond Future Prediction: Denoising as Generative Adaptation for Robot Control
- [논문리뷰] DeltaWAM: Delta World Action Models for Bimanual Manipulation
Review 의 다른글
- 이전글 [논문리뷰] DreamTrue: Action-Faithful Robot World Model with Counterfactual Post-Training
- 현재글 : [논문리뷰] Embodied Turing Machines: Stateful Code for Robot Recursive Self-Improvement
- 다음글 [논문리뷰] Foundations of Large Language Models
댓글