[논문리뷰] DreamTrue: Action-Faithful Robot World Model with Counterfactual Post-Training
링크: 논문 PDF로 바로 열기
메타데이터
저자: Junyan Li, Ruizhi Li, Yu Liu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Offline Geometric Calibration: 별도의 보정 시퀀스 없이 기존 녹화 데이터의 RGB 이미지 대응 관계만을 사용하여 카메라 파라미터 및 로봇 마운팅 오프셋을 정밀하게 보정하는 기술.
- Counterfactual Post-Training: 녹화된 동작 궤적을 인위적으로 변형(Perturbation)하여 생성한 가상의 동작 상황에서 모델을 추가 학습시켜, 다양한 접촉 구성과 실패 케이스에 대한 물리적 타당성을 확보하는 방법론.
- Embodied Video Reward Model: 로봇의 Embodiment, 객체 일관성, 그리고 상호작용의 타당성을 평가하기 위해 인간이 주석을 단 영상 데이터를 기반으로 학습된 보상 모델.
- VACE (Video Action-Conditioned Encoder): 로봇의 동작을 시각적 조건(Image-space condition)으로 변환하여 생성 모델의 DiT 레이어에 결합하는 아키텍처 브랜치.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 Robot World Model이 가진 동작 이행의 부정확성과 상호작용 실패에 대한 예측 편향 문제를 해결하기 위해 DreamTrue를 제안한다. 기존 연구들은 불완전한 카메라 보정으로 인해 로봇의 의도된 궤적과 영상 간의 공간적 불일치가 발생하며, 성공적인 데이터 위주의 학습으로 인해 실패 상황(예: 미스 그랩)에서도 성공을 환각(Hallucination)하는 한계가 있다. 이러한 문제는 신뢰할 수 있는 가상 환경 구축을 방해하며, 결과적으로 잘못된 정책 평가를 유도한다 [Figure 1]. 따라서 저자들은 추가적인 실세계 데이터 수집 없이 기존 데이터의 품질을 개선하고, 광범위한 실패 상황을 포함한 카운터팩추얼 학습 프레임워크가 필요하다고 판단하였다.
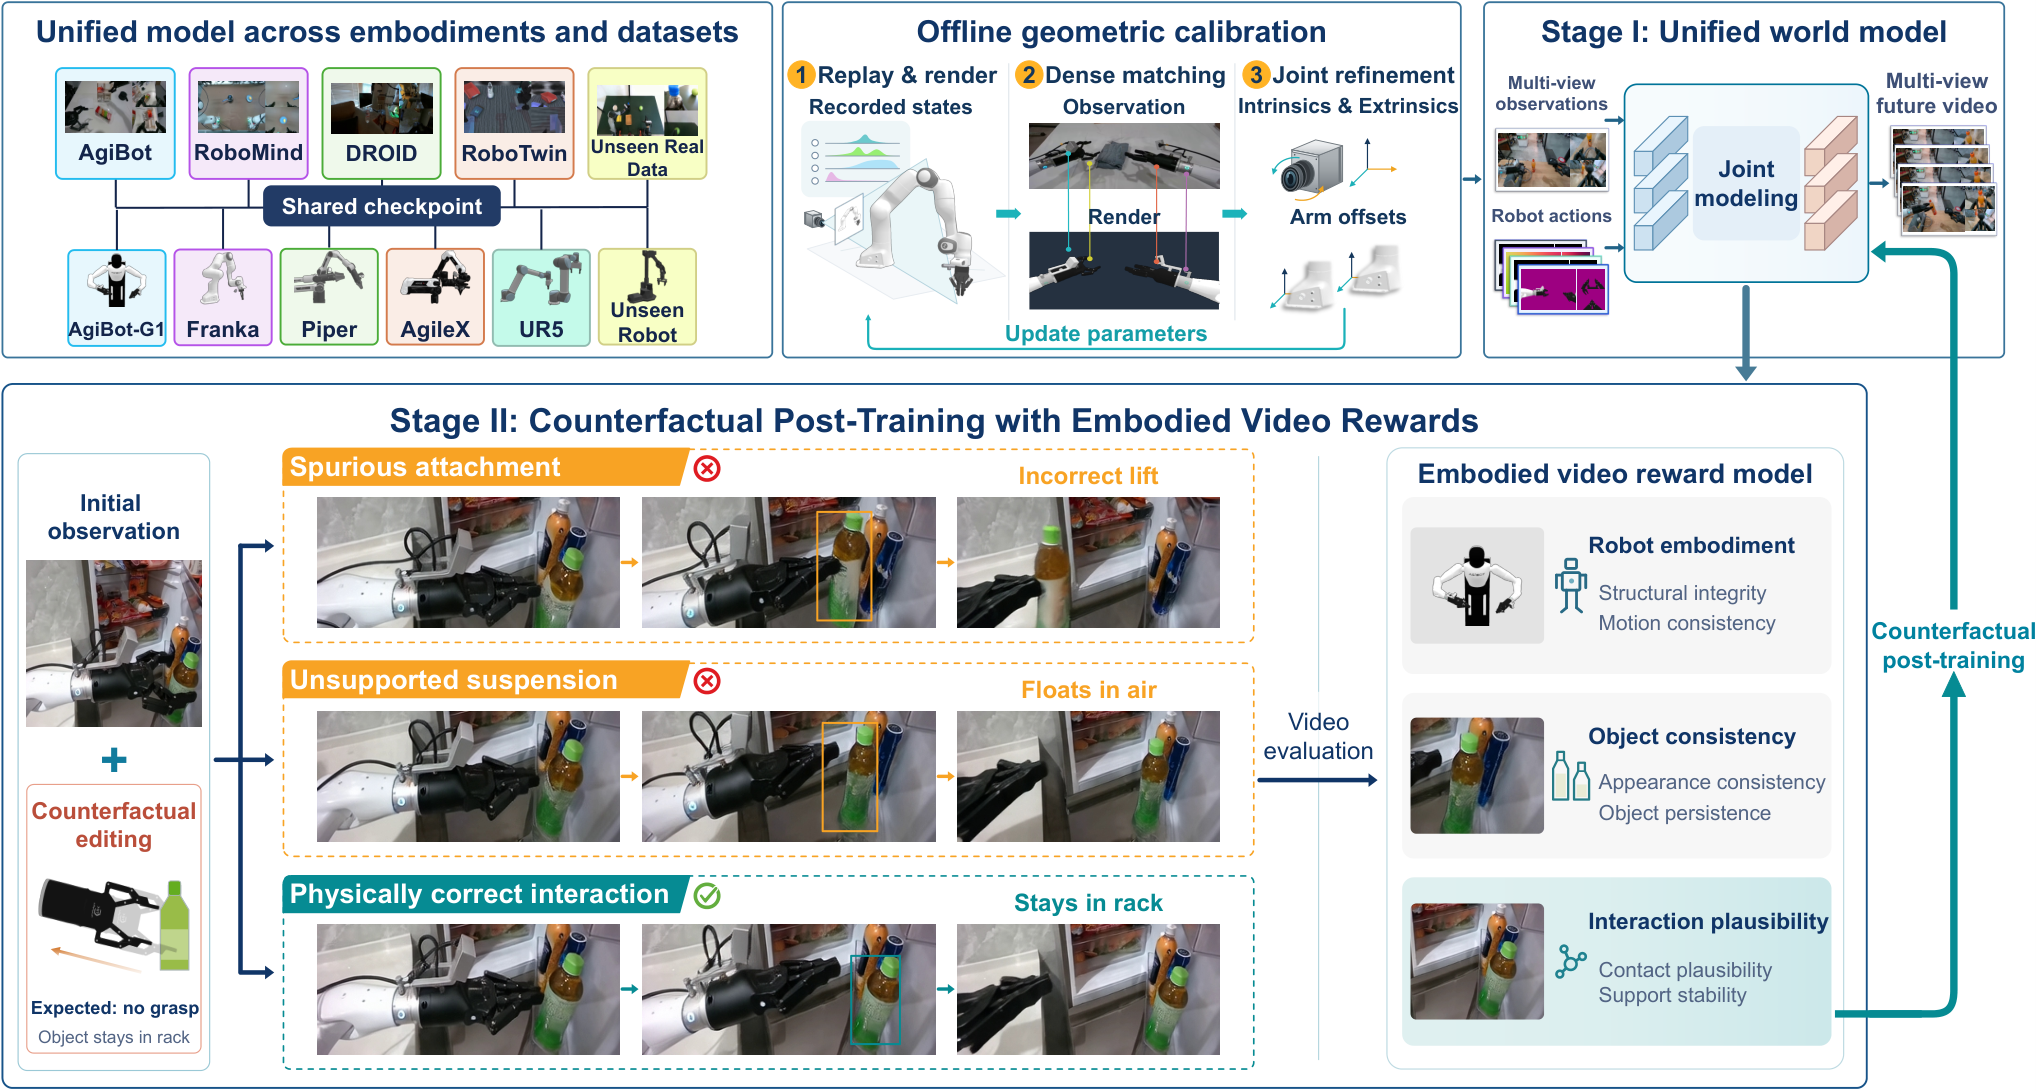
Figure 1 — DreamTrue의 전체 아키텍처 및 핵심 워크플로우
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들이 제안하는 DreamTrue는 오프라인 기하학적 보정(Geometric Calibration) 단계와 2단계의 학습 프로세스로 구성된다. 우선, 로봇의 URDF와 녹화 데이터를 매칭하여 카메라 파라미터를 최적화한 후, 이를 바탕으로 동작을 이미지 공간의 조건(RGB, Depth, Mask, Plücker Map)으로 변환하여 Cross-Embodiment 학습을 수행한다 [Figure 2], [Figure 3]. 2단계에서는 휴먼 어노테이션 기반의 Embodied Video Reward를 사용하여, 인위적으로 생성된 실패 케이스를 포함한 카운터팩추얼 궤적에 대해 물리적 타당성을 강화하는 보상 기반 후속 학습(Reward-guided post-training)을 진행한다 [Figure 4].
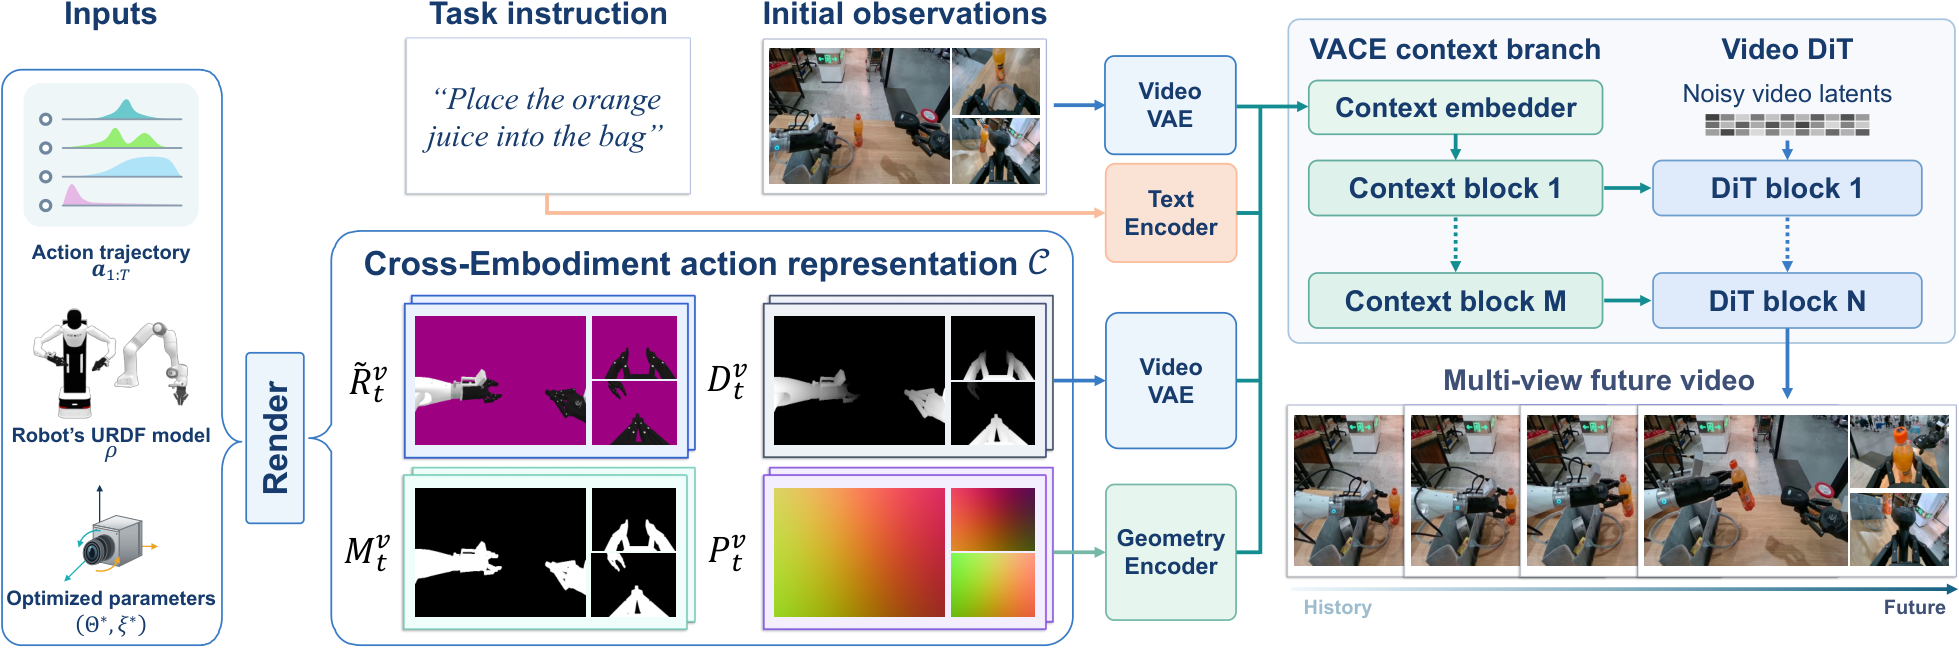
Figure 3 — 멀티뷰 월드 모델 아키텍처
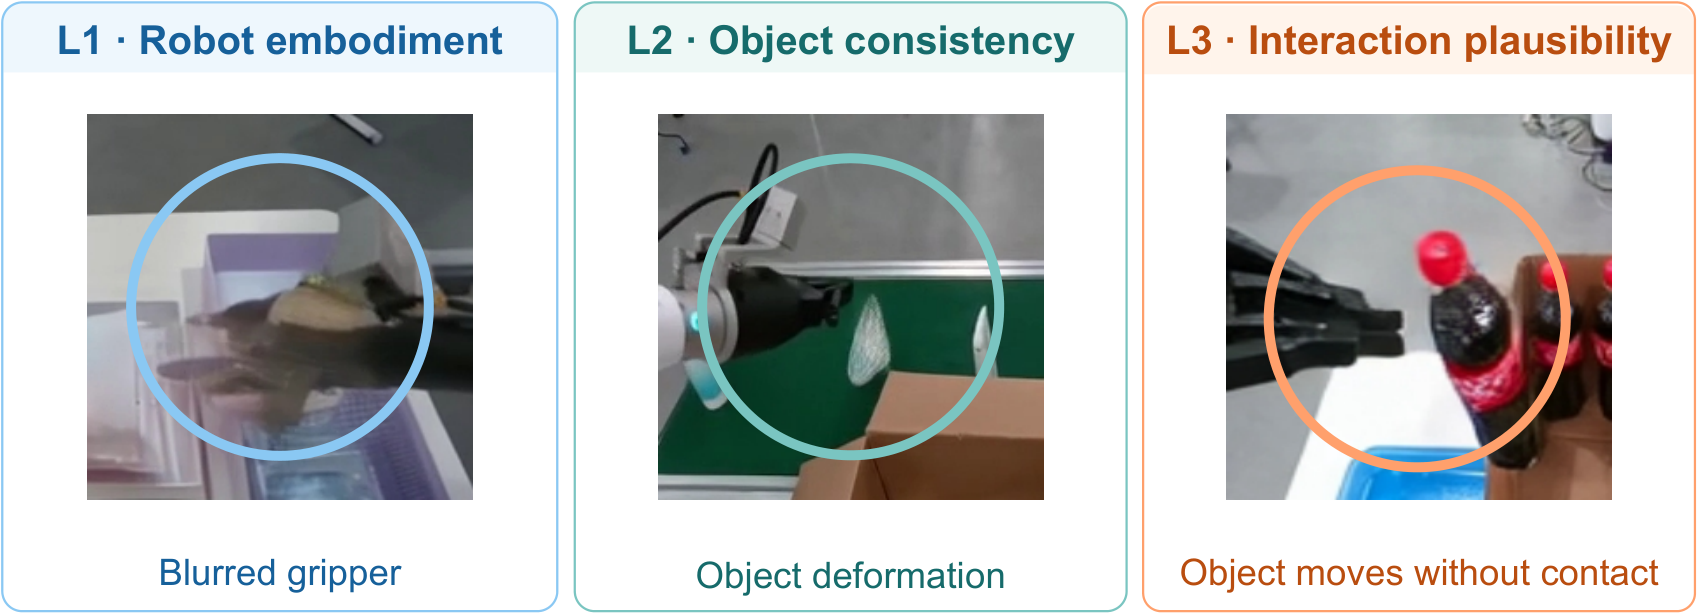
Figure 4 — 3단계 영상 결함 평가 차원
주요 실험 결과, DreamTrue는 AgiBot 벤치마크에서 nDTW 0.8772를 기록하며 SOTA 성능을 달성하였다. 또한, 보상 기반 후속 학습을 통해 인간이 평가한 상호작용 결함률(Interaction defect rate)을 기존 48.12%에서 6.25%로 대폭 감소시켰다 [Table 1]. 특히, 정책 평가(Policy Outcome Evaluation) 실험에서 success-rate MAE를 12.92에서 7.08로 개선하며, 실패한 상황에서의 잘못된 성공 예측 편향을 성공적으로 해소하였다 [Figure 8].
4. Conclusion & Impact (결론 및 시사점)
본 연구는 고품질의 기하학적 보정과 인간 피드백을 결합한 카운터팩추얼 학습이 Robot World Model의 동작 충실도와 물리적 타당성을 얼마나 향상시킬 수 있는지를 성공적으로 입증하였다. 이 프레임워크는 실제 로봇 데이터 수집이라는 값비싼 과정을 우회하여 모델의 견고성을 확보했다는 점에서 큰 학술적, 산업적 의의를 갖는다. 향후 이 모델은 복잡한 조작 태스크에 대한 신뢰성 높은 가상 시뮬레이터로서 Robot Learning 및 Policy 최적화 분야에 기여할 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] WorldLine: Action-Driven Visual Simulation for Robotic Manipulation
- [논문리뷰] DyPES-VLA: Learning Shared Dynamics Priors and Embodiment-Specific Control for Cross-Embodiment Manipulation
- [논문리뷰] Translation as a Bridging Action: Transferring Manipulation Skills from Humans to Robots
- [논문리뷰] Kairos: A Native World Model Stack for Physical AI
- [논문리뷰] ACE-Ego-0: Unifying Egocentric Human and Robotic Data for VLA Pretraining
Review 의 다른글
- 이전글 [논문리뷰] Do LLMs Understand Sequential Structure? A Controlled Study of Inference and Generation
- 현재글 : [논문리뷰] DreamTrue: Action-Faithful Robot World Model with Counterfactual Post-Training
- 다음글 [논문리뷰] Embodied Turing Machines: Stateful Code for Robot Recursive Self-Improvement
댓글