[논문리뷰] WorldLine: Action-Driven Visual Simulation for Robotic Manipulation
링크: 논문 PDF로 바로 열기
메타데이터
저자: Shenghe Zheng, Wenbo Li, Jiyao Zhang, Bin Xia, Haoyang Huang, Nan Duan, Jiaya Jia
1. Key Terms & Definitions (핵심 용어 및 정의)
- TI2V (Text-and-Image-to-Video): 초기 프레임과 작업 텍스트를 조건으로 입력받아 미래 영상을 생성하는 비디오 모델 아키텍처.
- Action Map: 로봇의 제어 명령(위치, 방향, 그리퍼 상태 등)을 카메라 뷰 공간으로 투영하여 시각적 heatmap 형태로 변환한 공유 제어 인터페이스.
- Causal Rollout: 미래의 시각적 결과를 예측하기 위해 비디오 모델을 순차적인 인과적 생성 과정으로 변환하여 효율적인 추론을 수행하는 기법.
- Robot-Mask IoU: 생성된 비디오와 실제 비디오 간의 로봇 영역 일치도를 측정하여 모델의 물리적 움직임 추종 능력을 평가하는 정량적 지표.
- Relational Regularization: 다중 뷰 및 시간적 일관성을 유지하기 위해 V-JEPA2와 같은 외부 모델의 특징 관계를 학생 모델에 증류(distillation)시키는 학습 전략.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 로봇 학습의 핵심 병목인 고비용 데이터 수집 문제를 해결하기 위해, 로봇 제어와 시각적 결과를 물리적으로 정합하게 예측하는 WorldLine을 제안한다. 기존의 비디오 생성 모델들은 시각적 그럴듯함에는 뛰어나지만, 로봇의 구체적인 명령을 이행하는 Action Fidelity와 로봇-객체 간의 역학(dynamics) 일관성이 부족하다는 한계를 가진다. 또한, 기존 액션 조건부 시뮬레이터들은 제어 공간이 서로 다른 다양한 로봇(embodiment) 데이터를 효과적으로 통합하지 못하고, 학습 데이터 부족 문제에 직면해 있다. 저자들은 이러한 문제를 해결하기 위해 방대한 액션 없는 비디오로 일반적인 역학을 학습하고, 액션 데이터로 제어를 정밀하게 접지(grounding)하는 이원화된 접근 방식을 도입하였다 [Figure 1].
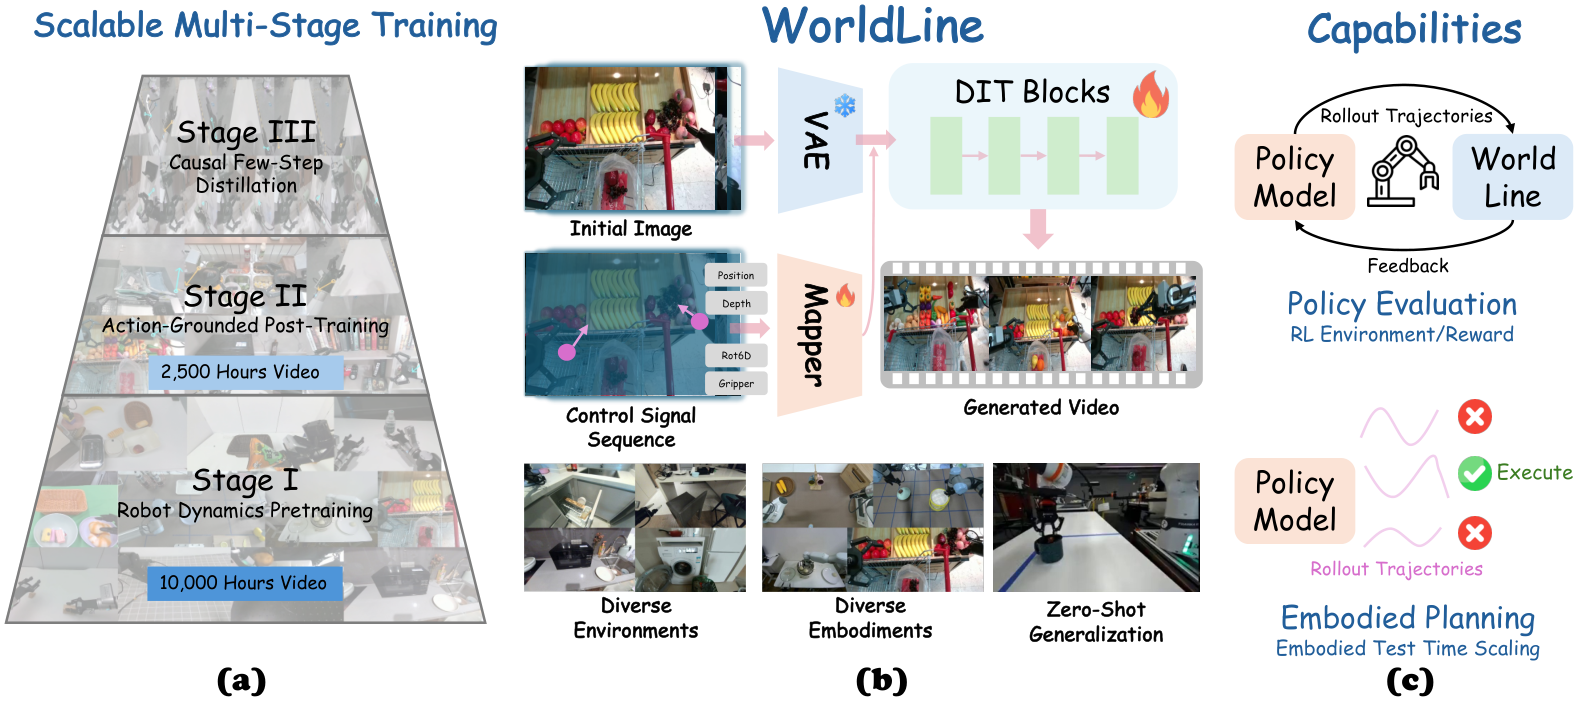
Figure 1 — WorldLine의 3단계 훈련 파이프라인
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 대규모 Action-Free 데이터로 사전 학습 후, 이질적인 제어 명령을 Image-Space 액션 맵으로 통일하여 학습하는 3단계 파이프라인을 제안한다. 먼저, Stage I에서 10,000시간 이상의 비디오로 범용 로봇 역학을 학습하고, Stage II에서 2,000시간 이상의 액션 데이터를 통해 다양한 임베딩 간의 제어를 공간적으로 정합시킨다 [Figure 2]. 마지막으로 Stage III에서는 Causal Distillation을 수행하여 낮은 지연 시간으로 효율적인 추론이 가능하게 한다. 실험 결과, WorldLine은 실패한 궤적 예측에서 기존 최강 모델 대비 Robot-Mask IoU를 0.1626만큼 향상시켰다. 또한, RoboTwin 및 AgiBot 환경에서 74%의 평균 궤적 성공률을 기록하였으며, 이는 기존 Baseline 대비 높은 성능이다. 특히 RoboTwin 테스트에서 별도의 학습이나 적응 없이도, π0.5 및 LingBot-VLA 정책의 작업 성공률을 각각 19.1%, 21.4% 향상시키는 성과를 거두었다 [Table 2].
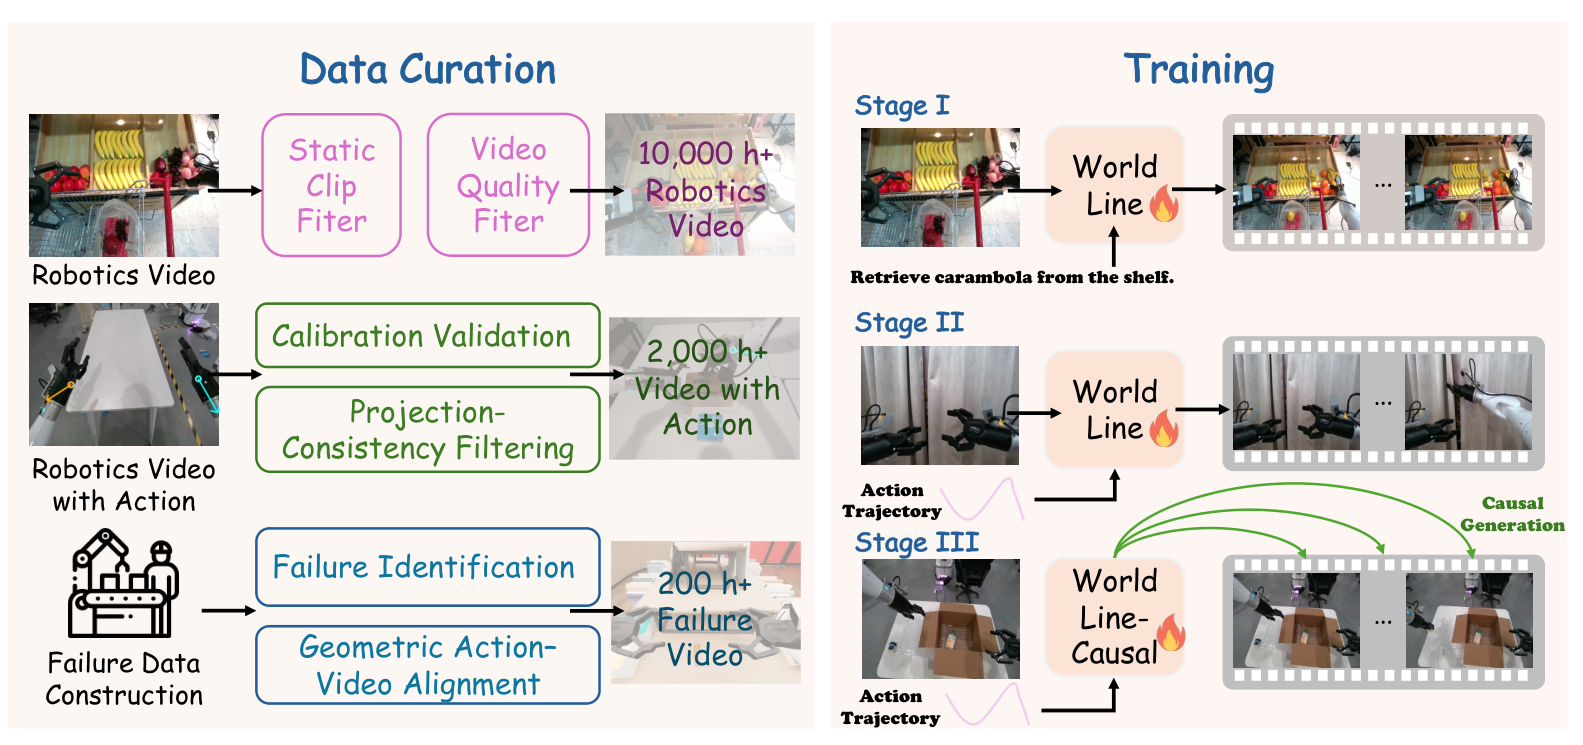
Figure 2 — 데이터 구성 및 훈련 과정
4. Conclusion & Impact (결론 및 시사점)
본 논문은 로봇 조작을 위한 확장 가능하고 효율적인 액션 중심 시뮬레이터인 WorldLine을 제시하여 비디오 생성 모델의 실용적 활용 가능성을 크게 확장하였다. 제안된 방법론은 다양한 로봇 플랫폼과 환경에 걸친 범용성을 입증하였으며, 특히 데이터가 제한된 상황에서도 강력한 일반화 성능을 보인다. 이 연구는 향후 로봇 정책 평가 및 계획(planning) 시스템의 정확도와 신뢰성을 높이는 데 핵심적인 기여를 할 것으로 기대된다. 결론적으로, 시각적 시뮬레이션의 물리적 충실도와 제어 이행 능력을 동시에 달성함으로써 로봇 학습의 자동화와 고도화를 가속화할 것이다.
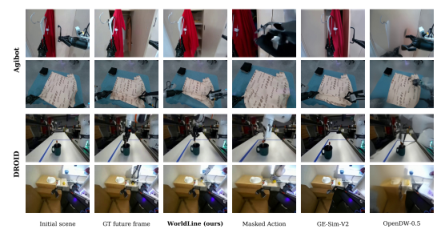
Figure 3 — 영상 생성 정성적 비교
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] ACE-Ego-0: Unifying Egocentric Human and Robotic Data for VLA Pretraining
- [논문리뷰] Recursive Harness Distillation across Agents for Robot Manipulation
- [논문리뷰] VLA-Precision: Asymmetric Co-Bootstrapping for Efficient Real-World Online RL of Vision-Language-Action Models
- [논문리뷰] InternW0-Δ: A World Action Model Bridging Predictive Dynamics and Actions with 20K+ Hours of Open Data
- [논문리뷰] Learning Foresight without Explicit Trajectories for 3D Diffusion Policies
Review 의 다른글
- 이전글 [논문리뷰] WorldAttention: An Efficient Attention Architecture for Interactive Video World Models
- 현재글 : [논문리뷰] WorldLine: Action-Driven Visual Simulation for Robotic Manipulation
- 다음글 없음
댓글