[논문리뷰] Questioning the Questions: Sustaining Self-Evolution in Reasoning Models
링크: 논문 PDF로 바로 열기
메타데이터
저자: Jinyuan Li, Chengsong Huang, Langlin Huang, Donghong Cai, Shiping Gao, Yuyi Yang, Jiaxin Huang
1. Key Terms & Definitions (핵심 용어 및 정의)
- R-Quest: 본 논문에서 제안하는, question validity와 novelty feedback을 활용하여 self-evolution을 지속 가능하게 만드는 학습 프레임워크입니다.
- R-Zero: 추론 모델의 self-evolution을 위한 기존 baseline 프레임워크로, questioner와 solver가 반복적으로 co-evolution하는 방식입니다.
- Validity-Aware Solver Initialization: solver가 학습 초기부터 유효하지 않은(invalid) 질문을 식별하고 거부하도록 사전에 훈련하는 방법론입니다.
- Novelty Feedback: 모델이 생성한 질문들이 단순히 단어만 바뀐 것이 아니라, 수학적 구조 측면에서 새로운지 여부를 판별하는 피드백 기제입니다.
- GRPO (Group Relative Policy Optimization): 본 논문에서 모델 학습을 위해 활용하는 강화학습 알고리즘으로, 여러 샘플 간의 상대적 성능을 최적화합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 reasoning model의 self-evolution 과정에서 반복적인 학습이 성능 붕괴(performance collapse)를 초래하는 원인을 규명하고 이를 해결하고자 합니다. 기존 self-evolution 모델들은 self-generated 데이터를 학습에 활용하나, 시간이 지날수록 유효하지 않은(invalid) 질문의 비중이 증가하고 유사한 수학적 과제들이 반복되는 문제에 직면합니다. 특히 기존의 lexical similarity 기반 다양성 제어 기법은 질문의 의미적 구조를 충분히 반영하지 못하여 학습 데이터의 다양성을 해칩니다 [Figure 2]. 이러한 현상은 결국 성능의 정체 또는 퇴보를 유발하므로, 질문의 질을 실시간으로 관리하는 새로운 접근 방식이 필요합니다 [Figure 3].
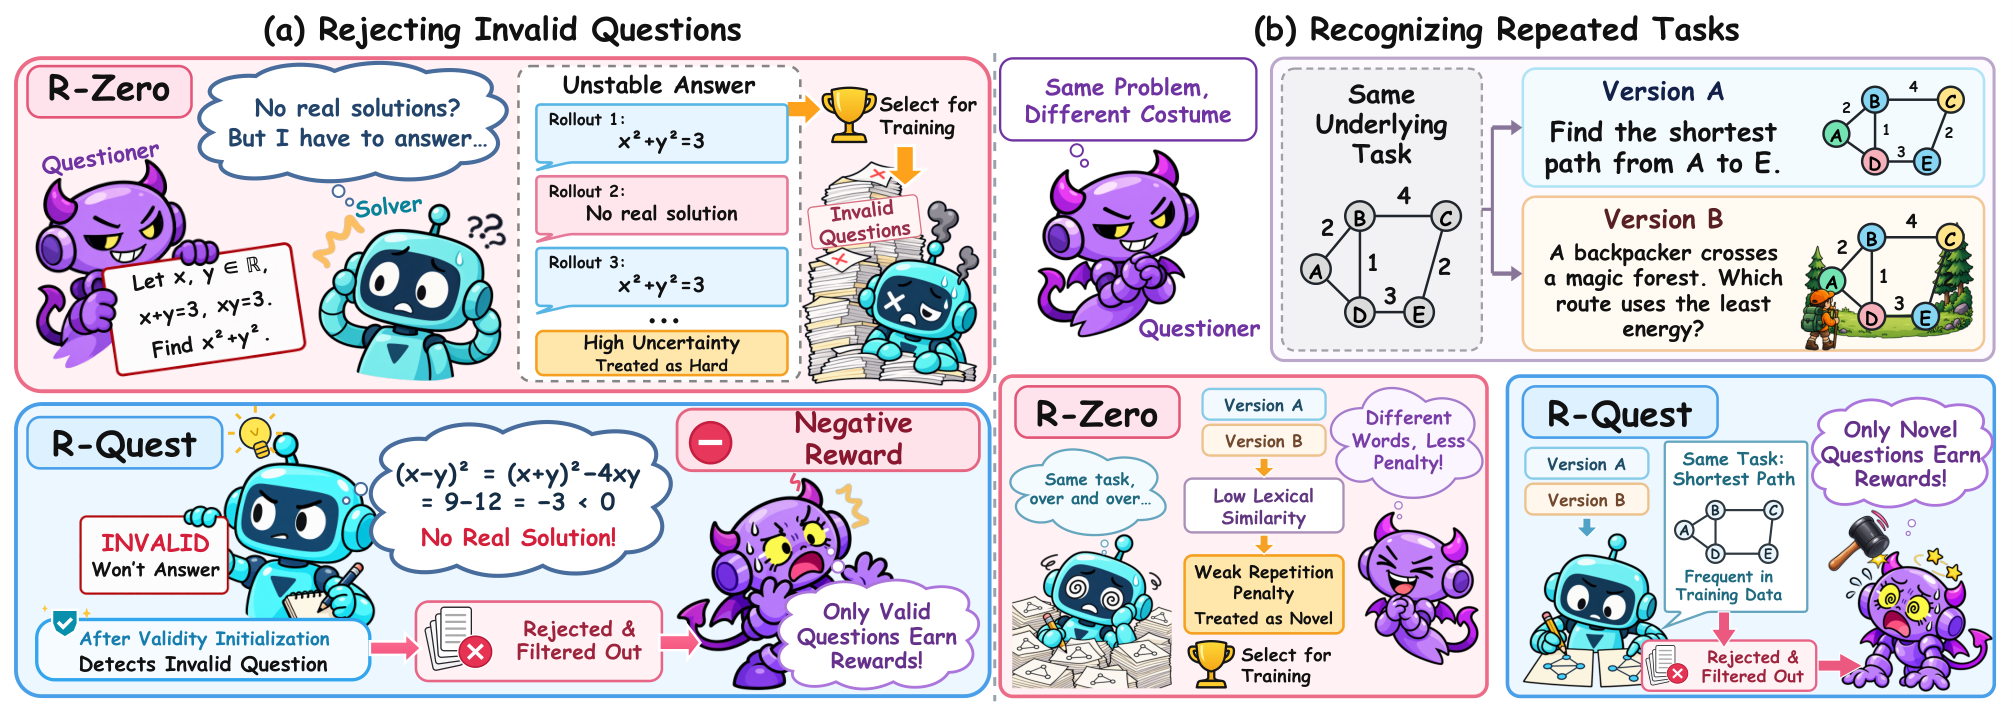
Figure 2 — R-Quest의 문제 해결 방식
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 R-Quest를 도입하여 question validity와 novelty를 기반으로 한 피드백 루프를 구축합니다. 먼저, solver가 유효하지 않은 질문을 인지하고 INVALID를 반환하도록 하는 validity-aware initialization을 선행합니다. 이후, questioner는 학습 도중 validity와 novelty 피드백을 반영하여 보상을 얻으며, 이를 통해 유효하고 새로운 질문만을 생성하도록 유도됩니다 [Figure 2]. 주요 실험 결과, R-Quest는 12개의 벤치마크에서 기존 baseline 대비 우수한 성능을 입증했습니다. 특히 Qwen3-4B-Base 모델 기준, 10라운드의 self-evolution을 거치는 동안 성능 붕괴 없이 최종 라운드에서 peak 성능을 달성하였으며, 이는 기존 R-Zero 대비 17.32 points 높은 수치입니다 [Figure 1]. 또한, 수학적 추론 능력 향상이 코드 생성 및 일반 도메인 추론 성능까지 동반 상승시키는 결과를 보였습니다 [Table 1, Table 2].
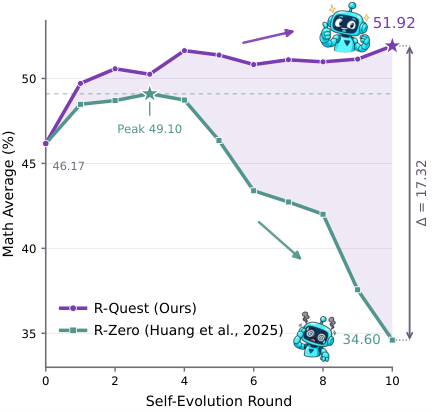
Figure 1 — R-Quest의 성능 추이
4. Conclusion & Impact (결론 및 시사점)
본 연구는 self-evolution 모델의 성능 붕괴 원인이 저품질 질문 데이터의 축적에 있음을 명확히 규명하고, validity 및 novelty feedback을 통해 이를 해결했습니다. R-Quest는 수많은 반복 학습 과정에서도 안정적인 성능 향상을 유지함을 입증함으로써, 인간의 개입을 최소화하면서 모델의 추론 능력을 극대화하는 자가 진화 학습의 실용성을 제고했습니다. 이 연구는 대규모 언어 모델의 지속적 학습 효율성을 극대화하려는 학계와 산업계에 중요한 방법론적 지침을 제공합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Smaller Models are Natural Explorers for Policy-Level Diversity in GRPO
- [논문리뷰] TTCS: Test-Time Curriculum Synthesis for Self-Evolving
- [논문리뷰] Harder Is Better: Boosting Mathematical Reasoning via Difficulty-Aware GRPO and Multi-Aspect Question Reformulation
- [논문리뷰] Reasoning-Aware GRPO using Process Mining
- [논문리뷰] Don't Waste Mistakes: Leveraging Negative RL-Groups via Confidence Reweighting
Review 의 다른글
- 이전글 [논문리뷰] QuadTok: Quadtree Visual Tokenizer for Autoregressive Image Generation
- 현재글 : [논문리뷰] Questioning the Questions: Sustaining Self-Evolution in Reasoning Models
- 다음글 [논문리뷰] ReSAIL: Mitigating Collapse in Iterative Agent Self-Distillation
댓글