[논문리뷰] UniSkill: Learning Actor-Aligned Skill Proposals for an Evolving Policy
링크: 논문 PDF로 바로 열기
메타데이터
저자: Yifei Lu, Cheng Liu, Dianzhi Yu, Hui Xiang, Ji Zhang, Yuanchu Xiao, Rong Liang
1. Key Terms & Definitions (핵심 용어 및 정의)
- Actor-Aligned Skill Proposals: 현재의 Actor 정책이 특정 기술(Skill)을 사용했을 때 성능이 얼마나 향상되는지를 기준으로 제안된 기술 편집(Add, Update, No Edit)을 의미합니다.
- Contrastive Action Feedback: 별도의 추가적인 환경 Rollout 없이, 기존에 수집된 성공 및 실패 궤적(Trajectory)을 사용하여 제안된 기술이 현재 Actor의 행동 Log-Likelihood 분포에 미치는 영향을 측정하는 평가 신호입니다.
- Skill-Edit Support Regularization: Skill Proposal 학습 시, 특정 기술 편집 연산이 과도하게 억제되는 것을 방지하여 탐색(Exploration) 가능성을 유지하는 정규화 기법입니다.
- GRPO (Group Relative Policy Optimization): 환경 보상(Reward)을 기반으로 궤적 그룹 내에서 상대적인 이점(Advantage)을 계산하여 정책을 업데이트하는 최적화 프레임워크입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 LLM 기반 에이전트의 정책과 기술 은행(Skillbank)이 공동으로 진화(Co-evolution)할 때 발생하는 효율성 및 평가 문제를 해결하고자 합니다. 기존 연구들은 기술을 제안한 뒤 실제 환경에서 성능을 평가하기 위해 다수의 추가적인 Rollout을 수행해야 하므로 비용이 높다는 한계가 있습니다. 또한, 학습 중인 Actor가 계속 업데이트되면서 기술의 가치가 변화하기 때문에, 과거의 성공 사례가 현재의 Actor에게도 여전히 유효한지 판단하기 어렵다는 문제가 있습니다. 이를 해결하기 위해 저자들은 별도의 추가적인 궤적 수집 없이도 학습된 Actor의 정렬(Alignment) 정도를 측정할 수 있는 새로운 접근 방식을 제안합니다 [Figure 2].
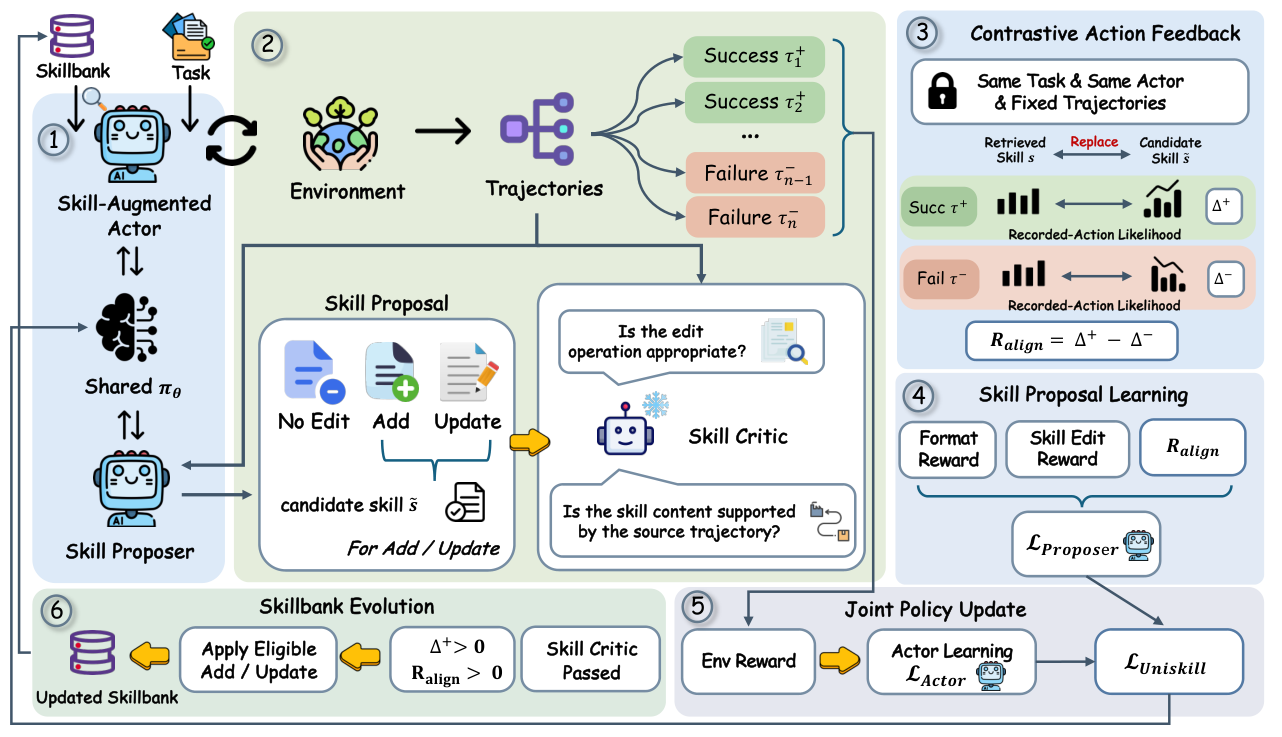
Figure 2 — UniSkill 프레임워크 개요
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 UniSkill이라 명명된 공유 정책(Shared-policy) 프레임워크를 제안하며, 이는 동일한 정책을 Actor와 Skill Proposer로 동시에 활용합니다. 제안된 방법론의 핵심은 Contrastive Action Feedback으로, 이미 수집된 성공 및 실패 궤적에서 기술(Skill)을 교체했을 때 발생하는 행동 Log-Likelihood의 차이를 계산하여 Actor Alignment를 평가합니다 [Figure 2]. 학습 과정에서 Skill-Edit Support Regularization을 도입하여 특정 편집 연산이 무시되는 것을 방지하고 지속적인 기술 탐색을 보장합니다. 실험 결과, UniSkill은 ALFWorld 벤치마크에서 98.4%, WebShop에서 84.7%의 높은 성공률을 기록하였습니다 [Table 1]. 특히, 기존의 Evolving-RL 방법론이 겪었던 후반부 성능 붕괴 현상 없이 안정적인 학습 곡선을 유지하며 성능이 지속적으로 향상되는 결과를 보여주었습니다 [Figure 1].
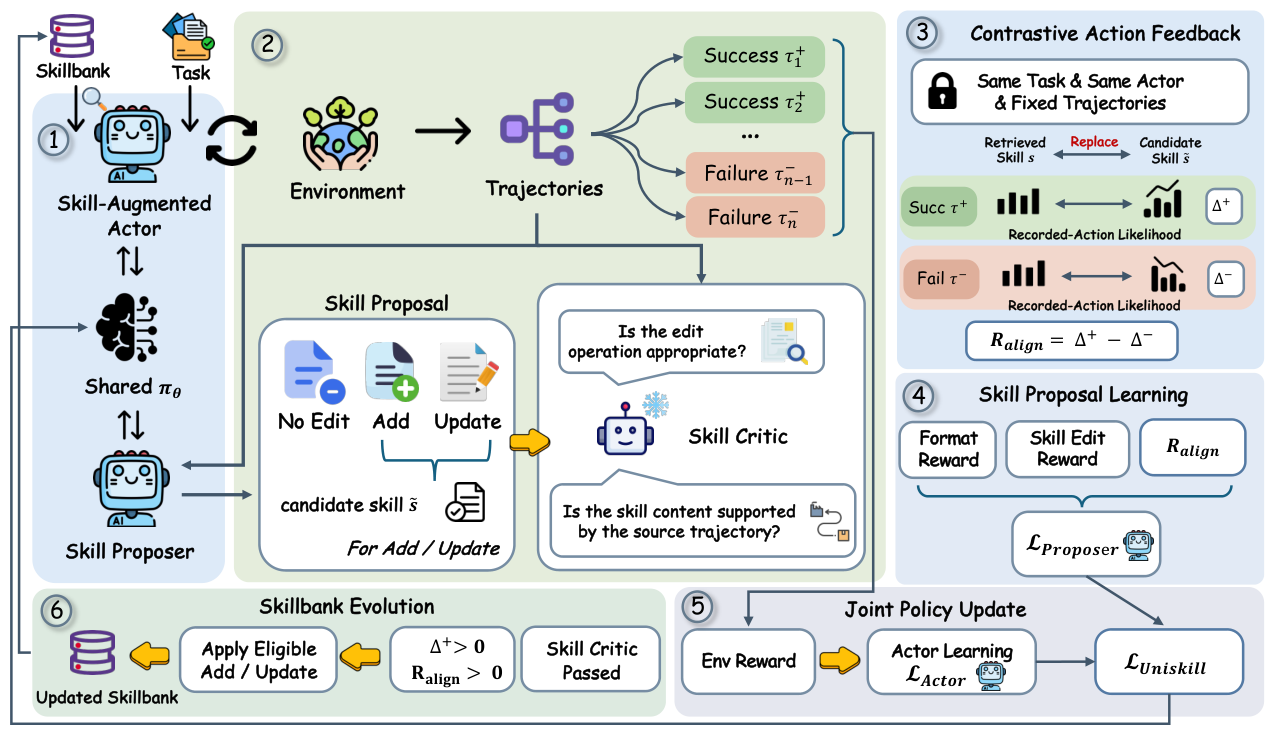
Figure 1 — UniSkill 전체 아키텍처
4. Conclusion & Impact (결론 및 시사점)
본 논문은 기술 제안(Skill Proposal)과 Actor 학습을 효율적으로 결합하여 정책과 기술 은행의 안정적인 공동 진화를 달성하는 UniSkill을 제안하였습니다. 제안된 Contrastive Action Feedback은 추가적인 환경 상호작용 없이도 효율적인 평가를 가능하게 하여 LLM 에이전트의 훈련 비용을 획기적으로 낮추었습니다. 이 연구는 모델 크기가 작은 백본에서도 강력한 성능을 발휘함을 입증하며, 향후 복잡한 상호작용 환경에서 자가 진화하는 에이전트 설계의 핵심 프레임워크로 활용될 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] AutoSFT: An Agentic System for Automated Data Research in Supervised Fine-Tuning
- [논문리뷰] τ-Emotion-Bench: Exposing the Interaction Fragility of LLM Agents through Real-World User Emotions
- [논문리뷰] Tev: Scaling Long-Horizon Agentic Environments with Dense Progress Rewards
- [논문리뷰] Harness^2: Recursive Agent Harnessing for an Open World
- [논문리뷰] A Decade in a Day: Synthesizing Agent-Native Interfaces from Human-Oriented Software Evolution
Review 의 다른글
- 이전글 [논문리뷰] UltraText Bench: A Comprehensive Bilingual Benchmark for Evaluating Visual Text Rendering in Image Generation
- 현재글 : [논문리뷰] UniSkill: Learning Actor-Aligned Skill Proposals for an Evolving Policy
- 다음글 [논문리뷰] UniWAM: Unified World-Action Model
댓글