[논문리뷰] From Prompting to Composing: A Spatial Canvas Interface for Poster Generation
링크: 논문 PDF로 바로 열기
메타데이터
저자: Yitong Wang, Fangyun Wei, Jinjing Zhao, Sirui Zhang, Hongyang Zhang, Dong Chen, Bo Dai, Yan Lu
1. Key Terms & Definitions (핵심 용어 및 정의)
- Spatial Canvas Interface: 사용자가 포스터의 구성 요소를 2차원 공간 상에 배치하고 binding 조건을 직접 지정할 수 있게 해주는 인터페이스입니다.
- Binding Types: Semantic, Identity, Text, Pixel 네 가지 방식으로 구성되어, 각 영역에 대한 생성 제어 및 visual element 유지 보존을 수행합니다.
- Text Specifications: 각 element에 대한 세부 지시 사항과 포스터의 전반적인 스타일 및 배경 정보를 담은 텍스트 기반의 명세입니다.
- Compo: pretrained image editing model을 기반으로 Spatial Canvas 입력을 이해하도록 학습된 poster generation 모델입니다.
- Agentic Mode: 사용자의 고수준 자연어 요청을 분석하여 자동으로 Spatial Canvas와 Text Specifications로 변환하는 생성 모드입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 현대의 generative model들이 텍스트 프롬프트라는 1차원적 인터페이스에 의존함에 따라 복잡한 2차원 구성이 필요한 포스터 제작에 한계가 있다는 문제 의식에서 출발한다. 기존의 text-only 방식은 포스터의 요소 위치, 시각적 정체성 보존, 텍스트 렌더링 등의 공간적 제약을 명확하게 표현하기 어렵다는 단점이 있다. 따라서 저자들은 사용자가 포스터의 의도를 2차원 공간 상에 직접 구성(composing)할 수 있는 새로운 Spatial Canvas Interface를 제안한다 [Figure 1]. 이러한 접근 방식은 명시적인 spatial 구조와 텍스트 명세를 결합하여, 기존의 indirect하고 모호한 prompting 방식을 효과적으로 대체하고자 한다.
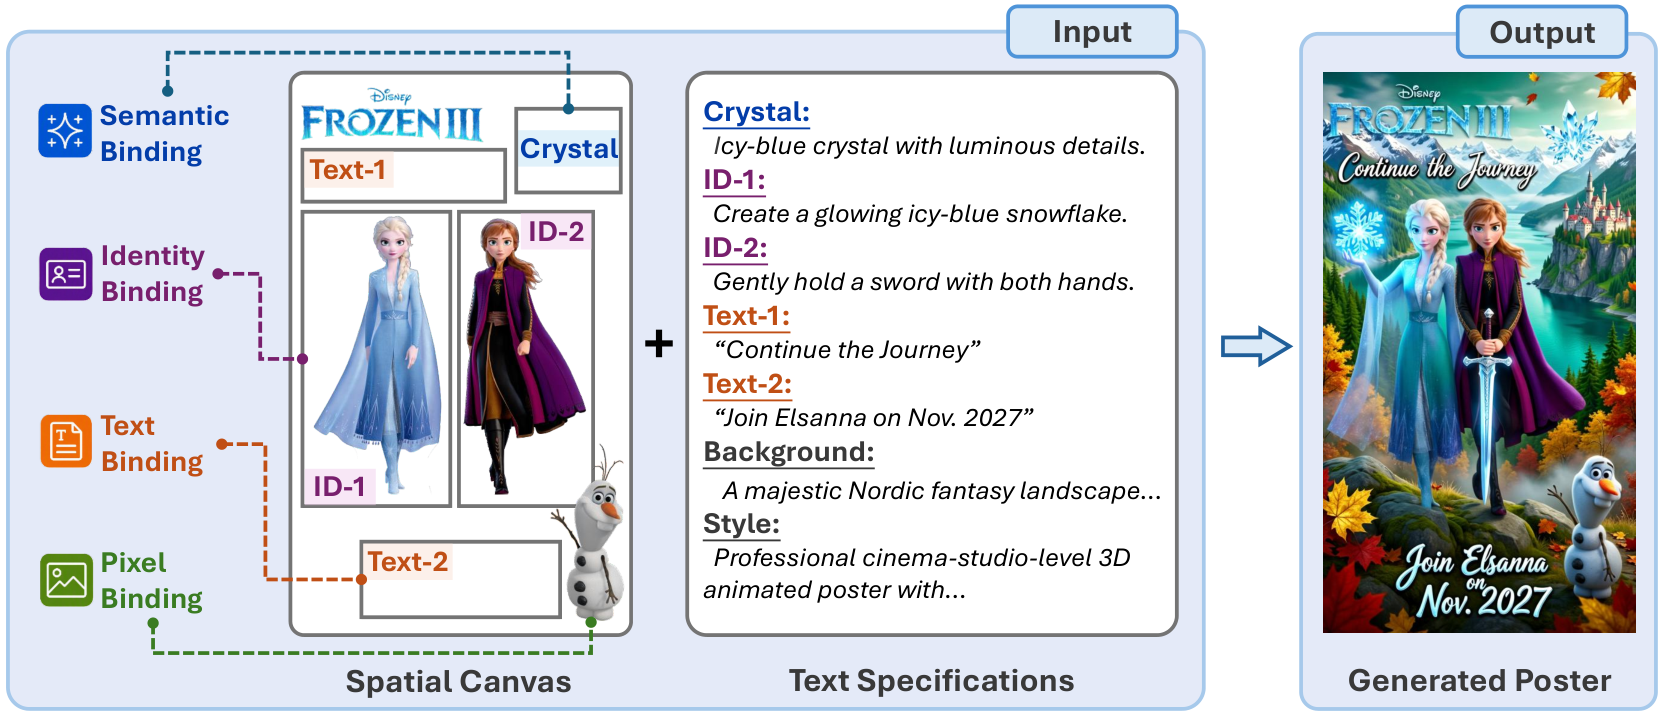
Figure 1 — 공간 캔버스 기반 포스터 생성 개념
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Compo라는 모델을 통해 다양한 바인딩 유형을 해석하고 poster generation을 수행하는 새로운 프레임워크를 제안한다 [Figure 3]. 효율적인 학습을 위해 저자들은 GPT-5.5와 다양한 이미지 모델을 활용하여 200K 규모의 자동화된 학습 데이터셋(Compo-200K) 구축 파이프라인을 개발했다 [Figure 2]. 모델은 pretrained MMDiT를 기반으로 LoRA를 통해 파라미터를 최적화하며, text accuracy, instance similarity, layout adherence를 보상으로 하는 DiffusionNFT 기반의 강화학습(RL)을 통해 바인딩 충실도를 극대화했다. 또한, 사용자는 Agentic Mode를 통해 고수준의 요구사항만으로 복잡한 포스터 레이아웃을 자동 생성할 수 있다 [Figure 4]. 실험 결과, Compo는 일반적인 image generation 모델 및 기존의 포스터 생성 시스템 대비 Semantic Binding, Identity Binding, Text Binding 등의 모든 지표에서 압도적인 compositional controllability를 입증했다 [Table 1]. 특히, Compo-LongCat 및 Compo-Qwen 모델은 기존 baseline 대비 높은 visual quality를 유지하면서도 텍스트 렌더링의 NED(normalized edit distance)와 Sen. Acc.에서 월등한 성능 향상을 보였다.
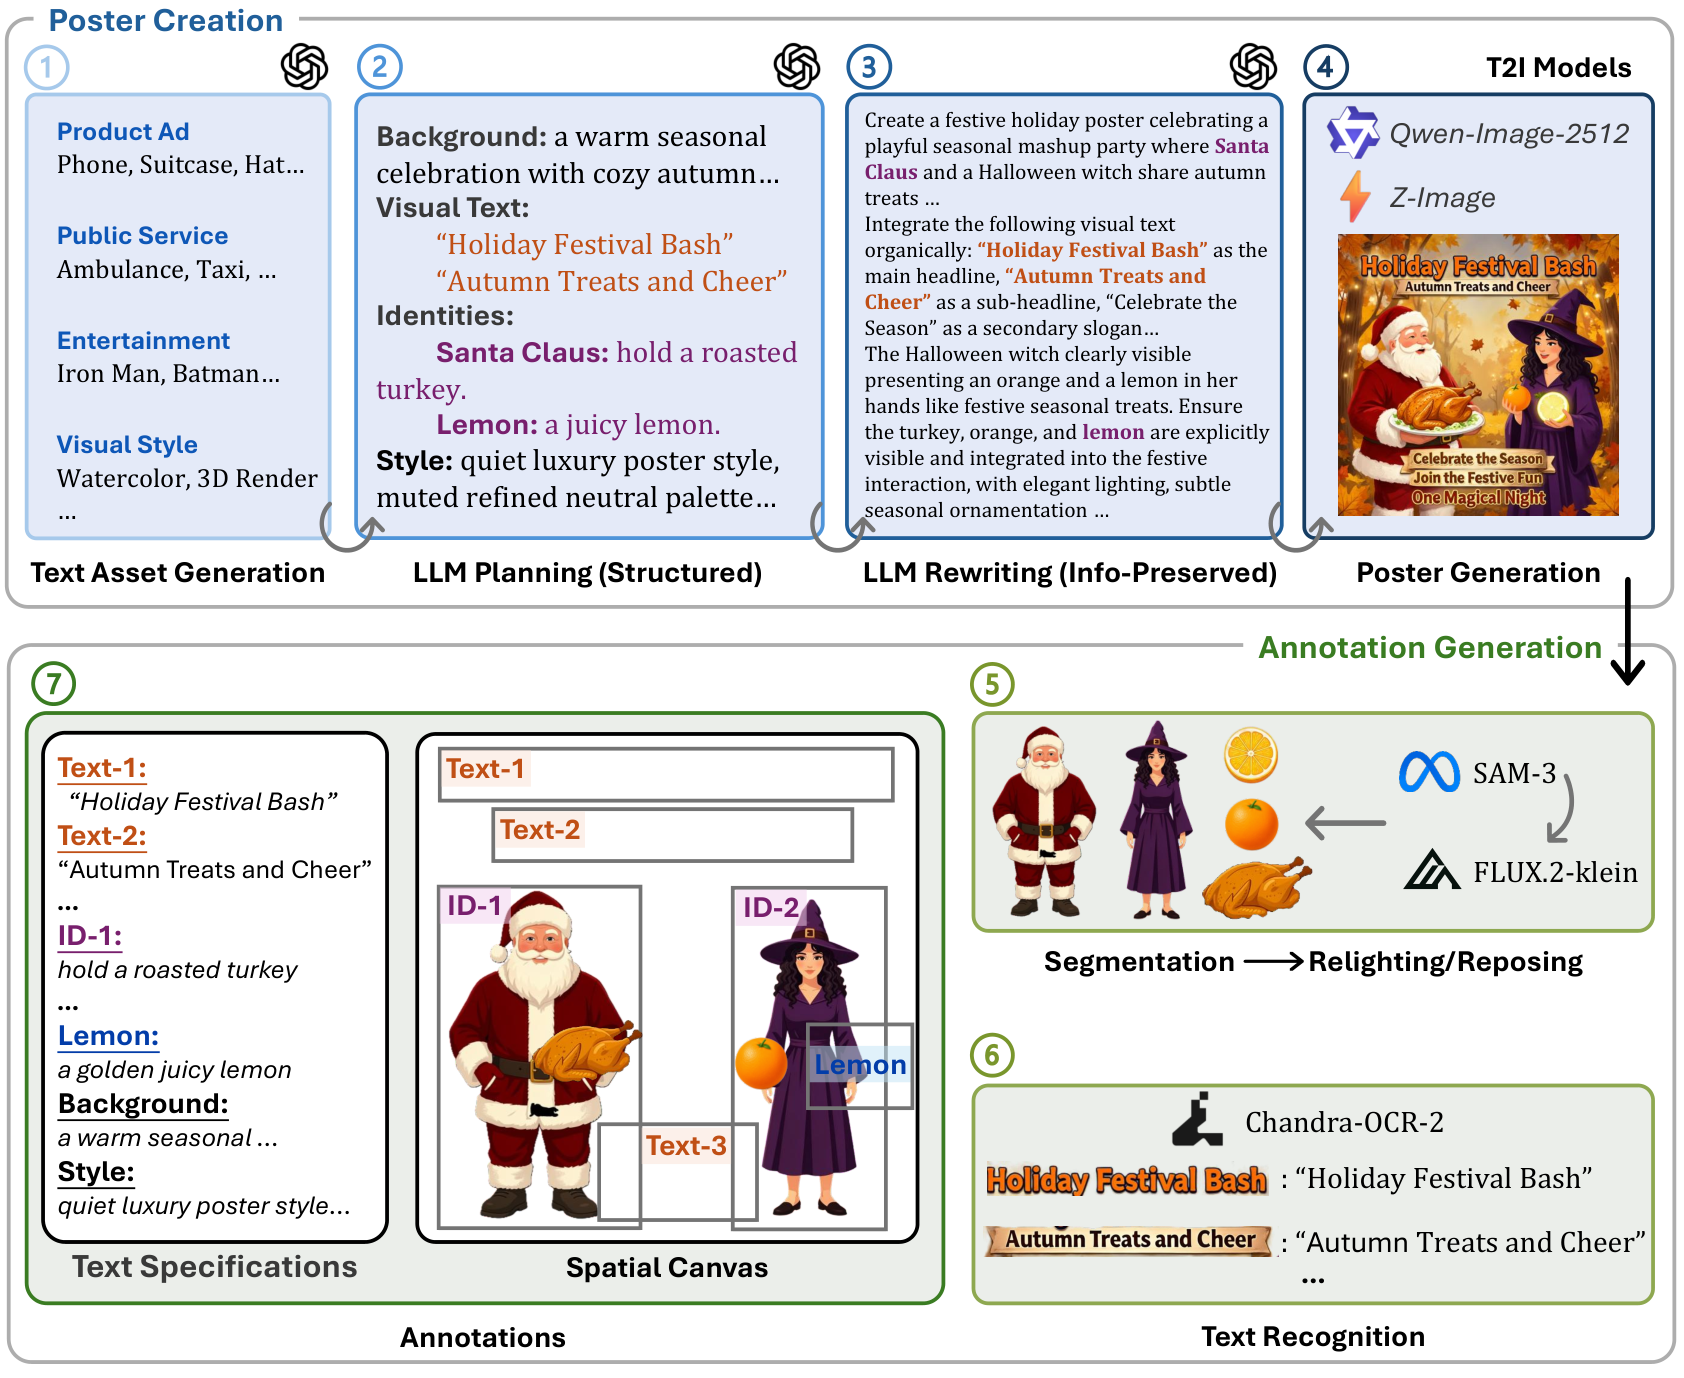
Figure 2 — 자동 학습 데이터 구축 파이프라인
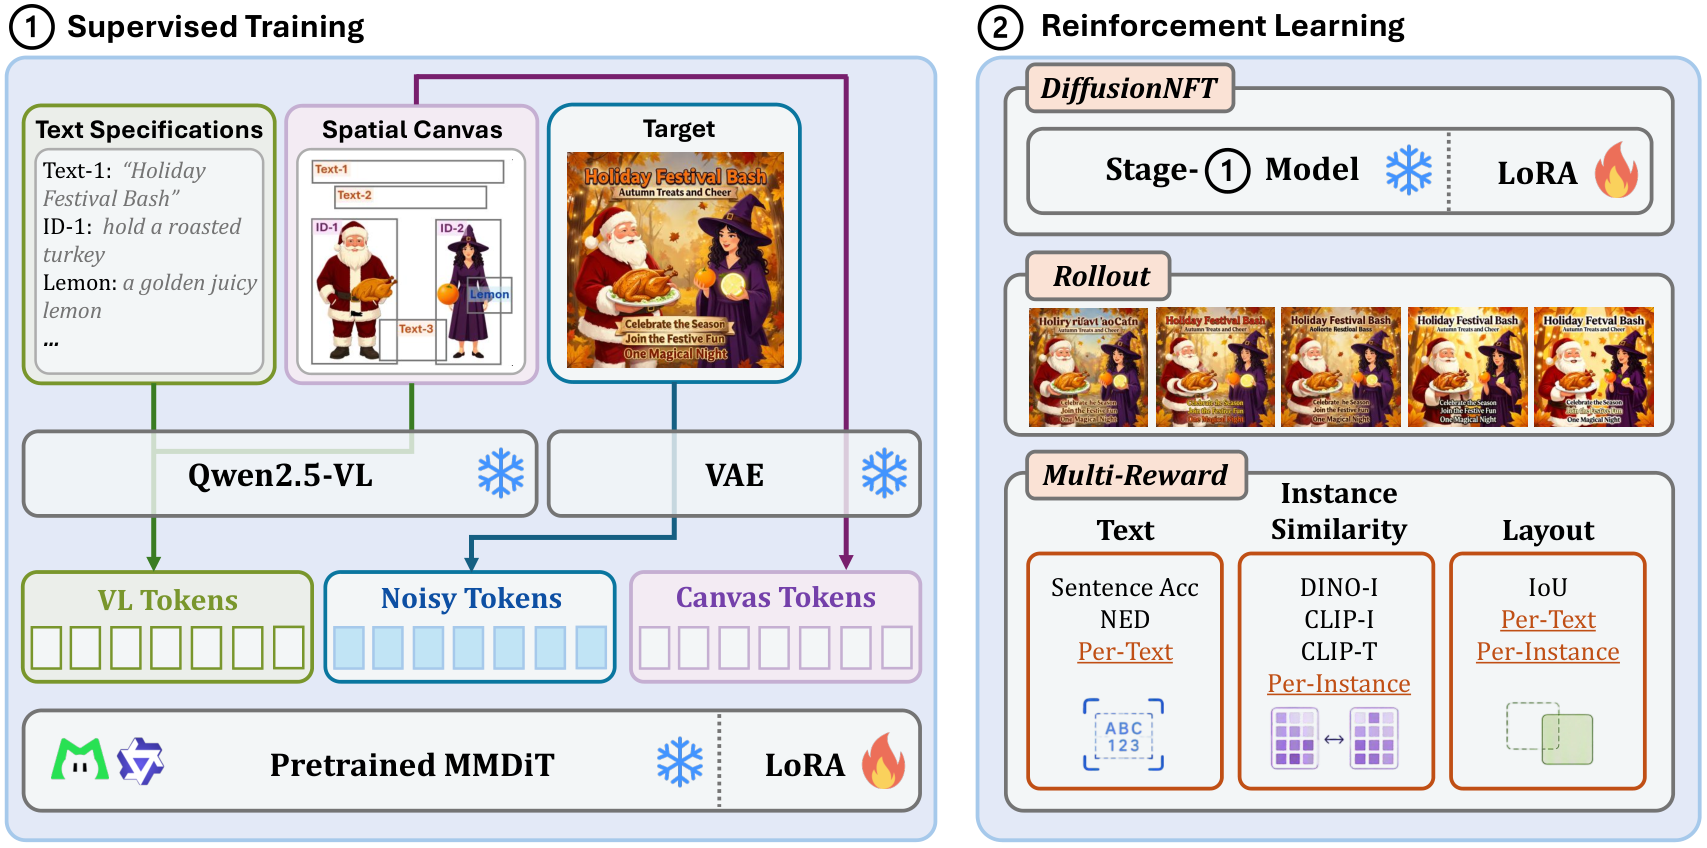
Figure 3 — Compo 모델 아키텍처 및 학습 단계
4. Conclusion & Impact (결론 및 시사점)
본 연구는 poster generation의 패러다임을 단순 텍스트 프롬프팅에서 구체적인 공간 구성 방식으로 전환하는 Spatial Canvas Interface를 제시한다. Compo는 제안된 인터페이스를 통해 복잡한 시각적/공간적 제약을 효과적으로 학습하며, 자동화된 데이터 파이프라인을 통해 모델의 확장성을 높였다. 본 연구의 결과물은 전문적인 디자인 툴 없이도 고품질의 구조적 포스터를 생성할 수 있게 함으로써 콘텐츠 생성 분야에 큰 기술적 진보를 제공한다. 향후 연구는 더욱 다양한 도메인의 디자인 요소들을 포용하고, 대화형 생성 인터페이스와의 통합을 통한 생성 효율 극대화에 기여할 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] GRACE: Generation-aware latent compression for efficient video generation
- [논문리뷰] Prism: Dynamic Sparse Attention for Native 2K Joint Video-Audio Generation Model Training
- [논문리뷰] PixelDense: Dense Prediction as Representation Alignment for Pixel Diffusion
- [논문리뷰] Diffusion Reward Models
- [논문리뷰] UltraTex: Unleashing 2K Multi-View Diffusion for 3D Texturing
Review 의 다른글
- 이전글 [논문리뷰] Foundations of Large Language Models
- 현재글 : [논문리뷰] From Prompting to Composing: A Spatial Canvas Interface for Poster Generation
- 다음글 [논문리뷰] From Traces to Agentic Worlds: Agentic Language World Models for Interactive Environment Simulation
댓글