[논문리뷰] In-context Robot Learning Made Simple: A Democratized Recipe for Manipulation Tasks
링크: 논문 PDF로 바로 열기
메타데이터
저자: Minxing Li, Minghao Han, Weizhi Zhao, Hanwen Wang, Xiangshuo Liu, Shuyao Shang, Jingxiang Zhou, Mingchao Sun, Hongyu Pan, Mu Xu, Yu Liu, Lue Fan, Zhaoxiang Zhang
1. Key Terms & Definitions (핵심 용어 및 정의)
- Robot ICL: 로봇이 시각적 시연(Visual Demonstration)을 프롬프트로 활용하여 새로운 작업을 추론하고 실행하는 학습 패러다임.
- Prompt Ambiguity: 시각적 시연에 포함된 너무 많은 정보(행동, 객체, 공간 정보 등)로 인해 모델이 무엇을 따라야 하고 무엇을 무시해야 할지 모호해지는 문제.
- Semantic-discriminative Data: 작업 의도(Action, Object, Composition, Affordance 등)를 명확히 구분하도록 설계된 데이터로, 모델이 불필요한 상관관계를 제거하도록 유도함.
- SimpleICL: 시각적 프롬프트 인코더와 저비용 데이터 수집 프로토콜을 결합하여 최소한의 자원으로 효과적인 로봇 ICL을 구현한 제안 프레임워크.
- Cross-group Pairing (CP): 서로 다른 환경 설정 간에 데이터를 페어링하여 모델이 공간적 변위나 환경 변화에 강건(Robust)하도록 만드는 데이터 증강 전략.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 로봇 In-context Learning (ICL)에서 시연 영상이 너무 많은 정보를 담고 있어 발생하는 Prompt Ambiguity 문제를 해결하고자 한다. 기존의 로봇 학습 방식은 특정 작업에 최적화된 Fine-tuning에 의존하거나, 시연 영상 속의 불필요한 요소(사람의 손 모양, 배경 등)를 그대로 모방하는 경향이 있어 일반화 성능이 낮다는 한계가 있다. 저자들은 로봇이 시연 영상에서 어떤 정보(Semantic Intent)를 추출해야 하고 어떤 정보(Noise)를 무시해야 하는지에 대한 명확한 정의가 결여되어 있음을 지적한다 [Figure 1]. 따라서 본 연구는 이러한 모호함을 해결하고, 효율적인 데이터 설계를 통해 범용적인 로봇 ICL 프레임워크를 구축하는 것을 목표로 한다.
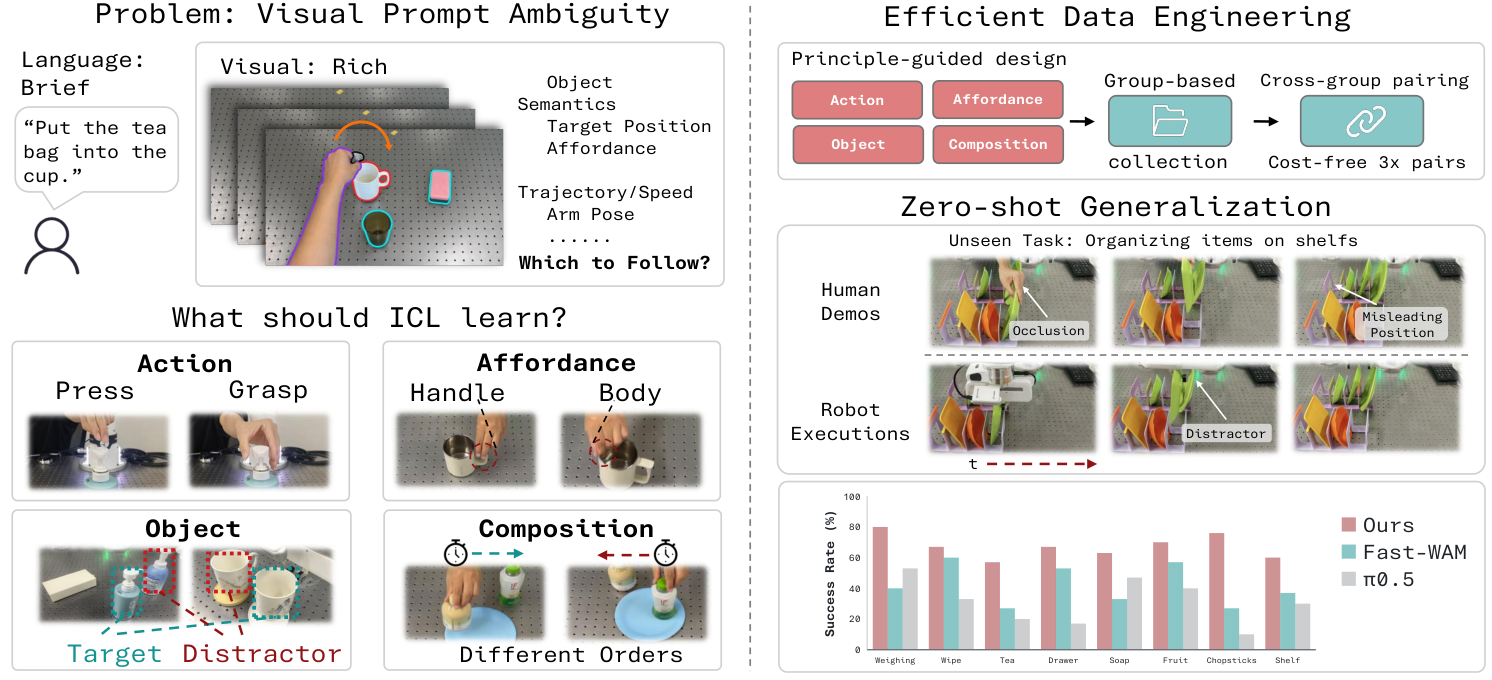
Figure 1 — SimpleICL의 개요 및 프롬프트 모호성 문제
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 SimpleICL 프레임워크를 통해 로봇 ICL의 핵심 의도를 4가지 범주(Action, Object, Composition, Affordance)로 정의하고, 이를 명확히 학습하기 위한 Semantic-discriminative Data 프로토콜을 제안한다 [Figure 2]. 제안 모델은 시각적 프롬프트 인코더를 사용하여 데모 영상에서 태스크 관련 정보를 추출하고, 이를 Action DiT(Diffusion Transformer)의 Context에 통합하여 로봇 제어 명령을 생성한다. 시뮬레이션 환경에서 SimpleICL은 기존 방식 대비 현저히 높은 성공률을 기록했으며, 특히 OOD(Out-of-Distribution) 태스크에서 평균 65.9%의 성공률을 달성하여 Baseline인 Fast-WAM(24.6%)을 크게 상회하였다 [Table 2]. 실제 환경 실험에서도 8개의 보지 못한 작업에 대해 제안 기법이 Hard 레벨 태스크에서 68%의 성공률을 기록하며 뛰어난 일반화 성능과 강건성을 입증하였다 [Table 3]. 아울러 Cross-group pairing 전략을 통해 모델이 공간적 변화와 환경적 노이즈에 대해 높은 강건성을 가짐을 확인하였다 [Figure 7].
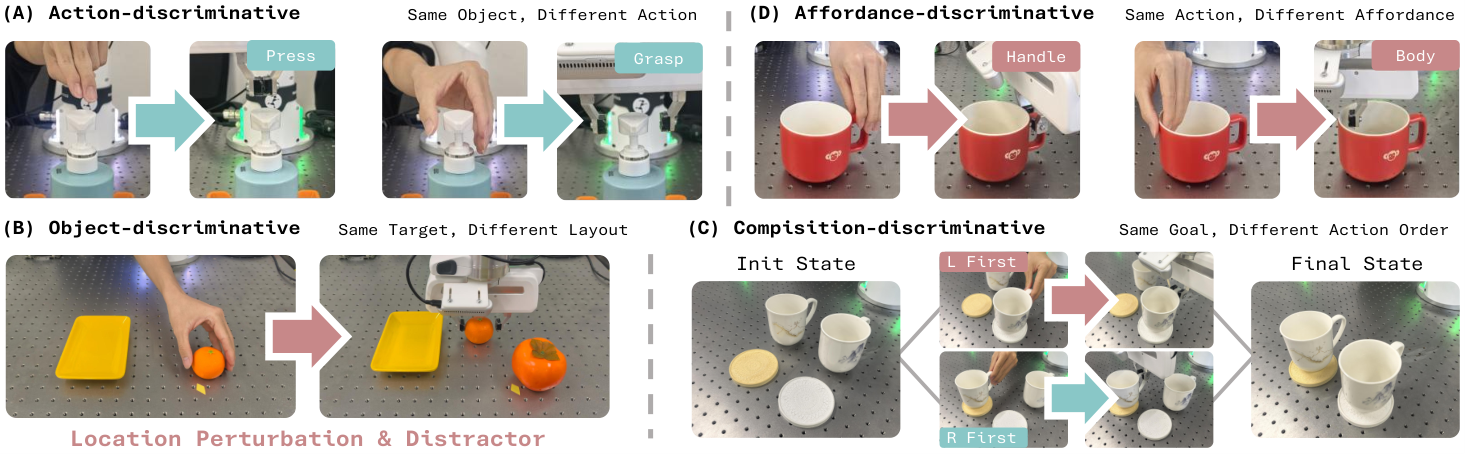
Figure 2 — 의미론적 판별 데이터 구조
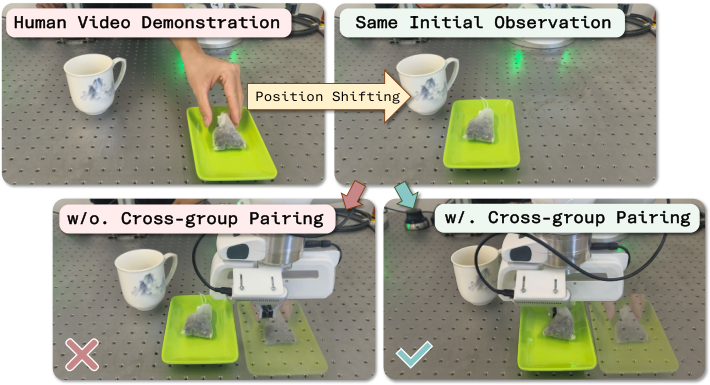
Figure 7 — 그룹 페어링 전략의 효과
4. Conclusion & Impact (결론 및 시사점)
본 논문은 로봇 ICL의 Prompt Ambiguity를 정의하고, 이를 해결하기 위한 미니멀리스트 아키텍처와 데이터 구축 레시피를 성공적으로 제시하였다. 이 연구는 대규모 사전 학습 없이도 로봇이 시각적 시연을 통해 새로운 작업을 학습할 수 있는 실용적 경로를 열었다는 점에서 큰 의미가 있다. 저자들은 데이터와 학습 파이프라인을 오픈소스화하여, 향후 embodied intelligence 분야의 연구자들이 저비용으로 고효율의 로봇 ICL 시스템을 연구할 수 있는 기반을 마련하였다. 결과적으로 본 연구는 로봇 학습의 민주화(Democratization)와 범용 로봇 도입 가속화에 기여할 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] VLA-Δ: Learning Physical State Transition for Vision-Language-Action Models
- [논문리뷰] PolyOCR-Venus: Unified OCR Foundation Models for Text-Centric Visual Intelligence
- [논문리뷰] SpaceCast-Bench: Evaluating Predictive Spatial Reasoning in Vision-Language Models
- [논문리뷰] VidaForge: Open Research Infrastructure for Video Pretraining Data Recipes
- [논문리뷰] From Seeing to Acting: Smart Glasses as First-Person Intelligence Platforms
Review 의 다른글
- 이전글 [논문리뷰] Frozen Models, Evolving Expertise: Model-Agnostic Learning from Deployment Experience for Multimodal Medical AI
- 현재글 : [논문리뷰] In-context Robot Learning Made Simple: A Democratized Recipe for Manipulation Tasks
- 다음글 [논문리뷰] Incremental Open-Ended Deep Research with Structured Harness
댓글