[논문리뷰] TokenRouter: Efficient Serving System for Token-Level LLM Routing
링크: 논문 PDF로 바로 열기
메타데이터
저자: Tianyu Fu, Tengxuan Liu, Ruoxi Wang, Yixin Dong, Yi Ge, Yichen You, Yu Wang
1. Key Terms & Definitions (핵심 용어 및 정의)
- Token-Level Routing: 전체 요청(Request) 단위가 아닌 개별 토큰 단위로 서로 다른 LLM을 동적으로 선택하여 추론하는 기법입니다.
- Request-Centric Programming: 개발자가 개별 요청의 흐름에 집중하여 라우팅 알고리즘을 기술할 수 있도록 하는 추상화 인터페이스입니다.
- Model-Centric Execution: 분산된 각 LLM이 독립적인
subserver에서 비동기적으로 실행되는 런타임 모델입니다. - Delayed-Batching: 처리량 향상을 위해 요청을 즉시 처리하지 않고 임계치(
B)만큼 버퍼링하여 배치 단위로 실행하는 스케줄링 기법입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Token-Level Routing이 도입하는 복잡한 시스템적 난제를 해결하기 위해 TokenRouter를 제안합니다. 기존의 LLM Serving 시스템들은 단일 모델 실행을 가정하여 설계되었기 때문에, 토큰 단위의 빈번한 모델 전환 시 발생하는 Step Desynchronization(모델 간 단계 불일치)과 Batch Admission Delay(배치 진입 지연)를 효율적으로 처리하지 못합니다 [Figure 2]. 또한, 개발자가 이러한 라우팅 로직을 기존 시스템에 구현하려면 복잡한 코드 수정이 필요하다는 한계가 존재합니다. 따라서 라우팅 알고리즘과 시스템 최적화를 분리하고, 높은 효율성을 보장하는 새로운 프레임워크가 필수적입니다.
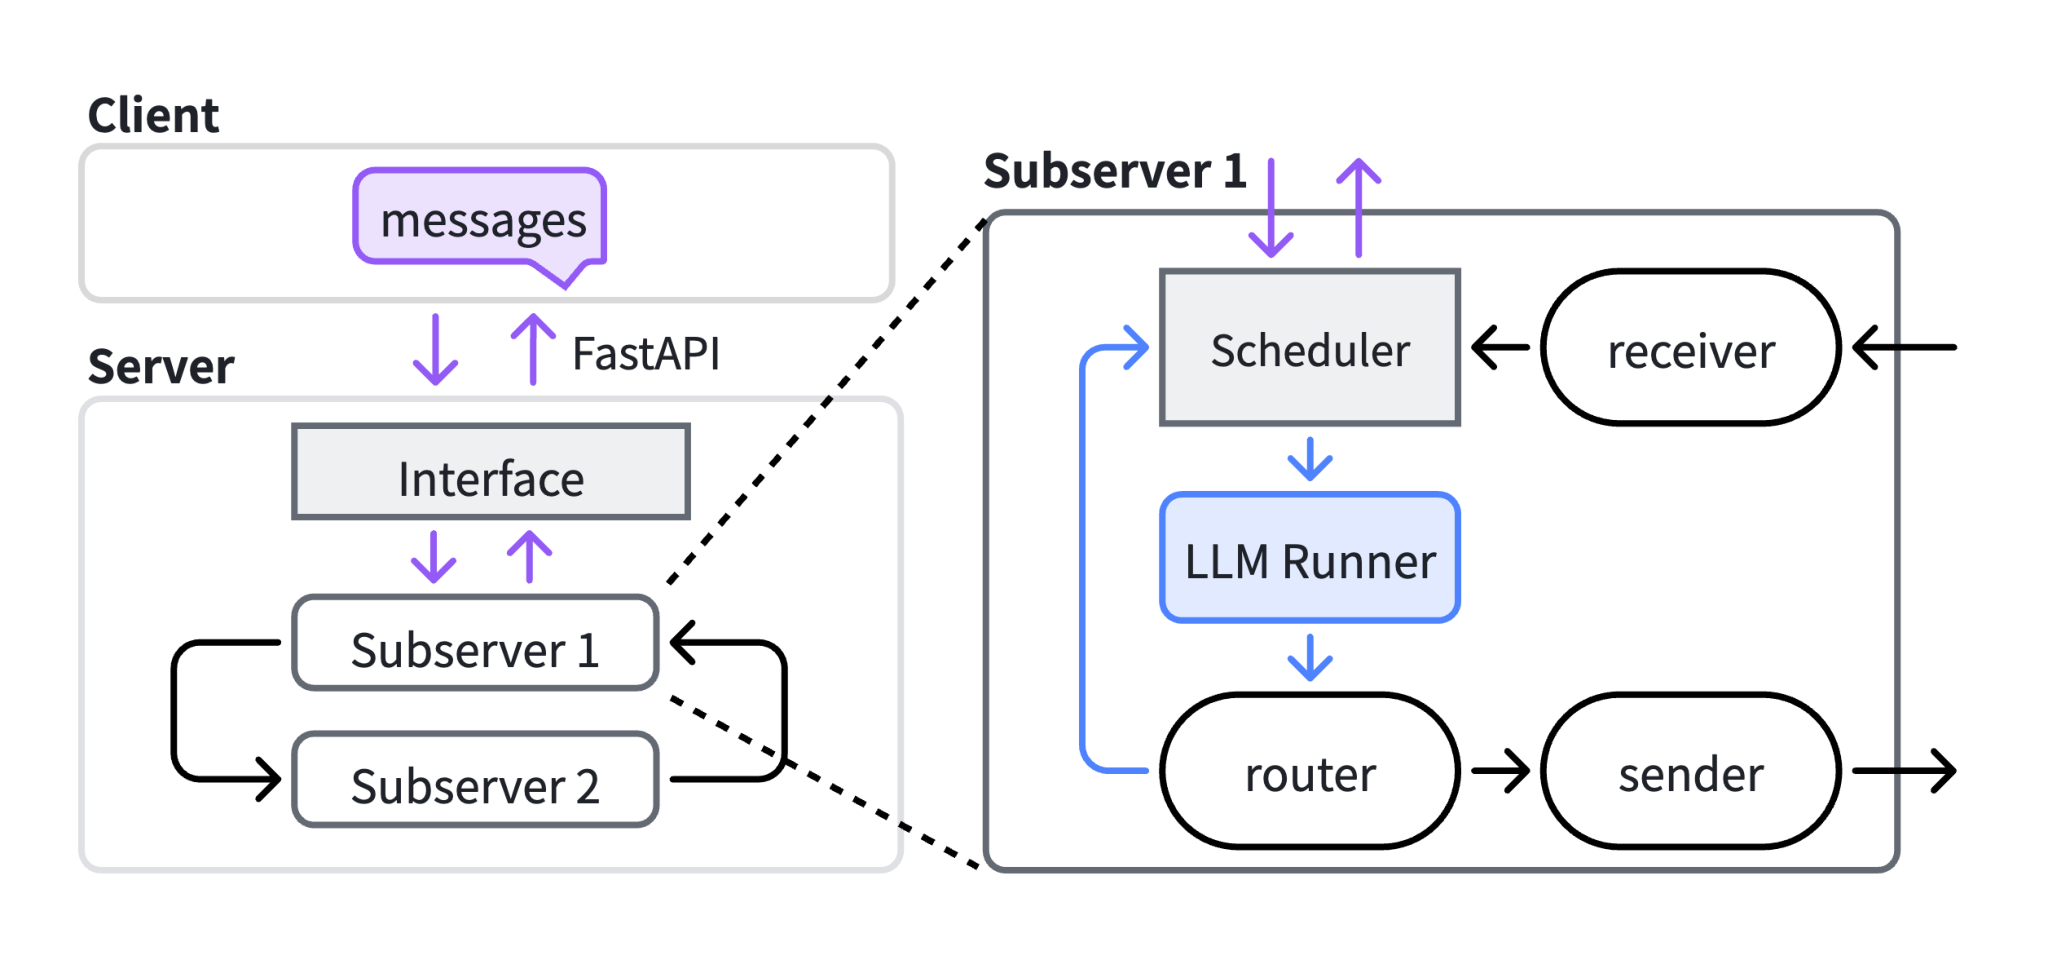
Figure 2 — TokenRouter 아키텍처
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Request-Centric Programming 인터페이스와 Model-Centric 비동기 런타임을 결합한 TokenRouter를 핵심 방법론으로 제안합니다. 개발자는 route, send, receive라는 세 가지 컴포넌트만 정의하면 되며, 시스템은 세 개의 디커플링된 루프(Client-Server, Decoding, Inter-model)를 통해 비동기 실행을 수행합니다 [Figure 2]. 특히, Delayed-Batching 스케줄러를 통해 배치 진입 지연을 최적화하며, 이때 필요한 최적의 B값은 시스템 Throughput을 최대화하는 수학적 모델을 통해 유도됩니다 [Figure 4]. 실험 결과, TokenRouter는 다양한 라우팅 알고리즘 및 워크로드 환경에서 기존 방식 대비 2.01~64.15배 더 높은 Decoding Throughput을 달성하였습니다 [Table 2]. 또한, Throughput과 Latency 간의 최적의 Pareto Frontier를 확장하며 실제 서비스 환경에서의 우수성을 입증했습니다 [Figure 1, Figure 7].
4. Conclusion & Impact (결론 및 시사점)
본 연구는 Token-Level LLM Routing의 이론적 효율성을 실질적인 시스템 성능 향상으로 전환한 TokenRouter를 제시하며 학계와 산업계에 기여합니다. 라우팅 로직과 시스템 실행을 완전히 분리함으로써 개발 편의성을 극대화하고, 비동기 실행과 수학적으로 최적화된 스케줄링을 통해 Serving Efficiency를 비약적으로 개선했습니다. 이 연구는 복잡한 다중 모델 협력(Multi-model collaboration) 기반의 추론 시스템이 실제 배포 환경에서 운영될 수 있는 견고한 기술적 기반을 제공합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Contextual Correction of Parallel Draftsfor Speculative Decoding
- [논문리뷰] Long-WAM: Scaling the Context of World-Action Models
- [논문리뷰] SlimWise: Decoupling Expert Pruning Across Prefill and Decode for Efficient MoE Serving
- [논문리뷰] SiliconBench: Speed, Memory, and Fidelity for LLM Serving on Unified-Memory Desktops
- [논문리뷰] FlashPrefill V2: Block-Sparse Prefill Attention for Long-Context LLM Serving
Review 의 다른글
- 이전글 [논문리뷰] TestPrism: Rethinking Test Evaluation Beyond a Single Reference
- 현재글 : [논문리뷰] TokenRouter: Efficient Serving System for Token-Level LLM Routing
- 다음글 [논문리뷰] U-Space: Uncovering When and Why Uncertainty Arises in Language Models
댓글