[논문리뷰] V-CoLA: Vision Token Compression with Linear Attention
링크: 논문 PDF로 바로 열기
메타데이터
저자: Hao Jiang, Yiru Mao, Tianpeng Bu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Linear Attention: Quadratic complexity를 가진 표준 softmax attention의 대안으로, recurrent state를 사용하여 과거 정보를 고정된 크기의 메모리로 압축하여 처리하는 기법입니다.
- Hybrid Architectures: Qwen3.5와 같이 softmax attention과 Linear Attention을 결합하여 긴 컨텍스트 처리에 최적화된 모델 구조입니다.
- V-CoLA: Linear Attention 구조를 사용하는 하이브리드 VLM을 위해 제안된 training-free vision token 압축 프레임워크입니다.
- Uniqueness-aware Importance: 토큰의 장기적 기여도와 단기적 독창성(uniqueness)을 동시에 고려하여 압축 시 보존할 중요 토큰을 결정하는 지표입니다.
- Adaptive Chunk-wise Token Merging: 토큰의 중요도 밀도에 따라 동적으로 chunk를 분할하고 각 chunk 내에서 토큰을 병합하여 정보 손실을 최소화하는 압축 전략입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Linear Attention이 포함된 하이브리드 VLM 구조에서 기존의 vision token 압축 기법들이 구조적 차이로 인해 실패한다는 점을 해결하고자 합니다 [Figure 1]. 기존 연구들은 주로 softmax attention map에 의존하거나 특정 피처 유사도에 기반하는데, 이는 하이브리드 모델의 recurrent state가 갖는 제한된 정보 수용 능력과 충돌합니다. 저자들은 이러한 하이브리드 구조에서 발생하는 "Information Ceiling" 문제를 이론적으로 증명하며, 기존 방식들이 무작위 샘플링(random baseline)보다 낮은 성능을 보이는 원인을 밝혀냈습니다 [Figure 2, Figure 3]. 따라서 Linear Attention의 특성을 활용하여 정보 보존 효율을 극대화할 수 있는 새로운 압축 프레임워크가 필요합니다.
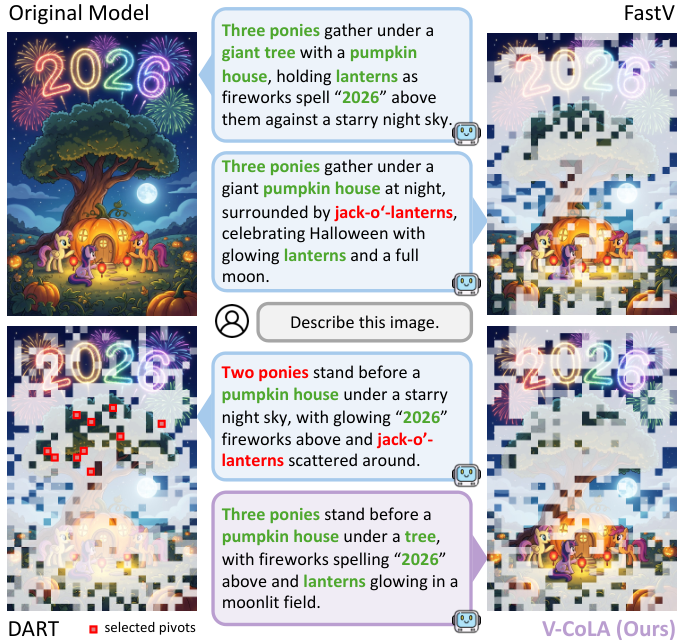
Figure 1 — 기존 압축 기법과 V-CoLA 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Linear Attention의 상태 업데이트(state recurrence) 자체가 내재적인 토큰 중요도 신호를 담고 있다는 점을 포착하여 V-CoLA를 제안합니다 [Figure 5]. 제안된 Uniqueness-aware Importance Criterion은 최종 recurrent state에 대한 reconstruction error와 탐색적 쿼리(probe)를 활용한 상태 변화량을 결합하여 중요 토큰을 식별합니다. 이후, 중요도 밀도에 따라 최적화된 Adaptive Chunk-wise Token Merging을 적용하여 중요한 영역은 세밀하게, 불필요한 영역은 과감하게 병합합니다 [Figure 6]. 또한 깊은 레이어에서 시각적 정보의 기여도가 감소하는 현상을 이용한 Early Exiting 메커니즘을 적용하여 연산 효율성을 높였습니다. 실험 결과, V-CoLA는 Qwen3.5-9B 모델 기준 50%의 토큰만으로도 원본 성능의 99.5%를 유지하며, 12.5% 수준에서도 88.0% 이상의 성능을 보존했습니다 [Table 1]. 또한, 효율적인 병렬 연산 구현을 통해 1.86배에서 6.15배의 prefill 속도 향상을 달성했습니다 [Table 2, Table 3].
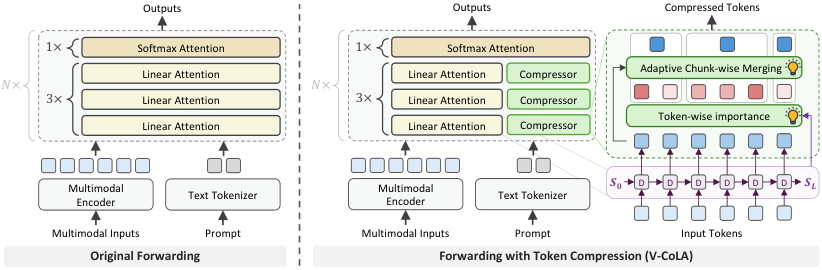
Figure 5 — V-CoLA 프레임워크 개요
4. Conclusion & Impact (결론 및 시사점)
본 연구는 Linear Attention 기반 하이브리드 VLM을 위한 효율적인 vision token 압축 기법인 V-CoLA를 성공적으로 제시했습니다. 이론적 분석을 통해 기존 기법의 한계를 규명하고, 모델의 재귀적 특성을 활용한 새로운 중요도 지표와 적응형 병합 전략을 통해 성능과 효율성을 동시에 확보했습니다. 특히 training-free 방식으로 설계되어 현존하는 다양한 하이브리드 모델에 즉각적으로 적용 가능하다는 점에서 실용적 가치가 높습니다. 본 연구는 대규모 멀티모달 모델의 추론 비용을 획기적으로 낮추어 산업계의 상용화 가속화에 크게 기여할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] HLA: Expressive Hybrid Linear Attention via Chunk-Wise Dynamic Mixing
- [논문리뷰] Video DeltaNet: A Video-Native Hybrid Attention for Livestream Video Generation
- [논문리뷰] Kimi Linear: An Expressive, Efficient Attention Architecture
- [논문리뷰] SANA-Video: Efficient Video Generation with Block Linear Diffusion Transformer
- [논문리뷰] DataVista: Diagnosing Multimodal LLMs on Data Video Understanding
Review 의 다른글
- 이전글 [논문리뷰] USDCraft: Geometrically Grounded Programmatic Modeling of Articulated 3D Assets for Simulation
- 현재글 : [논문리뷰] V-CoLA: Vision Token Compression with Linear Attention
- 다음글 [논문리뷰] ViSkill: Reinforcing VLM Agents with Evolving Visual-Native Skills
댓글