[논문리뷰] DiffusionART: Efficient, Stable and Scalable Reinforcement of Diffusion Models
링크: 논문 PDF로 바로 열기
Part 1: 요약 본문
저자: Zhenglin Wan, Jiayu Chen, Zhengfeiyang Zhang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- DiffusionNFT: Forward-process 기반의 Diffusion RL 기법으로, 샘플의 리워드에 따라 Forward noising된 Velocity target을 회귀 학습하는 방식입니다.
- Forward–Reverse Consistency Force: DiffusionNFT의 학습 목적함수에 내재된 결함으로, Reward-improving guidance와 충돌하여 학습을 불안정하게 만드는 힘입니다.
- Aggregation-First Guidance: 본 논문에서 제안하는 기법으로, 샘플 수준의 리워드 대신 프롬프트 단위로 리워드-엔드포인트 공분산을 통합하여 안내 방향($G(c)$)을 도출하는 방식입니다.
- Drift-Adaptive Restoration: EMA(Exponential Moving Average) 없이도 모델의 학습 과정에서 발생하는 Drift를 제어하기 위해, 두 번의 연속된 업데이트를 통해 복원력을 부여하는 안정화 기법입니다.
- Trust-Region Masking: ODE(Ordinary Differential Equation) Rollout 과정에서 정책이 급격하게 변하는 것을 방지하기 위해 각 상태의 업데이트에 제약을 거는 기법입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 온라인 Diffusion RL에서 발생하는 학습 효율성과 안정성 간의 상충 문제를 해결하고자 합니다. 기존의 Reverse-process 기반 RL은 복잡한 Likelihood 계산으로 인해 효율성이 낮고, Forward-process 방식인 DiffusionNFT는 학습이 빠르지만 EMA와 같은 불안정한 기법에 의존하며 매 태스크마다 하이퍼파라미터 튜닝이 필요하다는 한계가 있습니다. 특히 저자들은 DiffusionNFT의 목적함수에 존재하는 숨겨진 Forward–Reverse Consistency Force가 학습 불안정성의 근본 원인임을 밝혀냅니다 [Figure 2]. 이러한 문제를 해결하기 위해, 별도의 튜닝 없이 안정적이고 효율적인 최적화가 가능한 새로운 접근 방식이 요구됩니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 DiffusionART(Diffusion Reinforcement with Aggregation-First Reward Tilting)를 제안하여 Consistency Force를 구조적으로 제거하고 Drift-Adaptive Restoration을 도입합니다. 먼저, 프롬프트별 샘플의 리워드와 엔드포인트 간의 공분산을 통해 가이드 방향 $G(c)$를 산출하여 모든 상태에 일관된 방향성을 부여함으로써 기존의 샘플별 상쇄 전략을 대체합니다 [Figure 4]. 이후, 두 번의 단계적 업데이트를 수행하는 Two-Update Restoration 방식을 통해 EMA 없이도 학습을 안정화하며, 각 상태의 Drift에 적응하는 보존력을 확보합니다. 실험 결과, HunyuanVideo-13B 환경에서 DiffusionART는 기존 베이스라인 대비 12배 이상의 GPU 효율성을 보였으며, DiffusionNFT와 Flow-GRPO-Fast 대비 각각 28.8%와 53.0% 더 높은 평균 리워드를 달성하였습니다. 또한 이미지-투-비디오 생성 태스크에서도 기존 기법 대비 4.8배 빠른 학습 효율을 입증하였습니다.
4. Conclusion & Impact (결론 및 시사점)
DiffusionART는 기존 Diffusion RL의 고질적인 문제인 학습 불안정성과 튜닝의 복잡성을 효과적으로 극복한 프레임워크입니다. 본 연구는 Diffusion 모델의 Reward Guided Fine-tuning 과정에서 Consistency Force라는 핵심적인 방해 요인을 규명하고, 이를 기하학적 구조 개선을 통해 해결했다는 점에서 학술적 가치가 큽니다. 제안된 방법론은 태스크별 튜닝 요구를 제거함으로써 대규모 모델의 학습 확장성을 크게 향상시켰으며, 향후 고성능 생성 모델의 효율적인 정렬(Alignment) 기술 발전에 중요한 토대를 제공할 것으로 기대됩니다.
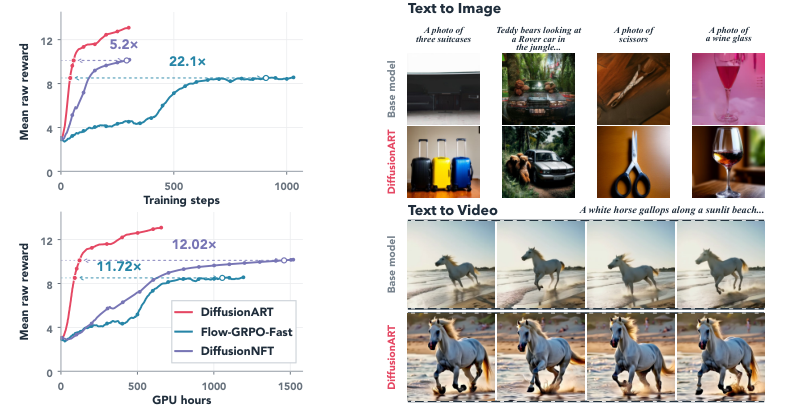
Figure 1 — 학습 효율성 및 결과 비교
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] AV-GRPO: Modality-Anchored Decoupling Diffusion Reinforcement Learning for Joint Audio-Video Generation
- [논문리뷰] TreeGRPO: Tree-Advantage GRPO for Online RL Post-Training of Diffusion Models
- [논문리뷰] SCOPE: Semantic Bounded Credit Optimization for Prompt Engineering in Text-to-image Generation
- [논문리뷰] TPPO: Tracking-Value PPO For Language Model Reasoning
- [논문리뷰] Semifactual Credit-Augmented Policy Optimization
Review 의 다른글
- 이전글 [논문리뷰] DataVista: Diagnosing Multimodal LLMs on Data Video Understanding
- 현재글 : [논문리뷰] DiffusionART: Efficient, Stable and Scalable Reinforcement of Diffusion Models
- 다음글 [논문리뷰] Distributionally Robust Mixture-of-Experts Training
댓글