[논문리뷰] Learning Representations to Guide Pixel Diffusion Transformers
링크: 논문 PDF로 바로 열기
메타데이터
저자: Zihao Pan, Mengting Chen, Cheng Shi, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- pDiTs (Pixel Diffusion Transformers): 외부의 사전 학습된 오토인코더(VAE) 없이, 원본 픽셀 수준에서 직접 확산 및 생성 과정을 수행하는 트랜스포머 아키텍처를 의미합니다.
- Representation Guidance (RG): 저자들이 제안한 방법론으로, 모델 내부의 표현(representation)을 저차원 병목(bottleneck) 구조로 압축하고, 이로부터 도출된 속도 오프셋(velocity offset)을 통해 생성 타겟을 가이드함으로써 학습 효율과 생성 품질을 개선합니다.
- Flow Matching: 노이즈로부터 이미지 생성으로 이어지는 확률 경로를 모델링하는 기법으로, 논문에서는 이를 활용하여 이미지 생성의 훈련 목표를 정의합니다.
- Implicit Latent Space: 인코더와 디코더 사이의 병목 구간에서 계산되는 저차원의 표현 공간으로, 명시적인 사전 정의 없이 생성 과정 중 데이터 기반으로 최적화됩니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 "무엇이 시각적 생성에 유용한 표현인가?"라는 근본적인 질문에서 출발하여, 기존 생성 모델의 표현 학습 방식에 대한 한계를 지적합니다. 저자들은 시각적 표현이 주로 이해(Understanding) 과업에 최적화되어 있어, 픽셀 합성이라는 생성 과업에는 반드시 효과적이지 않다는 점을 발견했습니다. 기존 연구들은 외부의 강력한 표현을 정렬(Alignment)하거나, 복잡한 픽셀 전용 디코더를 추가하는 방식을 사용했으나, 이는 계산 복잡도를 증가시키고 표현이 생성 과정에서 충분히 활용되지 못하는 문제를 야기했습니다 [Figure 2]. 따라서 본 논문은 픽셀 기반 트랜스포머의 구조적 단순성을 유지하면서도, 생성을 위해 표현이 적절하게 형성되고 활발히 이용될 수 있는 새로운 메커니즘의 필요성을 정의합니다.
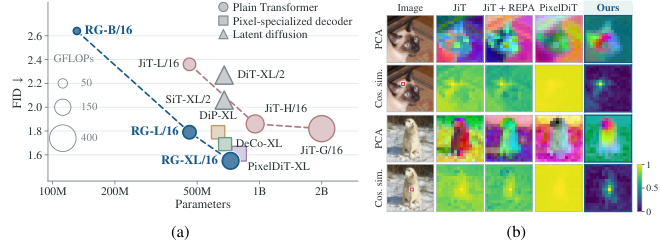
Figure 2 — RG의 효율성 및 내부 표현 분석
3. Method & Key Results (제안 방법론 및 핵심 결과)
제안하는 Representation Guidance (RG)는 평이한(plain) 트랜스포머 구조를 유지하며, 크게 두 가지 핵심 요소를 갖습니다. 첫째, 인코더와 디코더 사이에 저차원 병목 구조를 도입하여 정보의 압축을 유도하고, 이를 통해 생성에 필수적인 정보가 내부 표현에 집중되도록 합니다. 둘째, 생성 타겟 가이드를 통해 인코더가 훈련 과정에서 생성 과업에 더 유용한 정보를 스스로 학습하도록 강제합니다. 구체적으로, 디코더의 표현 기반 예측과 비표현 기반 예측 사이의 속도 오프셋을 활용하여 흐름 매칭(flow matching)의 학습 목표를 보정합니다 [Figure 6].
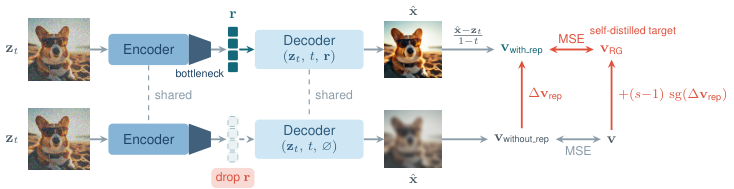
Figure 6 — RG 학습 파이프라인
실험 결과, RG-XL/16은 ImageNet 256x256 해상도에서 FID 1.55를 기록하며, 기존의 복잡한 픽셀 전용 디코더를 가진 모델들보다 우수한 성능을 보였습니다 [Table 2]. 특히 RG-L/16은 단 459M의 파라미터로 훨씬 큰 규모의 베이스라인 모델들을 압도하는 효율성을 입증했습니다. 또한 512x512 해상도에서도 FID 1.74를 달성하여 고해상도 생성 능력을 확인했으며, 텍스트-이미지 생성 벤치마크인 GenEval에서 0.89, DPG-Bench에서 87.1의 점수를 기록하며 최신 대규모 모델들과 대등하거나 더 나은 성능을 보였습니다 [Table 3, Table 4].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 시각적 생성 모델에서 효과적인 표현 학습이 복잡한 디코더 설계보다 표현의 형성 및 활용 방식에 달려 있음을 입증했습니다. 제안된 Representation Guidance는 평이한 트랜스포머 구조로도 고성능 생성을 가능하게 함으로써, 시각적 생성 아키텍처의 단순화와 효율적 확장에 새로운 방향을 제시합니다. 이러한 성과는 향후 대규모 생성 모델 설계에 있어 계산 효율성과 성능 간의 trade-off를 최적화하는 데 중요한 학술적 근거가 될 것입니다.
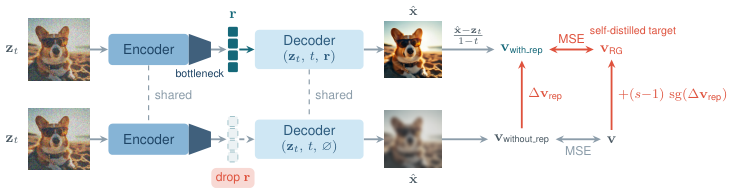
Figure 3 — 아키텍처 비교: JiT vs RG
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] AURORA-LM: Autoencoding Unified Representation for Continuous-Latent Diffusion Language Modeling
- [논문리뷰] Just-in-Time: Training-Free Spatial Acceleration for Diffusion Transformers
- [논문리뷰] CFG-Ctrl: Control-Based Classifier-Free Diffusion Guidance
- [논문리뷰] In Pursuit of Pixel Supervision for Visual Pre-training
- [논문리뷰] DiG-Flow: Discrepancy-Guided Flow Matching for Robust VLA Models
Review 의 다른글
- 이전글 [논문리뷰] Judging in Latent Space: Efficient Generative Reward Modeling via Semantics-Preserving Compression
- 현재글 : [논문리뷰] Learning Representations to Guide Pixel Diffusion Transformers
- 다음글 [논문리뷰] Less from More: Reinforcing Sparse Video Reasoning from Dense References
댓글