[논문리뷰] MixTok: Adaptive Visual Tokenization with Global 1D Tokens and Sparse 2D Refinement
링크: 논문 PDF로 바로 열기
메타데이터
저자: Chenge Li, Yefei He, Xinyu Liu, Feng Chen, Hong Zhou, Bohan Zhuang
1. Key Terms & Definitions (핵심 용어 및 정의)
- 1D Tokenizer: 이미지를 고정된 길이의 컴팩트한 시퀀스로 변환하는 방식이며, 전역적인 정보 압축에는 유리하나 국소적 세부 묘사가 부족할 수 있음.
- 2D Tokenizer: 이미지를 공간적 그리드(Grid) 형태의 토큰으로 변환하며, 국소적 세부 정보를 보존하는 데 뛰어나지만 토큰 오버헤드(Overhead)가 큼.
- Content-Adaptive Router: 이미지의 시각적 복잡도에 따라 refinement가 필요한 영역을 식별하고, 토큰 예산(Token Budget)에 맞춰 2D 토큰 할당량을 결정하는 구성 요소.
- Top-p Selection: 누적 확률 질량(Cumulative probability mass)을 기반으로 필요한 토큰 수를 동적으로 선택하여 효율적인 budget control을 수행하는 기법.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 효율적인 시각적 토큰화(Visual Tokenization)를 위해 컴팩트한 표현력과 세부적인 국소 정보 보존 사이의 균형을 맞추는 문제를 해결하고자 한다. 기존의 2D 토큰화는 모든 공간에 균일한 토큰을 할당하여 비효율적인 자원 낭비를 초래하며, 1D 토큰화는 전역적인 압축에는 효과적이나 미세한 로컬 디테일을 복원하는 데 한계가 있다 [Figure 1]. 또한 기존 기법들은 이미지의 복잡도와 무관하게 고정된 토큰 수를 할당하는 경우가 많아, 단순한 이미지에는 과도한 토큰을, 복잡한 이미지에는 부족한 토큰을 배정하는 비효율이 발생한다. 따라서 저자들은 이러한 한계를 극복하기 위해 이미지 콘텐츠에 적응적으로 대응하는 하이브리드 토큰화 모델인 MixTok을 제안한다.
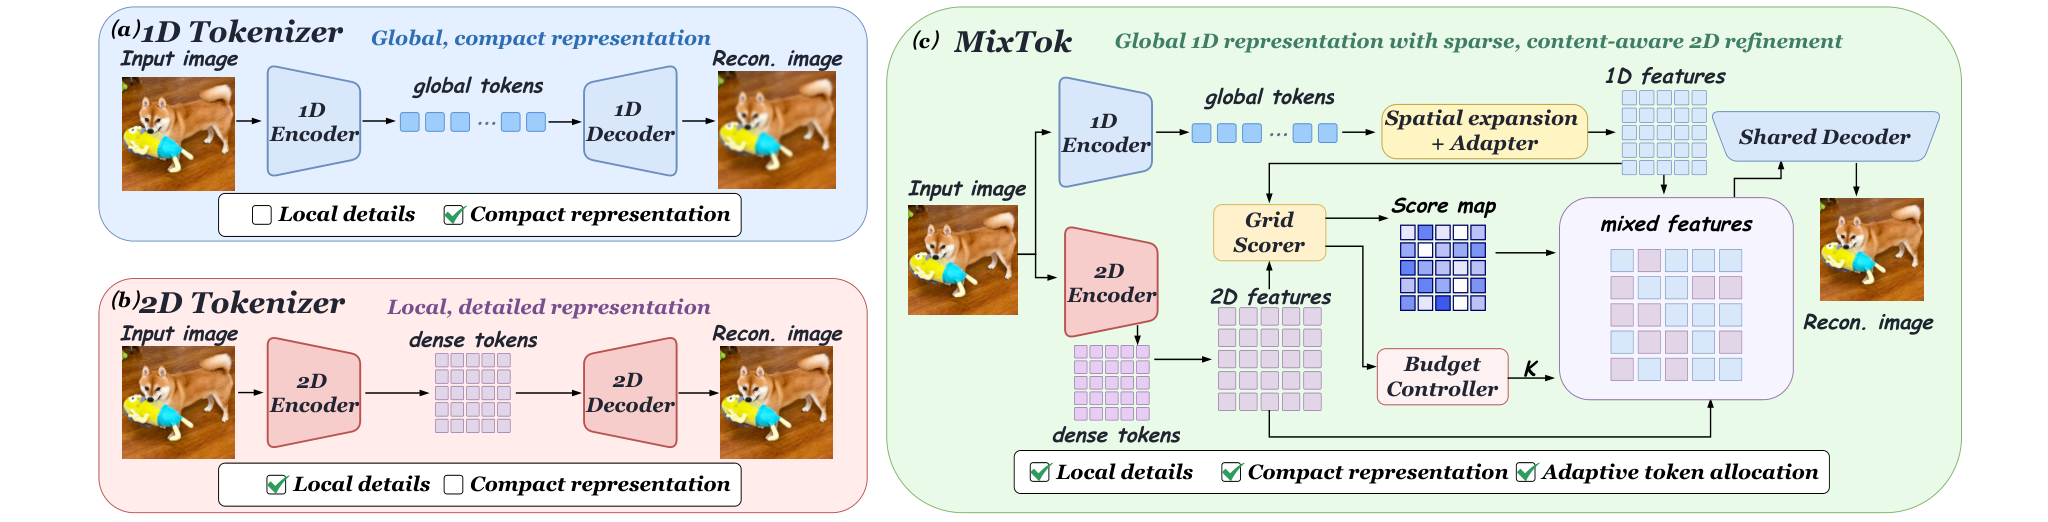
Figure 1 — 기존 토큰화 방식과 MixTok 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 1D 기반의 전역 표현과 선별된 2D 토큰을 결합하여 정보 효율성을 극대화하는 MixTok을 제안한다 [Figure 2]. 제안하는 모델은 Content-Adaptive Router를 통해 refinement 우선순위가 높은 영역을 랭킹하고, Top-p 전략을 통해 이미지별 토큰 예산을 동적으로 할당한다. 1D 토큰을 통해 기본 feature grid를 생성한 뒤, Router가 식별한 핵심 위치에만 2D 토큰 feature를 배치(Replacement)하여 정보의 밀도를 조절한다. 하위 생성 단계에서는 MaskGIT 파이프라인을 확장하여 2D 토큰을 선택적으로 생성하고, 최종적으로 공유 디코더(Shared decoder)를 통해 고품질 이미지를 복원한다. 실험 결과, MixTok은 ImageNet 256×256 환경에서 약 128개의 콘텐츠 토큰 평균 예산으로 rFID 1.195의 우수한 복원 성능을 달성하였다 [Table 1]. 생성 성능 면에서도 기존 TiTok-S-128 대비 gFID를 2.00에서 1.95로 개선하면서도, Latency를 대폭 단축하여 계산 효율성 측면에서 강력한 비교 우위를 입증하였다 [Table 3].
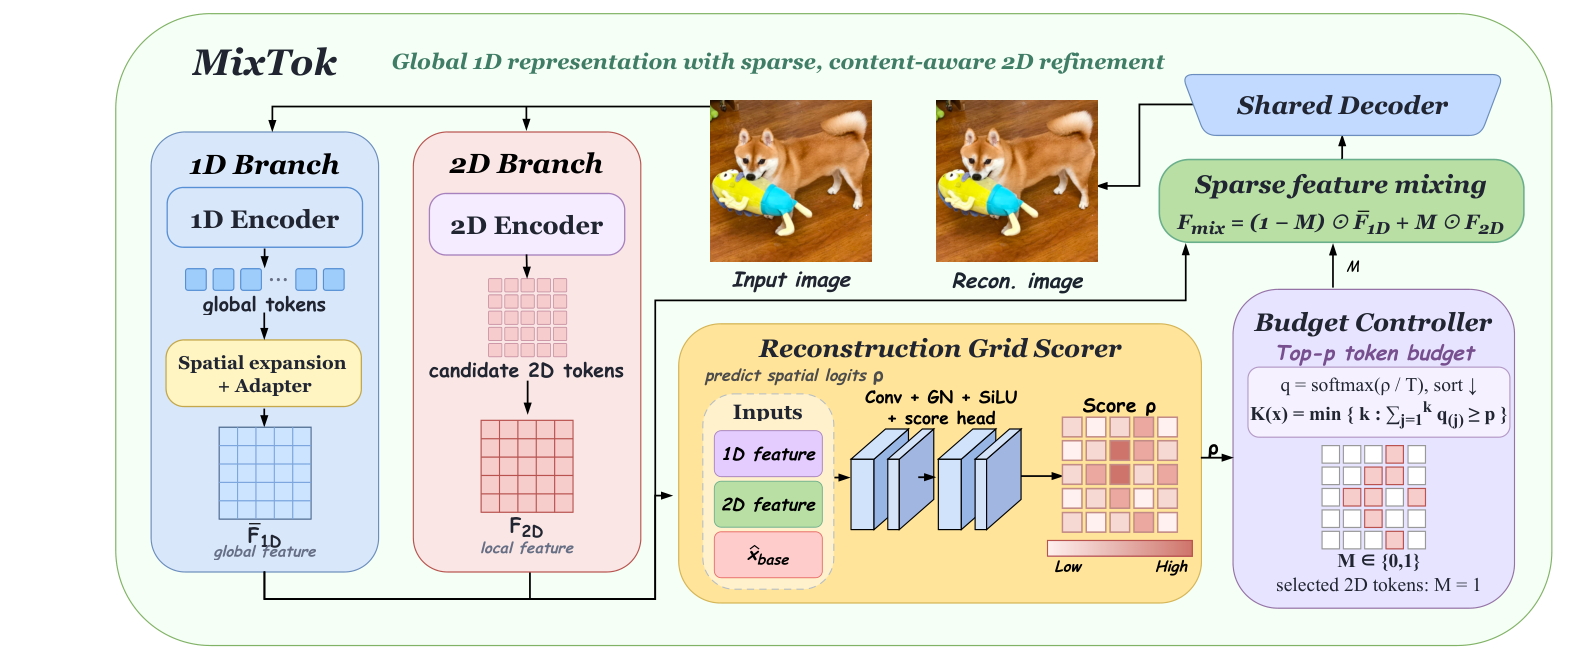
Figure 2 — MixTok 전체 아키텍처
4. Conclusion & Impact (결론 및 시사점)
본 논문은 전역적인 1D 표현과 국소적인 2D refinement를 결합한 하이브리드 토큰화 프레임워크인 MixTok을 성공적으로 제시하였다. 콘텐츠 적응형 토큰 할당 메커니즘을 도입함으로써 토큰 예산을 효율적으로 운용함과 동시에 시각적 품질을 개선하였다는 점이 학계 및 산업계에서 큰 의의를 갖는다. 본 연구는 대규모 생성 모델에서 표현의 컴팩트함과 고해상도 디테일 유지라는 상충되는 목표를 동시에 달성하는 새로운 방향성을 제시하였으며, 향후 고해상도 이미지 데이터로의 확장성과 sparse 연산 최적화에 기여할 것으로 기대된다.
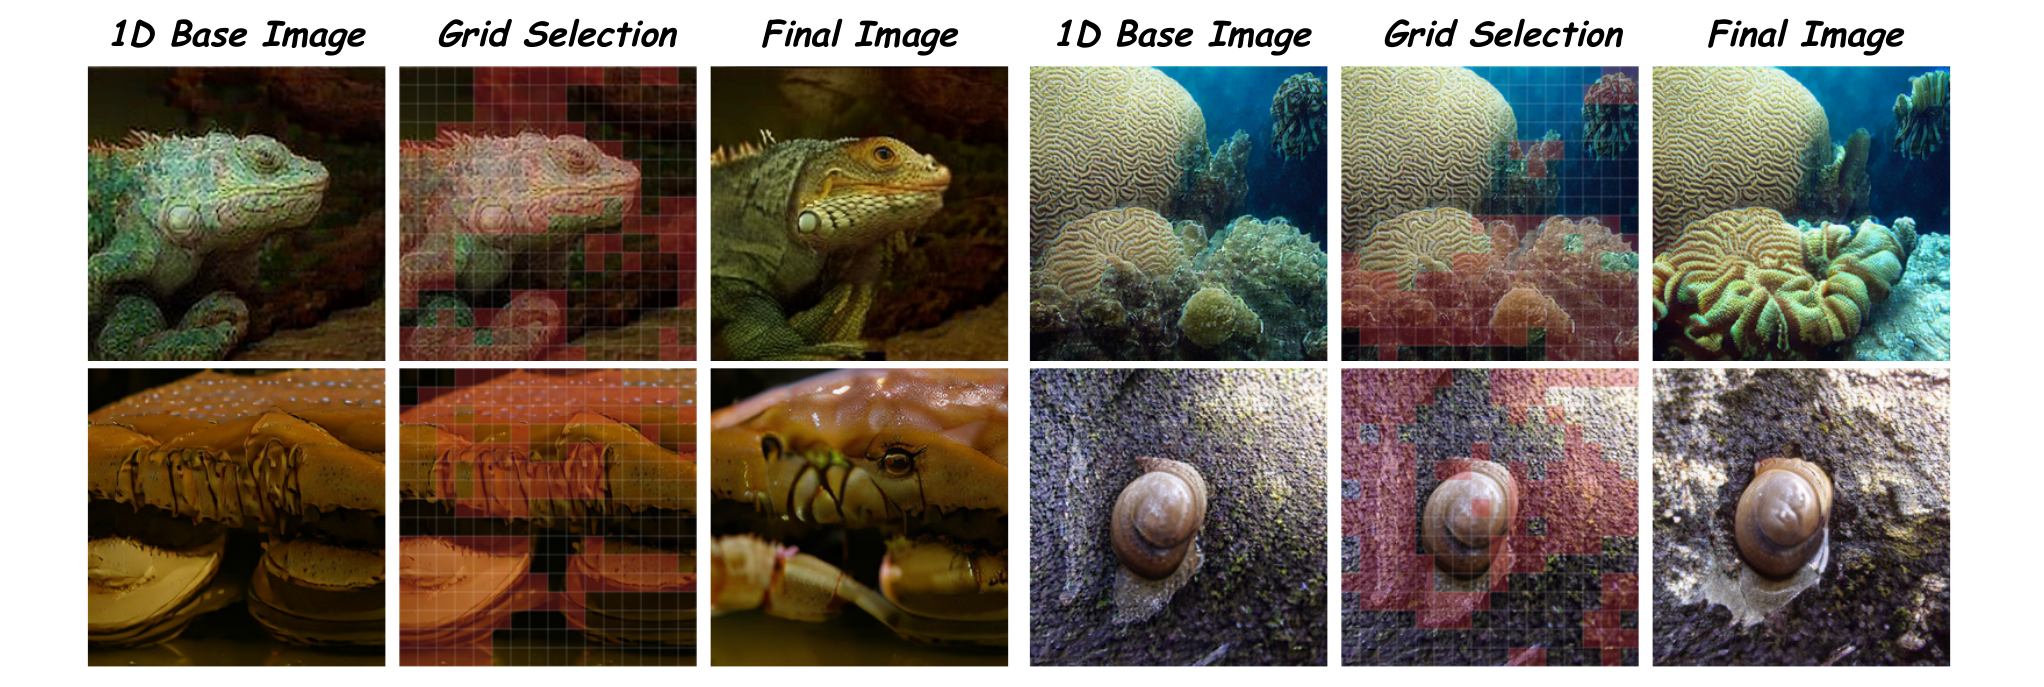
Figure 3 — 2단계 마스크 기반 생성 과정
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Heptapod: Language Modeling on Visual Signals
- [논문리뷰] Next Visual Granularity Generation
- [논문리뷰] Intern Lumina U2: A Multi-Codebook Diffusion Large Language Model for Omni-Visual Understanding and Image Generation
- [논문리뷰] APEX: Asynchronous Prefix Denoising for Extreme Compression
- [논문리뷰] QuadTok: Quadtree Visual Tokenizer for Autoregressive Image Generation
Review 의 다른글
- 이전글 [논문리뷰] MetaKernelBench: Measuring GPU Kernel Knowledge Transfer Beyond Code
- 현재글 : [논문리뷰] MixTok: Adaptive Visual Tokenization with Global 1D Tokens and Sparse 2D Refinement
- 다음글 [논문리뷰] One Model to Loop Them All: Elastic Latent Recurrence for Language Models
댓글