[논문리뷰] PolyOCR-Venus: Unified OCR Foundation Models for Text-Centric Visual Intelligence
링크: 논문 PDF로 바로 열기
메타데이터
저자: GuangJian Team, Kaili Huang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- PolyOCR: 다양한 규모(2B, 9B 등)의 파라미터를 갖춘 통합형 OCR Foundation Model 시리즈로, 텍스트 인식, 위치 파악, 문서 파싱, 정보 추출, 추론 등 복합적인 OCR 작업을 단일 프레임워크에서 수행합니다.
- Competence-Guided Policy Optimization (CGPO): 교사 모델의 신뢰도와 교사-학생 간 역량 격차(Competence Gap)를 기반으로 샘플 단위의 라우팅을 수행하여, Policy Optimization과 On-policy Distillation을 동적으로 결합한 학습 전략입니다.
- OCRBench v2.1: 기존 OCRBench v2를 개선하여, 수동으로 검증된 주석 수정과 작업 정렬(Task-aligned) 스코어링 메트릭을 도입한 통합 평가 프로토콜입니다.
- Data Engine: 이질적인 시각 데이터를 고품질의 OCR Supervision으로 변환하기 위한 대규모 데이터 구축 프레임워크로, 합성 데이터 생성 및 모델 기반 주석(Model-assisted annotation)을 포함합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 파편화된 기존 OCR 시스템의 한계를 극복하고, 복잡한 시각 환경에서 텍스트 인식, 파싱, 추론 능력을 모두 갖춘 통합형 모델을 구축하고자 합니다 [Figure 1]. 기존 OCR 시스템은 특정 도메인(예: 장면 텍스트, 표 파싱)에 특화되어 지식 전이가 어렵거나, 일반적인 MLLM은 암묵적인 학습으로 인해 정밀한 텍스트 인식 및 구조적 이해 능력이 부족하다는 문제가 있습니다. 또한, OCR 작업은 요구되는 시각적 복잡도와 출력 형식이 매우 이질적이어서, 고정된 학습 전략으로는 특정 작업이 지배적이거나 성능이 불균형해지는 현상이 발생합니다. 따라서 본 논문은 이러한 복잡한 다중 작업 학습 환경에서 균형 잡힌 역량을 확보하기 위한 새로운 학습 전략을 제안합니다.
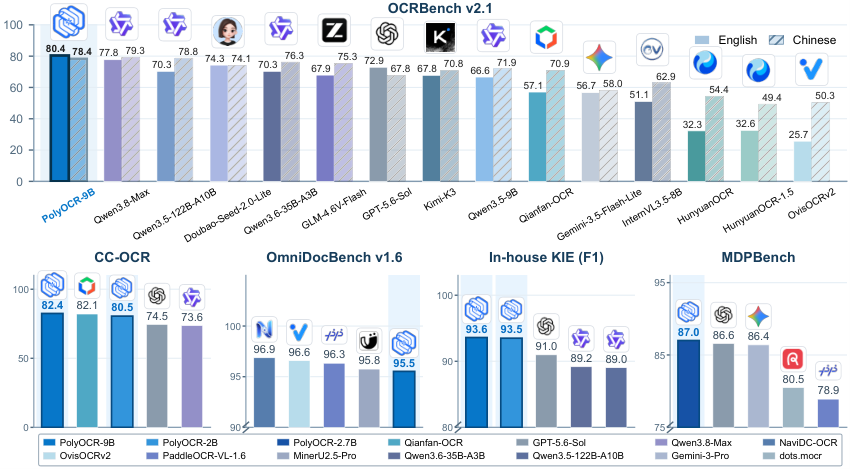
Figure 1 — 벤치마크별 성능 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Qwen3.5를 기반으로 텍스트 인식부터 추론까지 통합하는 PolyOCR 프레임워크를 제안합니다 [Figure 2]. 저자들은 Data Engine을 통해 이질적인 시각 데이터를 고품질의 다중 작업 감독 신호로 변환하며, 특히 부족한 데이터 영역을 보완하기 위해 합성 및 모델 보조 생성 파이프라인을 구축하였습니다 [Figure 3]. 핵심 학습 방법론인 CGPO는 교사 모델의 신뢰도와 학생 모델의 학습 상태를 정량화하여 샘플 단위로 학습 신호를 조정함으로써, 기존의 Group Relative Policy Optimization (GRPO)와 On-policy Distillation이 가진 효율성 문제를 해결합니다. 실험 결과, PolyOCR은 OCRBench v2.1, CC-OCR, OmniDocBench v1.6 등 다수의 벤치마크에서 State-of-the-art 성능을 기록하거나 기존 베이스라인을 압도하는 경쟁력을 보였습니다. 정량적으로는 다양한 OCR 차원(인식, 위치, 추론 등)에서 고른 성능 향상을 보여주며, 특히 PolyOCR-2.7B와 같은 특화 모델을 통해 다국어 문서 파싱의 견고함을 입증하였습니다.
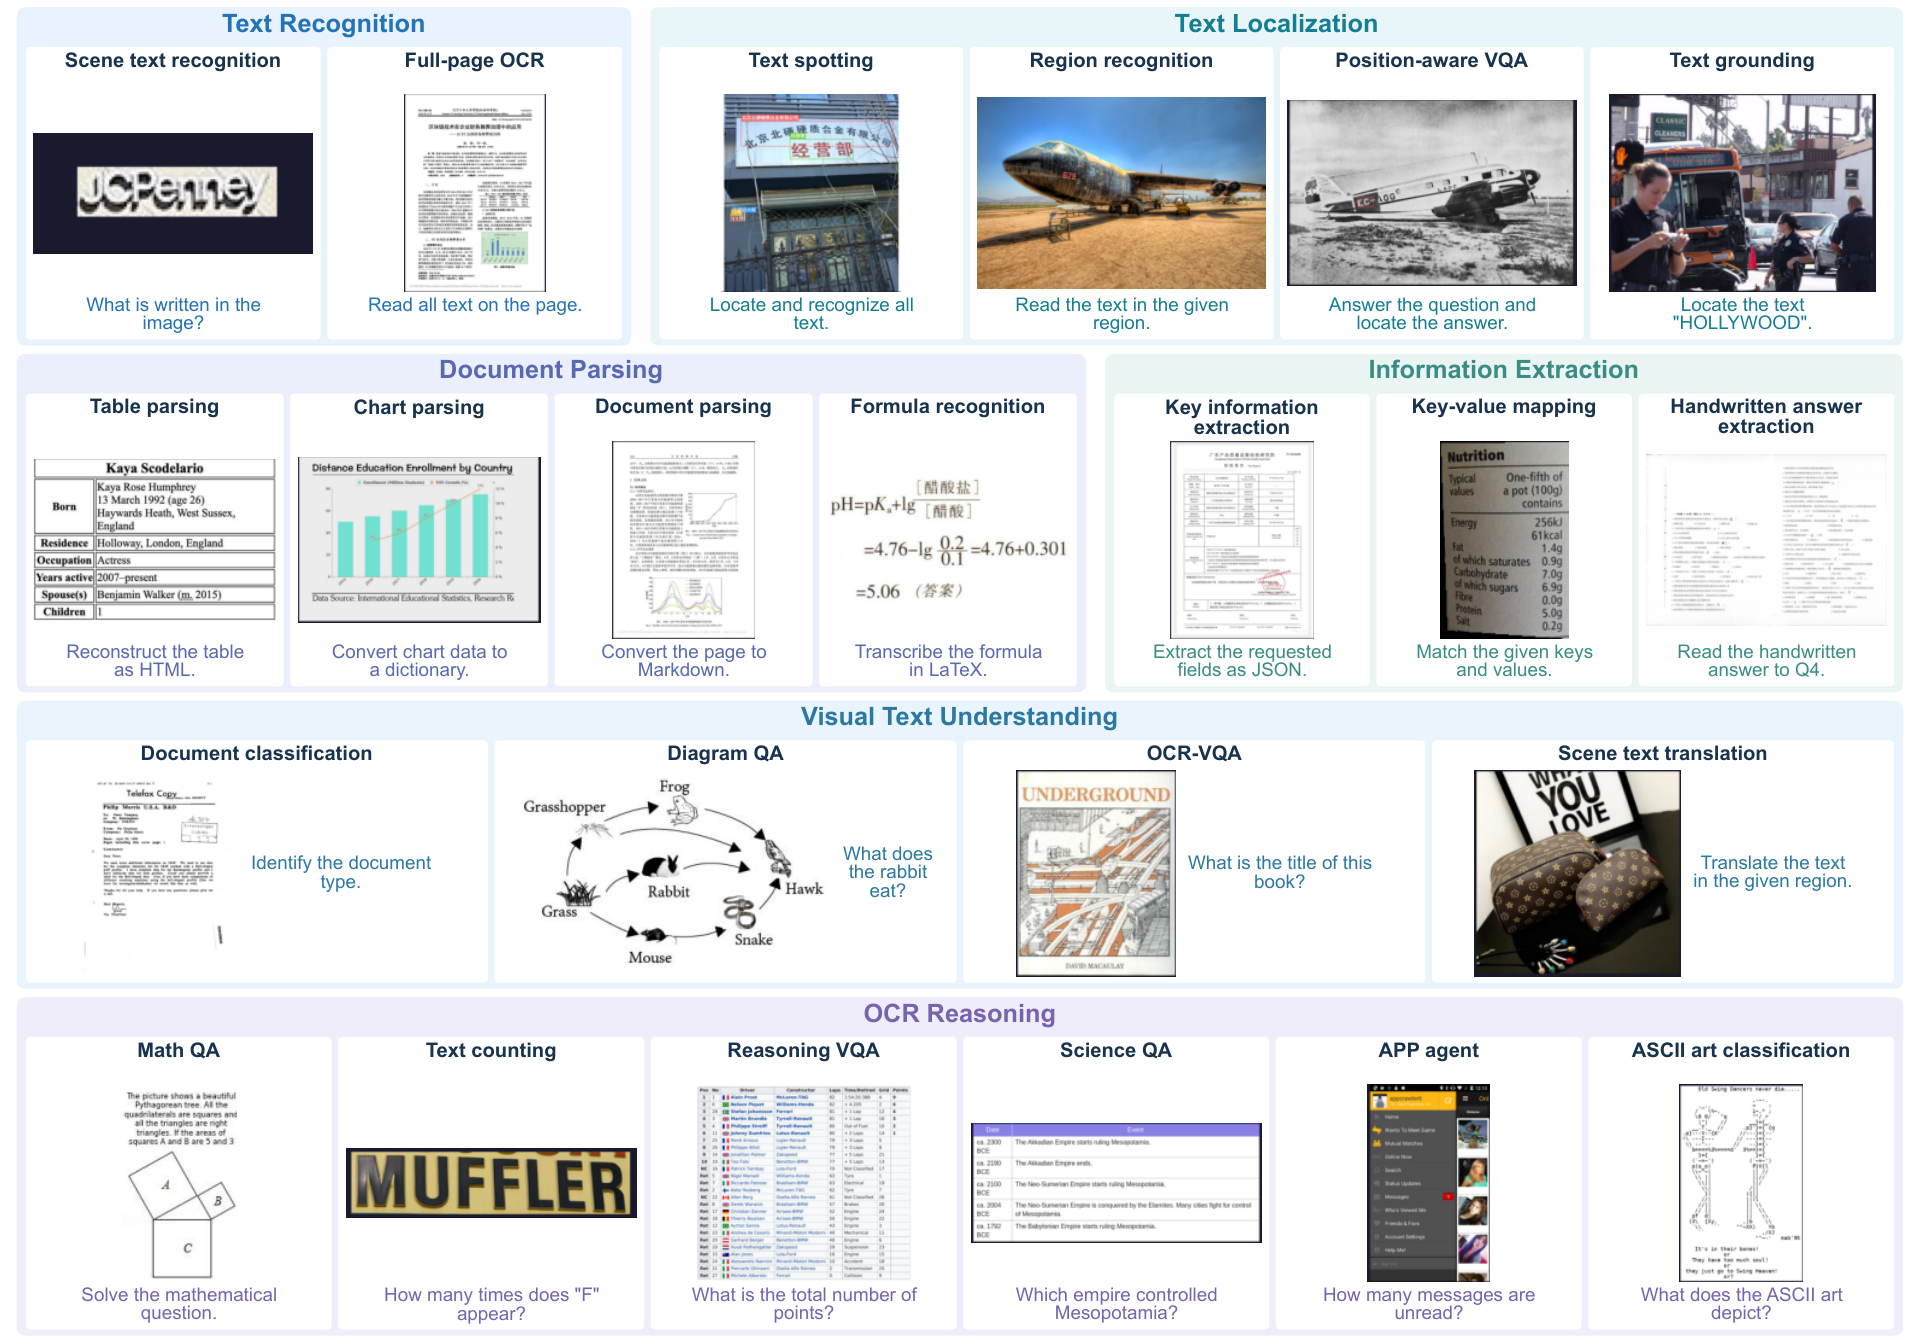
Figure 2 — OCR 작업 영역별 예시
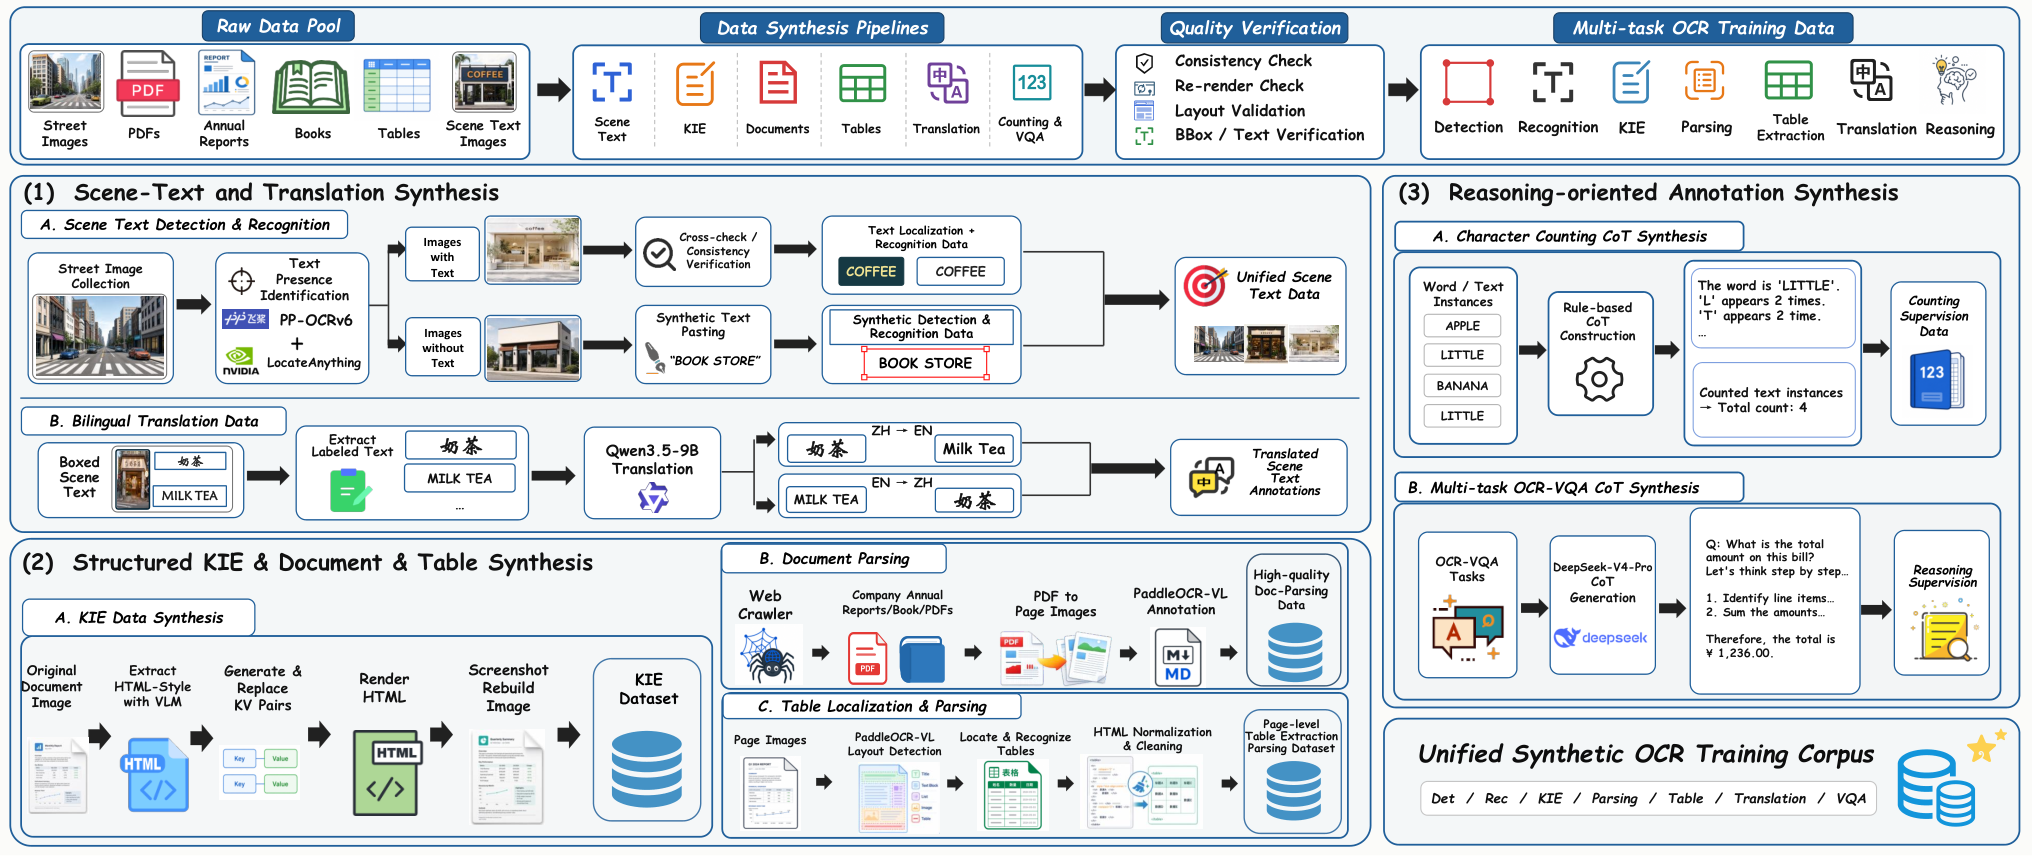
Figure 3 — 데이터 구축 엔진 개요
4. Conclusion & Impact (결론 및 시사점)
본 연구는 텍스트 중심의 시각 지능을 위한 통합형 OCR Foundation Model인 PolyOCR을 통해 OCR 모델링의 새로운 패러다임을 제시합니다. 제안된 CGPO 학습 프레임워크는 대규모 언어 모델과 시각 모델 간의 역량 격차를 효과적으로 해소하며, 균형 잡힌 다중 작업 학습을 가능케 합니다. 이 연구는 향후 OCR 기술이 단순 전사를 넘어 고도화된 문서 이해와 추론이 필요한 산업 분야 전반으로 확산되는 데 중요한 기여를 할 것으로 기대됩니다. 또한 공개된 벤치마크인 OCRBench v2.1은 향후 OCR 관련 연구의 표준적인 평가 지표로 활용될 잠재력이 큽니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] OceanPile: A Large-Scale Multimodal Ocean Corpus for Foundation Models
- [논문리뷰] STEP3-VL-10B Technical Report
- [논문리뷰] MAPO: Mixed Advantage Policy Optimization
- [논문리뷰] Describe What You See with Multimodal Large Language Models to Enhance Video Recommendations
- [논문리뷰] Towards Agentic Robots: Model, Data, Environment, and Harness
Review 의 다른글
- 이전글 [논문리뷰] One Model to Loop Them All: Elastic Latent Recurrence for Language Models
- 현재글 : [논문리뷰] PolyOCR-Venus: Unified OCR Foundation Models for Text-Centric Visual Intelligence
- 다음글 [논문리뷰] PreSTO: Predictive Subtree Prefetching for Fast LLM Power Sampling
댓글