[논문리뷰] OvisOCR3 Technical Report
링크: 논문 PDF로 바로 열기
저자: Yu Xia, Yinglun Li, Yuhui Chen, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- OvisOCR3: 0.8B 규모의 단일 모델로, 문서 파싱, 일반 OCR, 핵심 정보 추출(KIE), 문서 Figure 캡셔닝, 그리고 Cross-Page Table Reconstruction을 포함하는 광범위한 OCR 관련 태스크들을 통합합니다.
- Document Parsing: 페이지의 내용, 레이아웃 및 읽기 순서를 이미지로부터 복구하는 태스크입니다. Structured Document Parsing, Document Layout Detection, Markdown Document Parsing을 포함합니다.
- General OCR: 텍스트 인식 및 로컬라이제이션, 구조화된 콘텐츠 추출, 번역, 시각적 이해 등 10가지 세부 태스크를 아우르는 OCR 기능입니다.
- Key Information Extraction (KIE): 입력 이미지에서 핵심 정보를 추출하여 구조화된 레코드로 구성하는 태스크입니다. Open Extraction, Specified-Field Extraction, Schema-Based Extraction의 세 가지 모드를 지원합니다.
- Cross-Page Table Reconstruction: 연속된 페이지에 걸쳐 분산된 테이블 조각들로부터 완전한 테이블을 복구하는 태스크로, Continuation Detection 및 셀 내용과 구조의 재구성을 요구합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
기존 Optical Character Recognition (OCR) 기술은 이미지 내 텍스트를 기계 판독 가능한 콘텐츠로 변환하는 것이 주 목표였으나, 실제 애플리케이션에서는 전체 페이지 구조 이해, 콘텐츠에 대한 질의응답, 특정 스키마에 따른 필드 추출 등 복합적인 요구사항이 증가하고 있습니다. OvisOCR2와 같은 이전 연구는 0.8B의 컴팩트한 End-to-End 모델로 선도적인 Document Parsing 성능을 달성했음에도 불구하고, 이를 페이지 파싱을 넘어 다양한 OCR 태스크로 확장하는 것은 단순한 태스크 추가 이상의 복잡성을 가졌습니다. 특히, 각기 다른 OCR 태스크는 응답 길이와 정확한 출력 형태에서 큰 차이를 보여, Token-averaged Loss 하에서 균형 잡힌 Supervision을 제공하기 어려웠습니다. 또한, 정확한 텍스트 전사, 정보성이 풍부한 Figure 설명, 그리고 올바른 Cross-Page Table Association은 각각 특화된 Supervision과 Feedback 메커니즘을 필요로 하여, 단일 컴팩트 모델로 광범위한 태스크에서 Specialist 수준의 성능을 달성하는 것이 중요한 문제로 대두되었습니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
OvisOCR3는 Document Parsing, General OCR, Key Information Extraction (KIE), Document Figure Captioning, Cross-Page Table Reconstruction을 0.8B 단일 모델로 통합하는 방법론을 제안합니다. 모델은 Qwen3.5-0.8B를 기반으로 하며, 네 단계의 훈련 과정을 거쳐 개발되었습니다. 첫째, Continued Pretraining을 통해 다섯 개 도메인을 위한 공통 기반을 구축합니다. 둘째, Domain-Balanced Mid-Training에서는 태스크 Mixture를 재조정하고 Token-level 및 Sample-level Loss Normalization을 사용하여 두 Branch를 훈련한 후, Weight를 융합합니다. 셋째, Multi-Teacher On-Policy Distillation (MOPD)을 통해 다섯 개의 도메인별 4B Teacher 모델의 전문 지식을 공유 Student 모델로 통합하며, 이 과정에서는 Top-KK Distillation 방식이 특히 효과적임을 확인했습니다. 마지막으로, Mixed-Task Reinforcement Learning (MixRL)을 통해 도메인별 Reward를 사용하여 모델을 Jointly하게 정제합니다. 특히, Cross-Page Table Reconstruction에서는 두 단계 절차를 사용합니다. 먼저, OvisOCR3는 각 페이지를 독립적으로 Markdown으로 파싱하고 테이블은 HTML로 표현합니다. 그 다음, 동일 모델이 인접한 두 페이지 이미지와 파싱된 표현을 사용하여 Cross-Page Continuation을 식별하고 연속된 테이블을 재구성합니다 [Figure 2]. 두 페이지 이상에 걸친 테이블의 경우, 탐지된 테이블을 포함하는 연속적인 페이지 시퀀스 내에서 Pairwise Reconstruction을 재귀적으로 적용합니다 [Figure 3].
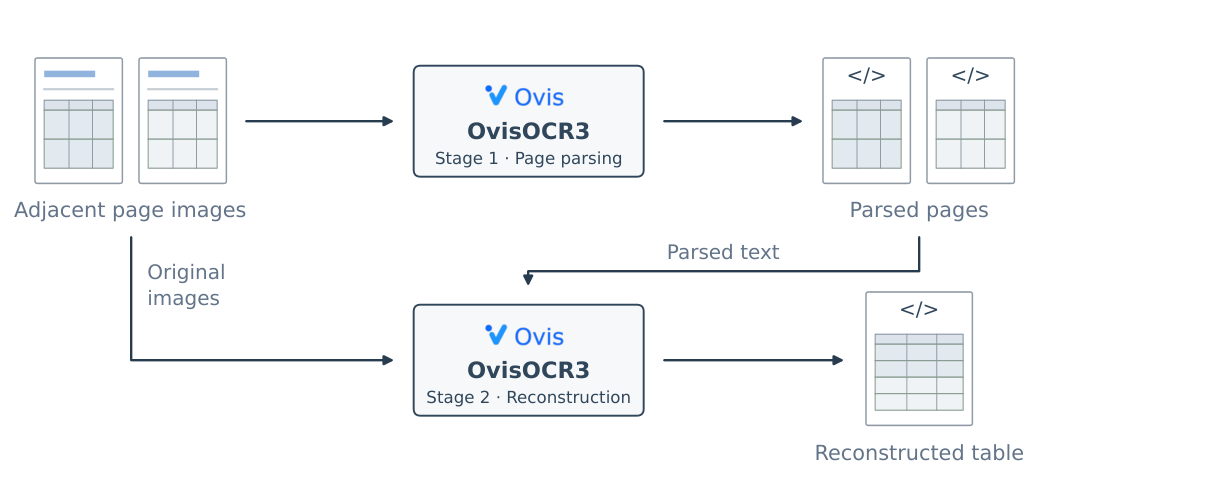
Figure 2 — Cross-Page 테이블 재구성 워크플로우
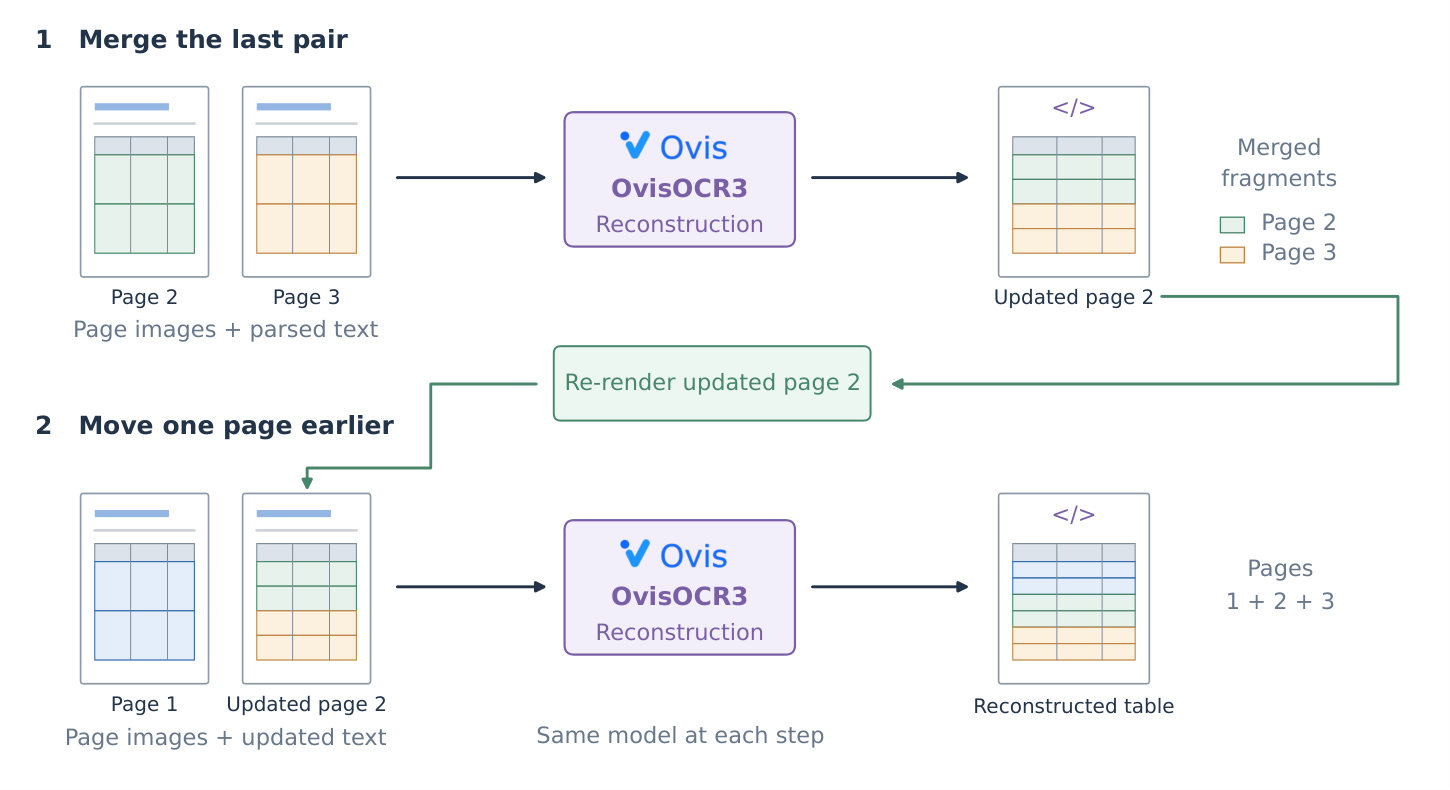
Figure 3 — 3페이지 테이블의 재귀적 재구성
OvisOCR3는 다양한 벤치마크에서 선도적인 결과를 달성했습니다 [Figure 1]. Document Parsing에서 OmniDocBench v1.6에서 96.74의 Overall Score를 기록했으며, PureDocBench, Real5-OmniDocBench, MDPBench에서 가장 높은 Overall Score를 달성하여 Table Parsing 및 이미지 Degradation에 대한 Robustness를 입증했습니다. 특히, PureDocBench에서는 OvisOCR2 대비 Clean-to-Real 성능 하락이 7.84 포인트로 크게 개선되어, 물리적 재촬영에 대한 Robustness가 향상되었습니다. General OCR 태스크에서는 OCRBench와 OCRBench v2의 영어 및 중국어 Split에서 모두 1위를 차지했으며, OCRBench v2 영어 Split에서 Qwen3.5-4B보다 11.8 포인트 높은 65.9점을 달성하며 파라미터 수 대비 뛰어난 효율성을 보였습니다. KIE에서는 OCRBench, OCRBench v2, CC-OCR, In-house KIE Bench의 네 가지 벤치마크에서 모두 1위를 기록했습니다. DocFigCapBench에서는 90.97의 최고 Localization F1을 달성했으며, Caption Score는 Qwen3.8-Max에 근접하는 6.93을 기록했습니다. Cross-Page Table Reconstruction에서는 CrossTabBench에서 97.07의 Relation F1을 달성하여 Qwen3.8-Max를 2.60 포인트 상회했으며, MPDocBench-Parse에서 92.04의 Truncated-table TEDS로 선두를 지켰습니다. 이 결과들은 0.8B의 컴팩트한 모델이 다양한 OCR 관련 태스크에서 강력한 성능과 광범위한 커버리지를 제공할 수 있음을 보여줍니다.
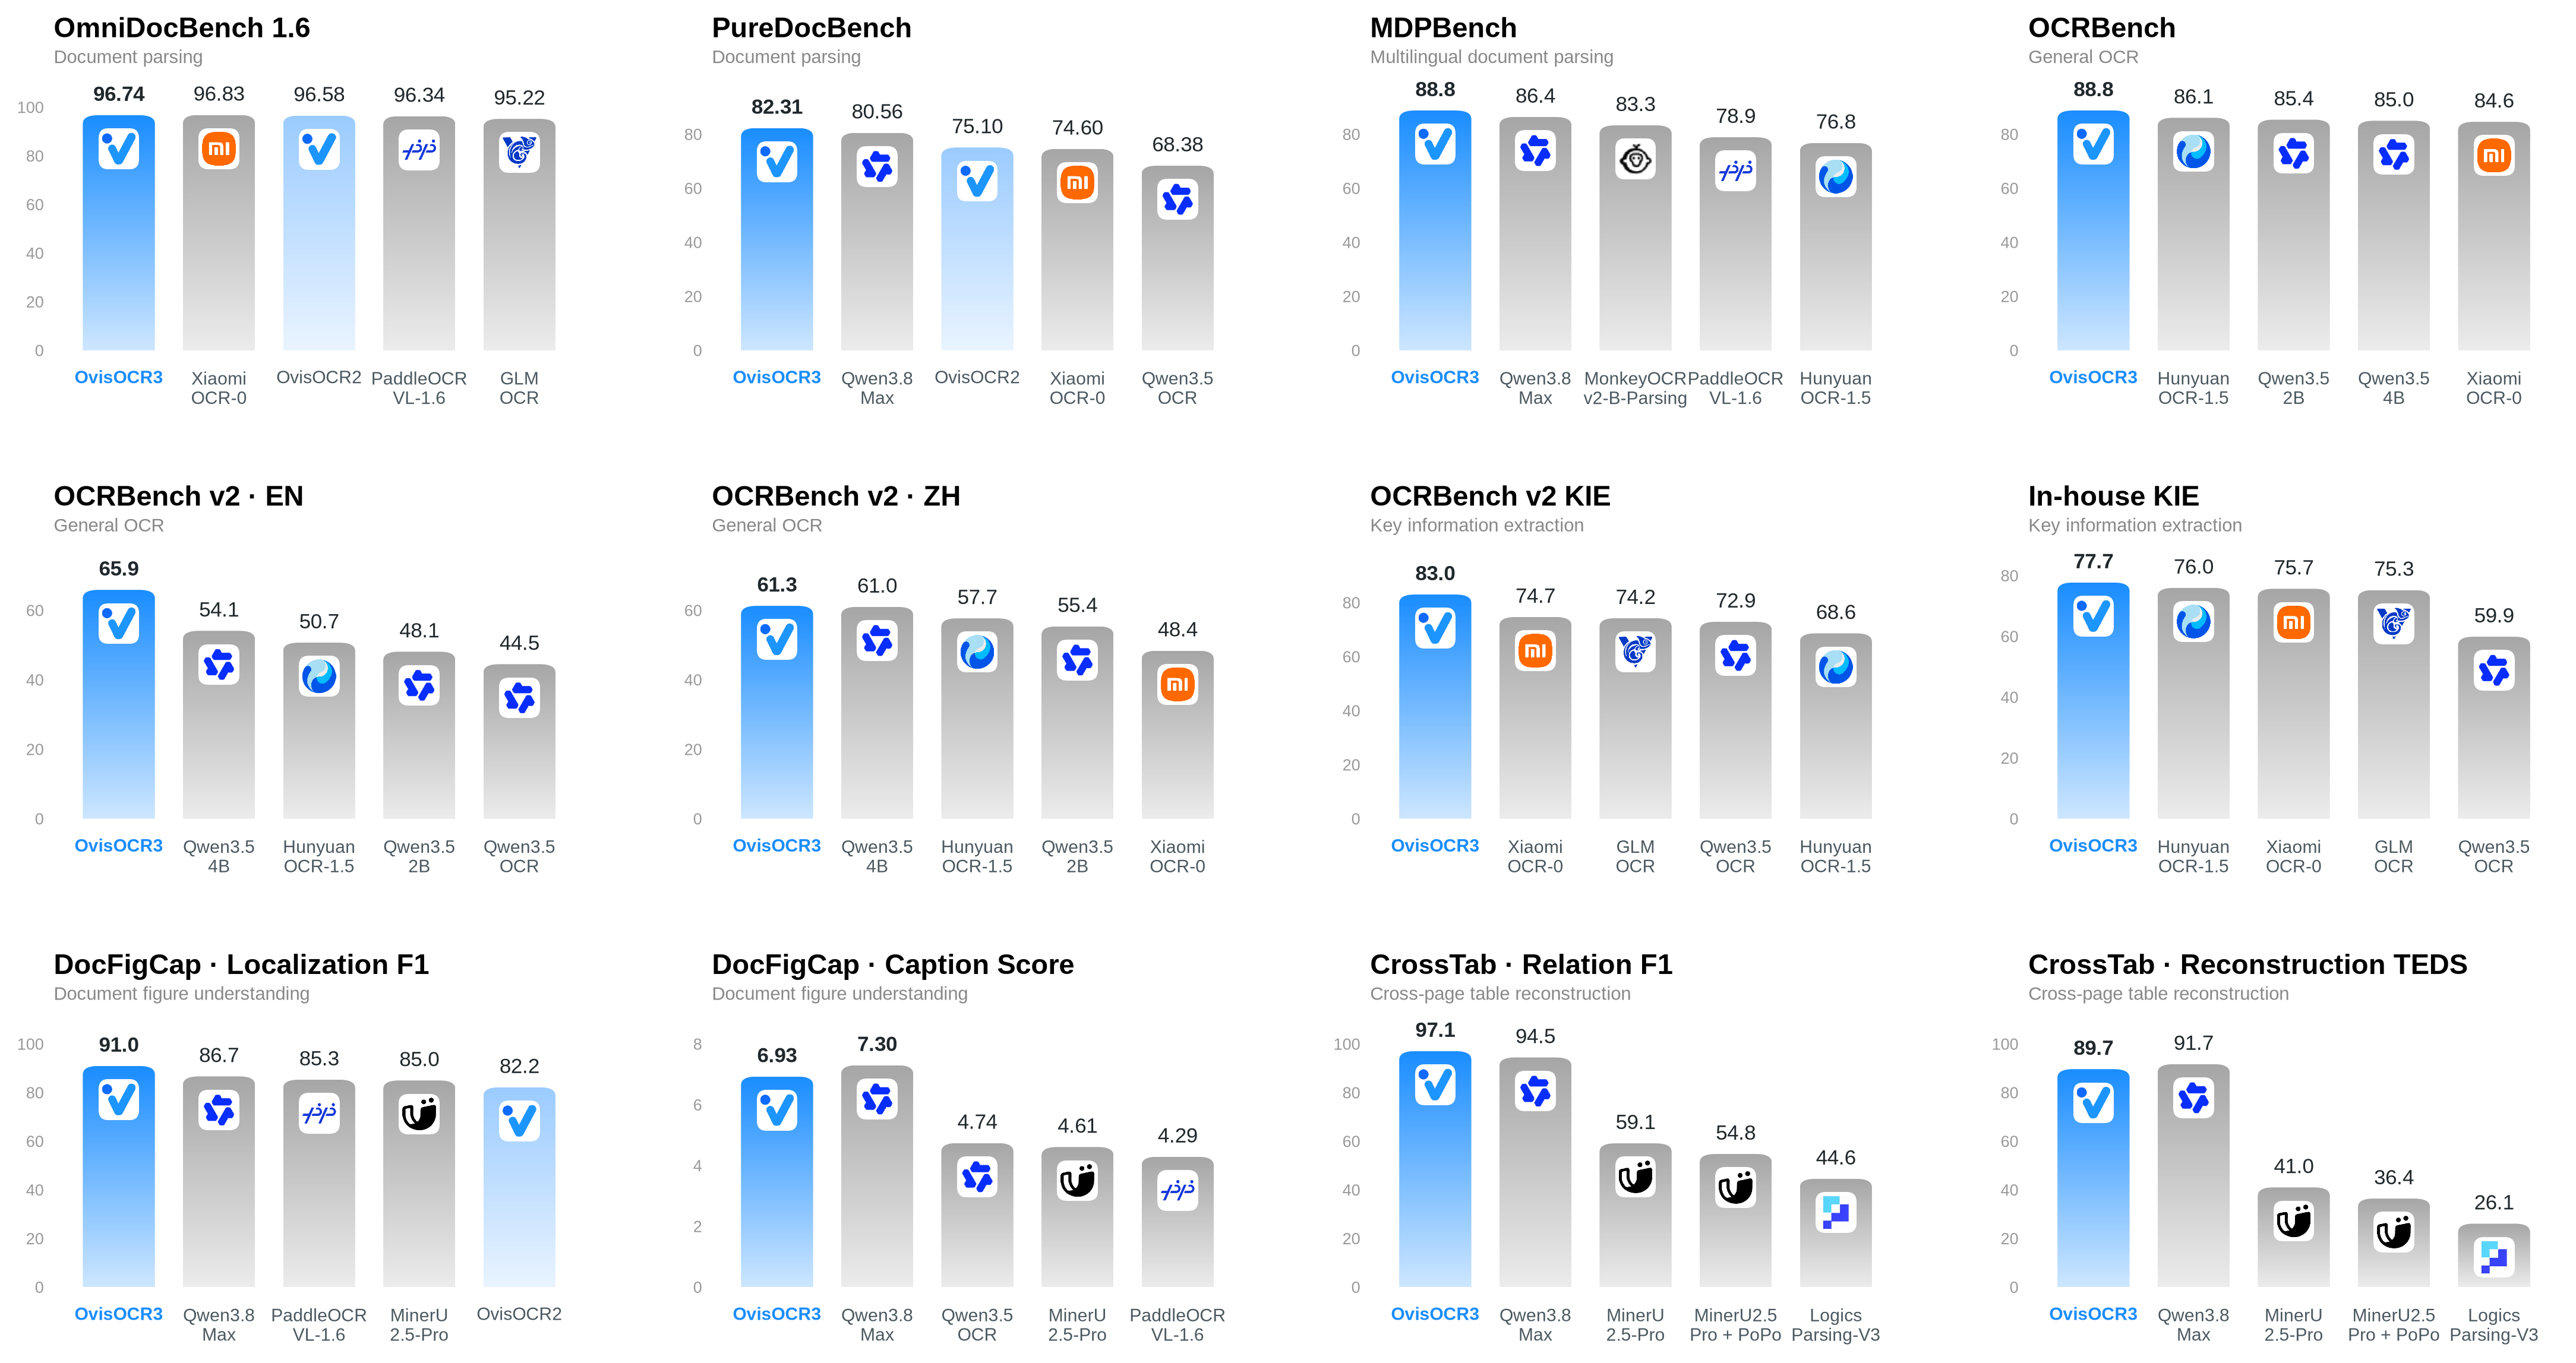
Figure 1 — 벤치마크별 OvisOCR3 성능 개요
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Document Parsing, General OCR, KIE, Document Figure Captioning, Cross-Page Table Reconstruction을 통합한 컴팩트한 0.8B 모델인 OvisOCR3를 소개합니다. OvisOCR3는 Continued Pretraining, Domain-Balanced Mid-Training, Multi-Teacher On-Policy Distillation (MOPD), Mixed-Task Reinforcement Learning (MixRL)을 포함하는 네 단계의 훈련 방식을 통해 실세계 및 합성 데이터로 훈련되었습니다. 공공 및 In-house 벤치마크 평가를 통해 OvisOCR3는 광범위한 OCR 태스크에서 선도적인 결과를 달성했으며, General-purpose Vision-Language 모델과 Specialized OCR 모델 모두를 여러 벤치마크에서 능가했습니다. 이 연구는 컴팩트한 단일 모델이 다양한 OCR 관련 요구사항을 충족시키면서도 Specialist-level 성능을 달성할 수 있음을 입증하며, 향후 Document AI 및 Multimodal 모델 분야의 실용적인 배포와 효율적인 발전에 중요한 시사점을 제공합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] MultiAgent-OPD: End-to-End Training of Hierarchical Multi-Agent Systems with On-Policy Distillation
- [논문리뷰] MMVistaReason: Toward Open-Data and Post-Training Recipes for Multimodal Reasoning
- [논문리뷰] Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
- [논문리뷰] Cowork-Gym: Synthesizing Interactive Work Environments at Scale
- [논문리뷰] Branching On-Policy Distillation
댓글